
 AI智汇具 - AI工具推荐与技能教程_好用的AI工具大全
把任意 AI 客户端变成 AI 科学家——163 个科学技能 + 100+ 数据库,兼容 Cursor / Claude Code / Codex / Antigravity。
MIT License
163 Skills
v2.65.0
全球 19 万+ 科学家在用
Scientific Agent Skills(原 Claude Scientific Skills)是 K-Dense 维护的一套开源「科研技能库」:163 个即用技能 + 100+ 科学数据库,覆盖生物信息、化学 / 药物发现、蛋白质、临床证据、机器学习、材料、地理空间等学科,遵循开放的 Agent Skills 标准,能在 Cursor、Claude Code、Codex、Google Antigravity 等任意兼容客户端里跑。截至 2026-09-09,仓库约 43.9k Star、3.99k Fork,采用 MIT 许可。本文按 README 结构讲清它「是什么、装什么、怎么装、能跑什么、质量怎么保证、许可边界」。
一、它是什么:一套「程序性知识库」而非模型
先厘清一个容易混淆的点:Scientific Agent Skills 不训练、也不提供任何大模型,它装的是「程序性知识」——也就是把科研里反复出现的多步工作流,写成每个 AI 客户端都能读懂、能照做的技能卡片。仓库的自我定位是「Turn any AI agent into an AI Scientist」,作者称已被全球 19 万+ 科学家使用。它兼容 Cursor、Claude Code、Codex、Pi、Google Antigravity 等支持开放 Agent Skills 标准的客户端。
换句话说,模型负责「想」,这些技能负责「知道怎么正确地做」:该调哪个库、该查哪个数据库、参数怎么设、边界在哪里。README 反复强调,agent 自己也能用任意 Python 包或 API,技能只是把常见工作流预先写清楚、验证过、标好出处,让结果更稳、更可溯源。配套论文是 arXiv:2609.00065。
二、仓库里到底有什么
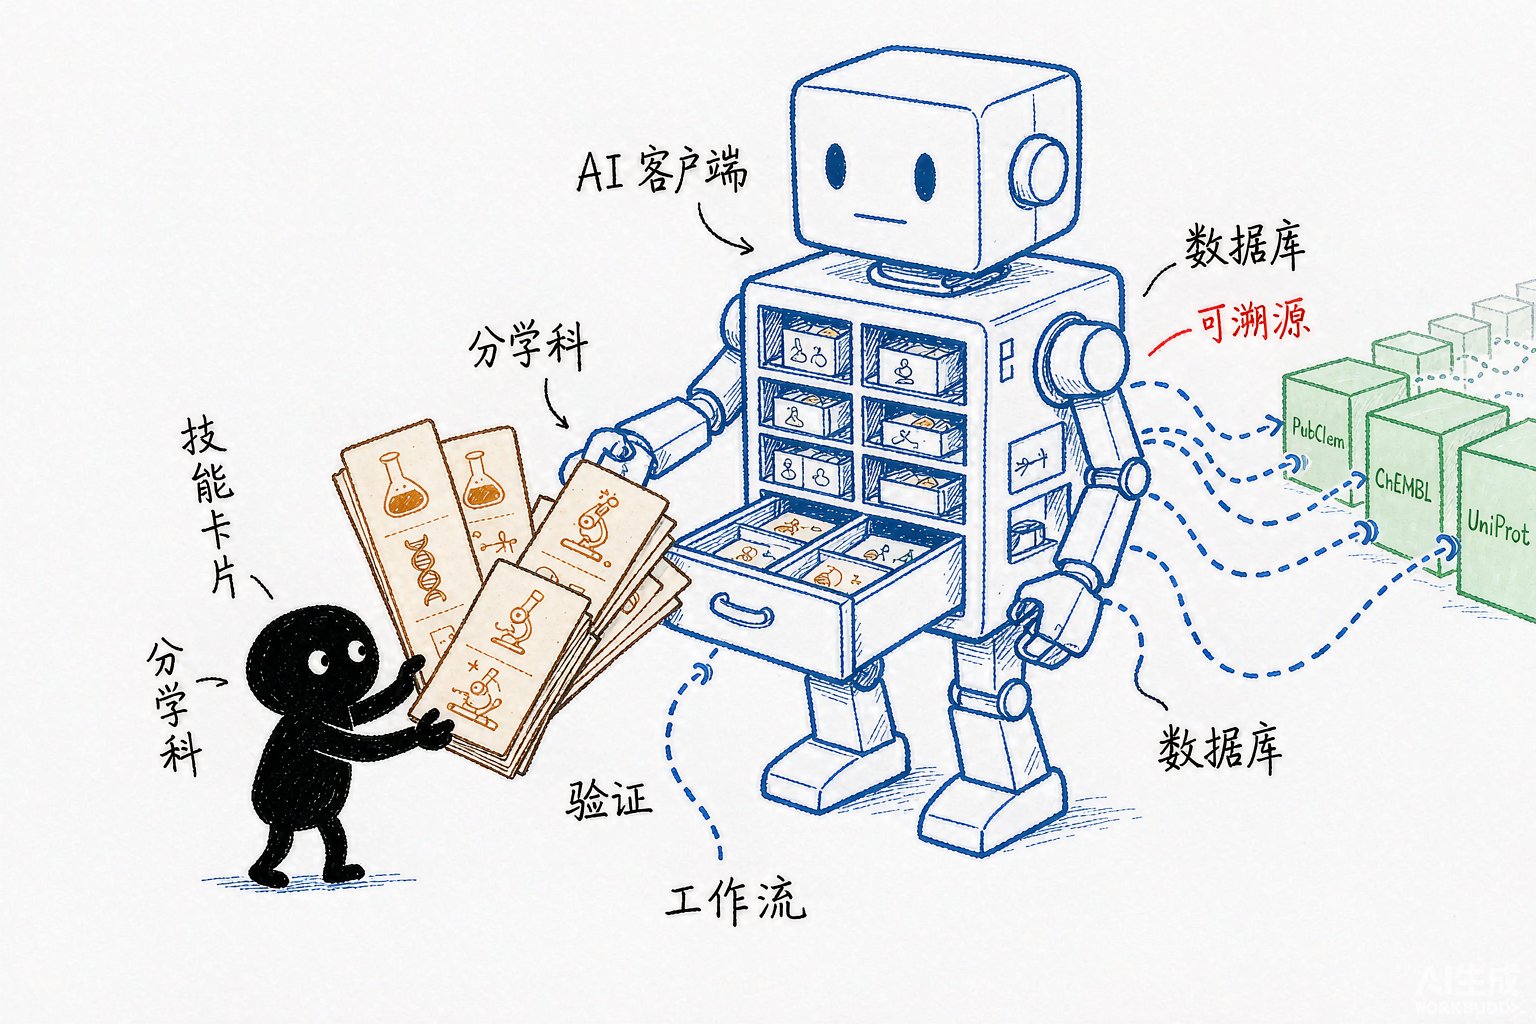
README 把 163 个技能拆成五类:
- 100+ 科学数据库:统一的 database-lookup 技能确定性地访问 78 个公开库(PubChem、ChEMBL、UniProt、COSMIC、ClinicalTrials.gov、USPTO 等),另有 DepMap、OneKGPd、Genomic Intelligence 等专用技能;BioServices(约 40 个生信服务)、BioPython(39 个 NCBI 子库)、gget(20+ 基因组库)进一步扩面。
- 70+ 优化 Python 包技能:RDKit、Scanpy、PyTorch Lightning、scikit-learn、PyTDC、pymatgen、Qiskit、OpenMM / MDAnalysis 等,版本感知、带验证过的示例。
- 9 个科学集成技能:Benchling、DNAnexus、LatchBio、OMERO、Protocols.io、Opentrons 等平台的预文档化路径。
- 30+ 分析与沟通工具:文献综述、可溯源写作、同行评审、Paperclip 全文检索、宏无关 PPTX 海报、Mermaid 图等。
- 10+ 研究与临床工具:证据有界的假说生成、基金写作、PK/PD 建模、ISO 标准就绪证据准备、分析方法验证(ICH / USP / CLSI)等。
每个技能都带 SKILL.md 文档、代码示例、最佳实践与集成指南;凡是带 scripts/ 的技能都配测试套件,CI 会拦截「加了工具却没带测试」的 PR。
(一)一个技能长什么样
技能的本质是带 YAML frontmatter 的 SKILL.md,外加可选的 scripts/、references/ 与测试。仓库更新必须让 metadata.version 保持引号包裹的数字字符串,并通过 skills-ref validate 校验。由于 163 个技能常驻会吃掉大量上下文,README 明确建议「装一个主题子集,而不是整套」。
(二)统一数据库查询:78 个库合一个技能
README 的博客里专门写了一个设计取舍:为什么不做 78 个技能,而用一个 database-lookup 统一承载。结论是合并把「常驻上下文成本」降了 13.9 倍,同时跨五个模型保持了路由准确率。这正好体现了这套库的设计哲学——把重复、易错、占上下文的脏活,固化成一个可验证的技能。
三、如何装上这些技能
安装方式取决于你的客户端,但核心都是把技能放进客户端能扫描到的目录。
(一)三种安装方式
最省事的是标准安装器:
npx skills add K-Dense-AI/scientific-agent-skills如果你用 GitHub CLI(v2.90.0+),可以用 gh skill 交互安装或只装某个技能(如 scanpy),还能用 –pin v2.65.0 钉到发布标签做可复现安装。仓库本身也是一个合法的 Agent Plugins 1.0.0 包(根 plugin.json + skills/),Cursor 用软链、Codex 用 codex plugins install . 即可;其他客户端(OpenClaw、Pi、Hermes 等)可 git clone 到 ~/.agents/skills/ 或项目级 .agents/skills/。
(二)安全免责与自审
README 用一整节讲安全:Agent Skills 能跑任意代码、装包、发网络请求、改文件, therefore 它建议「不要一次性全装」,只读需要的;装前读 SKILL.md、查贡献历史;并给出本地自扫命令 skill-scanner scan /path/to/skill –use-behavioral。团队用 Cisco AI Defense Skill Scanner 每周增量扫描、每 30 天全量重扫,结果公开在 docs/security-report.md。K-Dense 自己写的技能经过内部评审,社区贡献的尽力审但资源有限。
四、能跑出什么:真实科研工作流举例
README 给了一组可直接抄的提示词,每条都列出用到的技能。举几个有代表性的:
- 药物发现管线:查 ChEMBL 的 EGFR 抑制剂(IC50 < 50nM)→ RDKit 做 SAR → datamol 造类似物 → DiffDock 对接 AlphaFold 结构 → 检索突变与文献 → 出图出报告。用到的技能:database-lookup、rdkit、datamol、diffdock、paper-lookup、scientific-visualization。
- 单细胞 RNA-seq:Scanpy 加载 10X 数据、QC 与去双联、接 Cellxgene Census、PyDESeq2 差异表达、Arboreto 推基因调控网络、Reactome / KEGG 富集、Open Targets 找靶点。
- 多组学标志物:PyDESeq2 + pyOpenMS + HMDB / Metabolomics Workbench + STRING + scikit-learn,跨 RNA / 蛋白 / 代谢三层预测患者结局。
- 临床变异证据审阅:只处理经授权的合成或去标识 VCF,用 pysam 解析、Ensembl VEP 注释,再拉 ClinVar / COSMIC / NCBI Gene / UniProt 证据并核对文献,产出可溯源的研究摘要;若用到 clinical-reports,只从已核实的源事实清单生成明显标记为草稿的结构,不诊断、不评估个体风险、不给治疗或入组建议。
README 开头还提到一个配套项目 K-Dense BYOK:一个免费、开源、跑在你自己桌面上的 AI 共科学家,自带网页搜索、文件处理、100+ 科学数据库,并加载这整套 163 个技能;数据留在本地,重活可经 Modal 扩到云端。它和本仓库的关系,相当于「预装好这些技能的开箱客户端」——如果你不想自己配 Agent Skills 环境,BYOK 是更省事的入口。
这些不是 demo 话术,博客里还给了硬指标:PyOpenMS 技能在 250 次运行中任务成功率 100%(无技能 96%)、pyOpenMS API 报错少 92%、成本低 10%;Rowan 技能对比实验数据 pKa MAE 0.23(R² 0.986);optimize-for-gpu 在 12 个库上平均提速 58 倍。
五、覆盖哪些学科
技能按领域分了十几组,挑重点的:生物信息 / 基因组(27 个,含 Scanpy、OneKGPd 个体化千基因组查询、Genomic Intelligence 宿主调控预测)、化学 / 药物发现(10 个,RDKit、DiffDock、DeepChem、PyTDC)、蛋白质组与质谱(matchms、pyOpenMS)、临床证据(8 个,含 PK/PD 建模)、神经与电生理(BIDS、NeuroKit2)、机器学习与 AI(14 个核心,PyTorch Lightning、PyMC、TimesFM)、材料 / 化学 / 物理(pymatgen、COBRApy、Qiskit)、工程与仿真(build123d、SimPy、SymPy)、数据分析与可视化(22 个,含 GeoPandas、Scientific Visualization、Infographics)、实验室自动化(PyLabRobot、Opentrons)、科学传播(27 个,Paperclip、Scientific Writing、PPTX 海报)。临床、监管类技能都明确写「仅研究 / 草稿,不替代诊断或认证决策」。
六、质量与可靠性怎么保证
对科研来说「跑通」不够,还要可复现、可溯源。README 在多处强调:每个带 scripts/ 的技能都有测试套件,外加仓库级结构契约(frontmatter、链接解析、脚本解析、–help 行为)每次 PR 都跑;database-lookup 等技能带「检索契约、分页 / 计数对账、端点溯源」,让结果可审计。博客里更直接地点出核心观点——「模型不再是瓶颈,瓶颈在工作流层(数据访问、代码执行、验证、可审计输出)」,并主张「复现,而不是生成,才是 AI 之于科学最有价值的应用」:在 221 项研究的基准里,78% 的论文、93% 的单个分析任务被成功复现。
七、许可与合规边界
仓库整体是 MIT 许可(Copyright © 2026 K-Dense Inc.),可商用、可修改、可分发,但「按原样、无担保」。关键的坑在于:每个技能自己还有独立的 license 字段,写在各自 SKILL.md 的 license metadata 里,可能和仓库的 MIT 不同,用户要为每个用到的技能单独看许可。其中 docx / pdf / pptx / xlsx 四个文档技能由 Anthropic 维护、按 Anthropic 条款 vendored 进来。FAQ 也确认:免费、可商用,但个体技能许可各异。
八、常见问题
Q1:要一次性装完所有 Python 包吗?
不需要。只装你用到的;每个技能在 SKILL.md 里声明自己的依赖,用 uv pip install 单独装。
Q2:技能能离线用吗?
数据库类技能要联网查 API;包类技能在 Python 依赖装好后可离线运行。
Q3:为什么所有技能塞在一个仓库而不是分开?
作者认为 AI 时代的好科学天然跨学科——把基因组、化学、临床、ML 放在一套里,agent 才能一句话跨领域组合,而不用先纠结装哪个、怎么接。
Q4:能用别的模型吗?
核心 SKILL.md 格式遵循开放 Agent Skills 标准,但安装路径、发现机制与各客户端版本有关,需对照目标客户端当前文档。
九、总结
Scientific Agent Skills 的价值,是把「专家怎么正确地做科研」这件事,从个人脑子里的经验,变成了 163 张可复用、可验证、可溯源的技能卡片,再通过一个开放标准塞进任意 AI 客户端。它不替模型思考,而是给模型补上「该调哪个库、查哪个库、边界在哪、出处何在」的工作流层——这正是当下 AI for Science 最缺、也最值钱的一块。对做生物、化学、临床、组学、材料的研究者来说,挑一个主题子集装进自己的客户端,往往比换更大的模型更能直接提升产出。
本文仅作技术介绍。该库含临床、监管类技能,其输出明确为研究草稿 / 证据准备,不替代诊断、治疗、认证或合规决策;涉及人类数据须使用经授权的合成或去标识数据。请遵守各技能各自的许可条款与所在地法律法规,并在合格专业人员审阅下使用。
在撰写本文的过程中,我主要参考了以下来源:GitHub 仓库 K-Dense-AI/scientific-agent-skills 的 README(What’s Included / Getting Started / Use Cases / Available Skills / Security / License / FAQ)、arXiv:2609.00065,以及仓库博客中的基准数据。文中数据(Star 数、技能数、版本号等)以仓库公开信息为准,可能随版本更新而变化。
本文由 AI 辅助整理,基于 GitHub 项目 K-Dense-AI/scientific-agent-skills 的公开文档撰写;内容仅用于技术介绍,涉及临床 / 监管类技能的输出不替代专业决策,请遵守各技能许可与所在地法律法规。







