
 AI智汇具 - AI工具推荐与技能教程_好用的AI工具大全
在自家硬件上跑前沿 MoE 模型——纯 C 引擎 · 零依赖 · 专家从磁盘流式加载 · 小引擎装下大模型
Apache-2.0
C
744B→2.8T MoE
Tiny engine, immense model
colibri 是一个用纯 C 写成、运行时不依赖任何外部库的大模型推理引擎,官方口号是「Tiny engine, immense model」。它把 VRAM、RAM 与 NVMe 磁盘视作同一层内存层级,用「权重 JIT」的思路让 744B 乃至 2.8T 参数的 MoE 模型在你已经拥有的硬件上跑起来——不需要 GPU,不静默改精度。本文覆盖它是什么、核心技术与实测速度、支持的模型家族、安装运行方式、与 llama.cpp 等方案的对比、推理机制、实用技巧、更新动态与常见问题。
一、colibri 是什么
(一)它要解决什么
colibri 由 JustVugg 发起,仓库全名 JustVugg/colibri,目前约 2.7 万 Star、采用 Apache-2.0 协议。它的目标写在 README 第一句:在一台普通机器上,跑起 744B 到 2.8T 参数的前沿 MoE 模型。过去这类模型要么租云上大厂级 GPU,要么根本碰不到;colibri 的赌注是——模型不需要「塞进」显存,只需要被「安放」到正确的存储层。它用纯 C、零引擎依赖,把磁盘、内存、显存统一成一条推理层级,让 744B 的 GLM-5.2 在 25 GB 内存、十二核 CPU 的笔记本上也能跑,只是慢,但结果正确。
(二)「蜂鸟引擎」的设计哲学
项目取名 colibrì(蜂鸟),README 专门有一节解释:蜂鸟体重几克,却能在原地悬停、一天访上千朵花。这个引擎用「蜂鸟般的口粮」养活 7440 亿参数的巨人——25 GB 内存、十二个 CPU 核心,加上大把磁盘耐心。它的哲学有两条红线:一是「不为速度做任何 SLA 保证,但为语义做硬性保证」——默认的放置策略永远不会静默改变模型精度或路由语义;二是「实验必须靠可复现的端到端测量赢得位置」。也就是说,快不快可以打折,但正确性不能偷换概念:快速内存不够只会变慢,绝不会悄悄 redefine 模型。
(三)引擎长什么样
整台引擎就是一个 C 文件加几个小头文件:c/colibri.c 是 GLM-5.2 引擎,其余每个模型家族各有一个 .c;没有 BLAS、运行时不依赖 Python、也不需要 GPU。统一的前端面是 coli chat / coli serve / coli web。所有引擎共享同一批头文件——safetensors 读取、容器解码、分词器、专家缓存——所以一个修复能同时到达全部家族。这一点 README 强调不是装饰:反复出现的缺陷,恰恰是从一个引擎落地、却没传到兄弟引擎的那些机制。
二、核心技术与实测表现
(一)给权重造一个 JIT
核心算法被 README 类比成「一个 JIT,但它是给权重用的」。编译器的 JIT 不会把整个程序都编译进内存,而是看哪些路径真的在跑,再即时编译热点。colibri 对 744B 参数空间下同样的赌:参数不是要常驻的状态,而是要按照路由需求、跨异构存储层级(VRAM / RAM / NVMe)去「暂存」的数据。路由有可度量的结构——作者把 19,456 个专家画成一张「脑图」,颜色代表存储层、亮度代表路由热度——而结构是可缓存的。引擎因此会学习你的工作负载:你跑得越多,对的专家越热,它就越快。
(二)把 VRAM、RAM、磁盘当成一层
一个 744B 的 MoE,每个 token 只激活约 40B 参数,其中随之变化的路由专家约 11 GB。colibri 的做法是:稠密部分(注意力、共享专家、嵌入,约 17B 参数)常驻 RAM 的 int4(约 9.9 GB);19,456 个路由专家(约 370 GB)住在磁盘上,按需流式加载,配每层的 LRU 缓存、一个学习到的固定热存,以及可选的 VRAM 层。磁盘不够快?它支持双 SSD:把模型整份再放一块盘,用 COLI_MODEL_MIRROR 让引擎同时从两块盘读,两块盘的带宽相加,实测 9 GB/s + 3 GB/s 的组合比单快盘再快约 33%。镜像盘启动即校验,拔掉第二块盘也只是降级、不会崩。
(三)实测速度
同一引擎、同一 int4 容器,硬件只改变专家住哪儿。README 的完整基准里有几组硬数字:6× RTX 5090 全常驻,解码 5.8–6.8 tok/s,TTFT 约 13 秒;128 GB 纯 CPU 台式机,warm 状态约 1.8 tok/s;单张 RTX 5070 Ti 笔记本级显卡,靠 GPU 常驻管线 1.07 tok/s;而 25 GB 开发机冷启动 0.05–0.1 tok/s,正是这个项目起家的、诚实的速度底线。换句话说,速度由你的磁盘决定,因为专家是从磁盘流式读的——慢盘上每秒零点几个 token,快盘 warm 后几个 token。
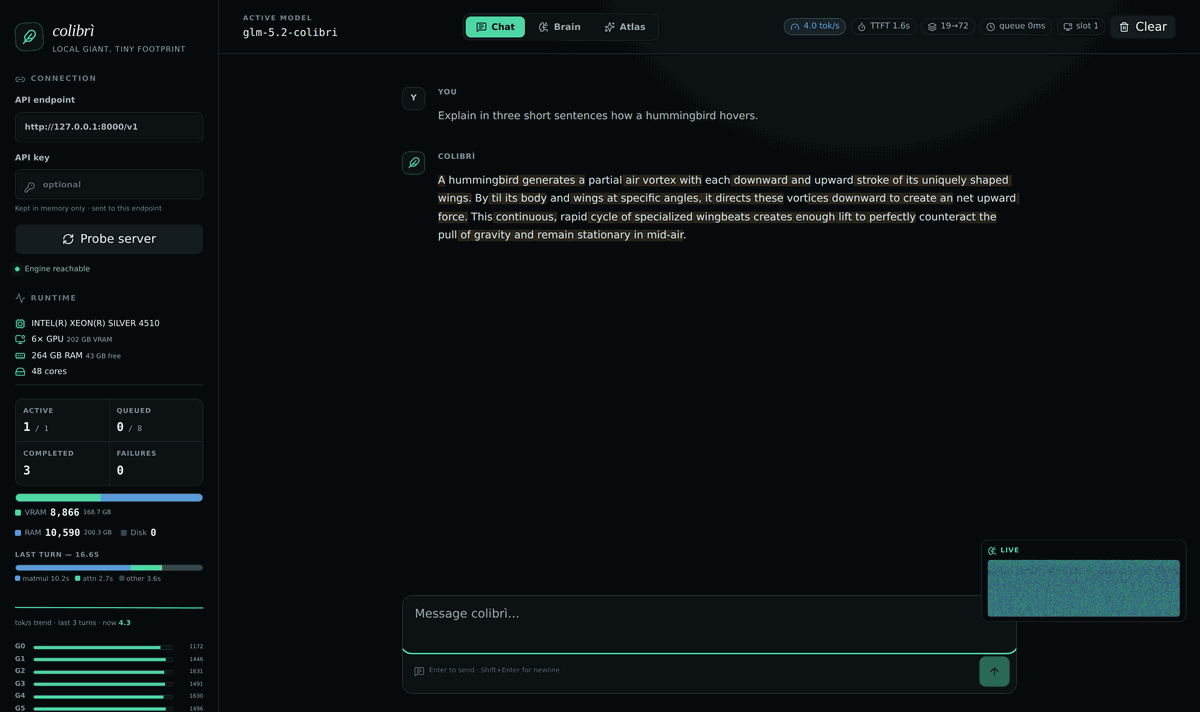
质量是被测量而非假设的:int4 容器的量化代价、scale 粒度与旋转消融都留在 docs/benchmarks.md。另有一些值得记的优化点:MLA 注意力把 KV 状态压到每 token 576 个浮点(而非 32,768),小了 57 倍,还能跨重启持久化;路由「往前看一层」可预测性实测达 71.6%;在带 DRAM 缓存的 NVMe 上开 O_DIRECT 解码可提升约 34%,但是磁盘相关的,QLC 或无缓存虚拟盘可能无效。
三、支持的模型家族
colibri 今天能跑八个家族,每个都是「兄弟引擎」——一个 C 文件、各自架构、共用同一套前端:
- GLM-5.2 / 5.3:744B(激活 40B),参考模型,约 372 GB 磁盘、16 GB 内存起步;
- GLM-5.3-Flash:321B,带视觉,约 195 GB;
- Inkling:975B(Thinking Machines),约 469 GB;
- Kimi K3:2.8T(Moonshot),原始 MXFP4 专家直接从 Hugging Face 分片流式读,无需转换;
- DeepSeek V4 Flash:284B,原生 fp4 路由专家;
- Qwen3.8-Flash-Next:125B + 51B n-gram,仅 CPU;
- Qwen3.6:35B-A3B,开 CUDA 后 VRAM 专家层在两张 8 GB 卡上实测 1.44 → 10.05 tok/s(7.0×);
- OLMoE:7B(AI2),int8 容器约 7 GB,门槛最低。
这些模型差异很大,README 特别提醒:读两个一起看容易误以为需求互相矛盾,其实它们只是不同的模型,且「没有一个需要 GPU」——GPU 只让它更快。作者还点名 MiniMax 是候选的下一个家族:谁能端到端测出一个,谁就赢得一个引擎。
四、如何安装与运行
(一)获取程序
最简单是下载预编译 release——Linux、macOS、Windows 都有,无需编译器。解包后里面有引擎本体、coli 启动器与其 Python 辅助脚本;引擎本身纯 C 零依赖,启动器与可选 API 网关才是 Python。也可以从源码构建,只需 gcc(或 clang)加 OpenMP:
git clone https://github.com/JustVugg/colibri && cd colibri/c
./setup.sh                                # 检查 gcc/OpenMP、构建、自测
(二)获取模型
以 GLM-5.2 为例,Hugging Face 上有预转换好的 int4 容器,约 372 GB,务必用 group-scaled(gs64)构建并带 int8 的 MTP 头;老式逐行 int4 镜像质量差约 9 个百分点,正是早期「思考循环停不下来」的根因。MTP 头必须 int8,int4 会让接受率掉到 0%。也可以自己从 FP8 源转换,命令可断点续传,不必一次性占满 756 GB 磁盘。
(三)跑起来
把模型指给 COLI_MODEL 即可,命令行在不同模型间完全一致——引擎读 config.json 自动挑对应二进制:
COLI_MODEL=/nvme/glm52_i4 ./coli chat     # 终端交互
./coli web  --model /nvme/glm52_i4        # API + 仪表盘,并打开浏览器
./coli serve --model /nvme/glm52_i4       # API + 仪表盘,无头运行
./coli plan                               # 查看规划的 VRAM/RAM/磁盘放置
./coli doctor --deep                      # 严格的张量/分片/索引/镜像预检
Windows 上 release 自带 coli.cmd,双击即可;源码方式则是 python coli chat –model D:\glm52_i4。注意 .exe 是引擎不是启动器,单独运行没有模型可加载会立刻退出。
五、官方地址与获取方式
- 代码仓库:github.com/JustVugg/colibri
- 项目官网:justvugg.github.io/colibri
- 模型权重:Hugging Face 上的 mastouri/GLM-5.2-colibri-int4-g64-with-int8-mtp 等镜像
- 社区:Discord(discord.gg/FkyrEeJR)与 GitHub Issues;作者欢迎你用自己硬件的基准数字来开 issue
六、与同类方案对比
(一)对比 llama.cpp
llama.cpp 是 colibri 在 Acknowledgements 里点名致敬的对象,也是多数人熟悉的纯 C 推理引擎。区别在于定位:llama.cpp 通用、稳,而 colibri 把「MoE 专家的分层暂存」做成了主攻方向——JIT 式预取、学习缓存、双 SSD 条带、跨 VRAM/RAM/磁盘的放置规划,都是围绕「专家从磁盘流式读」这一假设展开的。llama.cpp 的 GBNF 语法子集甚至被 colibri 的 grammar.h 直接复用。
(二)对比 vLLM 与 ktransformers
vLLM 是 colibri 匹配输出语义的参考实现(逐位置对齐最终 norm 落点),ktransformers 的专家卸载工作让对比可复现。但两者都偏服务化、偏 GPU 集群;colibri 反过来,把「没有稀缺硬件也能跑」当主目标,连 MLA KV、CUDA、Metal、Vulkan 后端都做成可选分层,而不是默认前提。它的核心贡献是推理系统层面的分层放置与可度量优化,而非又一个高吞吐服务。
(三)定位差异
一句话:llama.cpp 是「通用纯 C 引擎」,vLLM 是「高吞吐服务」,colibri 是「在已有硬件上把超大 MoE 跑起来的分层推理研究平台」。它把自己明确定位为推理系统研究产品——新模型、新格式、新调度都是被测出来的,不是宣传出来的。
七、核心机制深度解析
把整条 per-token 路径拆开,每一层的每个 token 都走同样的五步:
设计目标是「放置只决定速度」:无论专家从 VRAM 还是磁盘应答,路由决策与权精度都一致。这背后是硬性保证——默认策略永不静默改精度或路由语义。双 SSD、O_DIRECT、CUDA 常驻管线、Metal/Vulkan 后端,全都是这条主线的可选加速器;spec 解码(MTP、语法强制草稿)也严格端到端测量,不划算就关掉,绝不为了数字好看而改 token。
八、实用技巧
- 先跑 coli plan 与 coli doctor:看清这台机器把专家放在哪、缺口在哪,再决定要不要加 GPU 或第二块 SSD。
- 加第二块 SSD:用 COLI_MODEL_MIRROR 放一份镜像,带宽相加,冷盘也能显著提速;镜像盘启动即校验,拔掉只是降级。
- 调大 –ram:对 DeepSeek V4 这类专家缓存命中率决定 tok/s 的模型,RAM 是单最有价值的旋钮,且只改速度不改输出。
- 带 CUDA 的卡开 CUDA_EXPERT_GB=auto PIN_GB=all:让全部专家常驻显存,磁盘退出解码路径;Qwen3.6 在两卡上实测 7×。
- 开启学习缓存:引擎记录你的工作负载并把最热专家自动钉住,.coli_usage 每轮更新——你用得越多它越快。
- 必要时 DRAFT=0:spec 解码不是永远划算,量一量再决定,不划算就关。
九、常见问题 FAQ
Q1:一定要 GPU 吗?
不需要。八个家族都明确「没有一个需要 GPU」,GPU 只让它更快。25 GB 内存的纯 CPU 机器就能跑 GLM-5.2,只是冷启动很慢。
Q2:模型要占多大空间?
GLM-5.2 的 int4 容器约 372 GB,OLMoE 最小约 7 GB,Kimi K3 原始分片约 1.6 TB。具体见各家族表格,磁盘只是放置层,不够快也不会改输出。
Q3:它会为了快而偷偷降精度吗?
不会。README 把「永不静默改变模型精度或路由语义」写进默认策略,快速内存不足只减速度、不 redefine 模型。前向还对照 transformers 预言机逐 token 校验。
Q4:MTP 头为什么必须是 int8?
因为 int4 的 MTP 头接受率会塌到 0–4%,等于白 draft。作者用 issue #8 记录了这个坑,所以默认要求 int8。
Q5:怎么贡献?
作者最看重「带硬件、commit、命令、缓存状态、吞吐、TTFT、专家命中率、质量检查」的对照实验,甚至鼓励你发阴性结果——一个控制良好的失败,比一个解释不清的快数字更有价值。
十、总结
colibri 的价值不在「又一个推理引擎」,而在把「前沿大模型不必依赖稀缺硬件」这件事,做成一套可度量、可复现、可学习的系统。它用纯 C 的极小内核,把 VRAM、RAM、磁盘统一成一层,让 744B 的巨人活在蜂鸟般的口粮里——慢,但正确,且越用越快。对想在自家机器上「持有」而非「租用」智能、并愿意用基准数字参与研究的开发者,colibri 值得放进工具箱。
运行 744B 级模型需要可观的磁盘与内存,请结合自身算力评估成本;模型权重遵循各自许可(GLM-5.2 由 Z.ai 以 MIT 发布),使用时请遵守对应许可证与当地法规。
在撰写本文的过程中,我主要参考了以下来源:GitHub 仓库 JustVugg/colibri 的 README、docs 目录下的基准与技术文档,以及仓库自带的 logo 与示意图素材。文中数据(Star 数、模型规模、tok/s、KV 压缩比等)以仓库公开信息为准,可能随版本更新而变化。
本文由 AI 辅助整理,基于 GitHub 项目 JustVugg/colibri 的公开文档撰写;文中数据来自该仓库 README 与 docs。内容仅用于技术介绍,请结合自身算力与合规要求使用。







