
 AI智汇具 - AI工具推荐与技能教程_好用的AI工具大全
Firecrawl 安装使用完整教程
(2026 年最新)
做过 AI 应用的人大概都写过这样一段代码: requests 拉网页、BeautifulSoup 解析、发现是 SPA 空壳、加上 Playwright、再被反爬拦、再配代理池、再处理懒加载……一周就没了。Firecrawl 想干的事很简单:把这一整串脏活封成一条 API,你给它 URL,它返回干净的 Markdown、结构化 JSON 或截图。这个项目目前已有 179,000+ Stars,官方称覆盖 96% 的网页(含 JS 重站点),P95 延迟 3.4 秒。本文带你从零跑通它。
🔧 准备工作
Preparation
- 注册拿 Key——到 firecrawl.dev 注册获取 API Key(形如
fc-YOUR_API_KEY)。不确定要不要用的话,官方提供了 Playground,注册前就能先试。 - 选一个 SDK——官方提供 Python、Node.js、Go、Java、Elixir、Rust、Ruby 七种。SDK 的额外价值是会自动处理异步任务的轮询,不必自己写 while 循环查状态。
- 想清楚云端还是自托管——绝大多数场景直接用云版即可;有数据合规要求或想完全掌控,可以看后面的 FAQ。
- (可选)准备 Agent 环境——如果你要让 Claude Code、Cursor 之类的编程助手直接调它,后面有一键接入的章节。
📦 十分钟跑通第一个请求
Quick Start
Step 1安装 SDK
# Python
pip install firecrawl-py

# Node.js
npm install firecrawl
Step 2抓取一个网页(scrape)
这是最核心的动作:给一个 URL,拿回 LLM 能直接用的内容。
from firecrawl import Firecrawl

app = Firecrawl(api_key="fc-YOUR_API_KEY")

# 只要正文,返回 Markdown
doc = app.scrape("https://firecrawl.dev", formats=["markdown"])
print(doc.markdown)
不写代码也行,CLI 一条命令:
firecrawl scrape https://firecrawl.dev
firecrawl https://firecrawl.dev --only-main-content
输出格式除了 Markdown,还可以要 HTML、截图,或者按你给的 JSON Schema 直接返回结构化数据。网页里嵌的 PDF、DOCX 等文件它也能解析。
Step 3搜索并直接取回内容(search)
很多人不知道 Firecrawl 也能搜:搜索结果会连带把每个命中页面的正文一起抓回来,省掉「先搜再逐个抓」两步。
search_result = app.search("firecrawl", limit=5)

# 返回 [{url, title, markdown}, ...]
🕷️ 整站级操作:Crawl、Map、Batch
Site-Scale
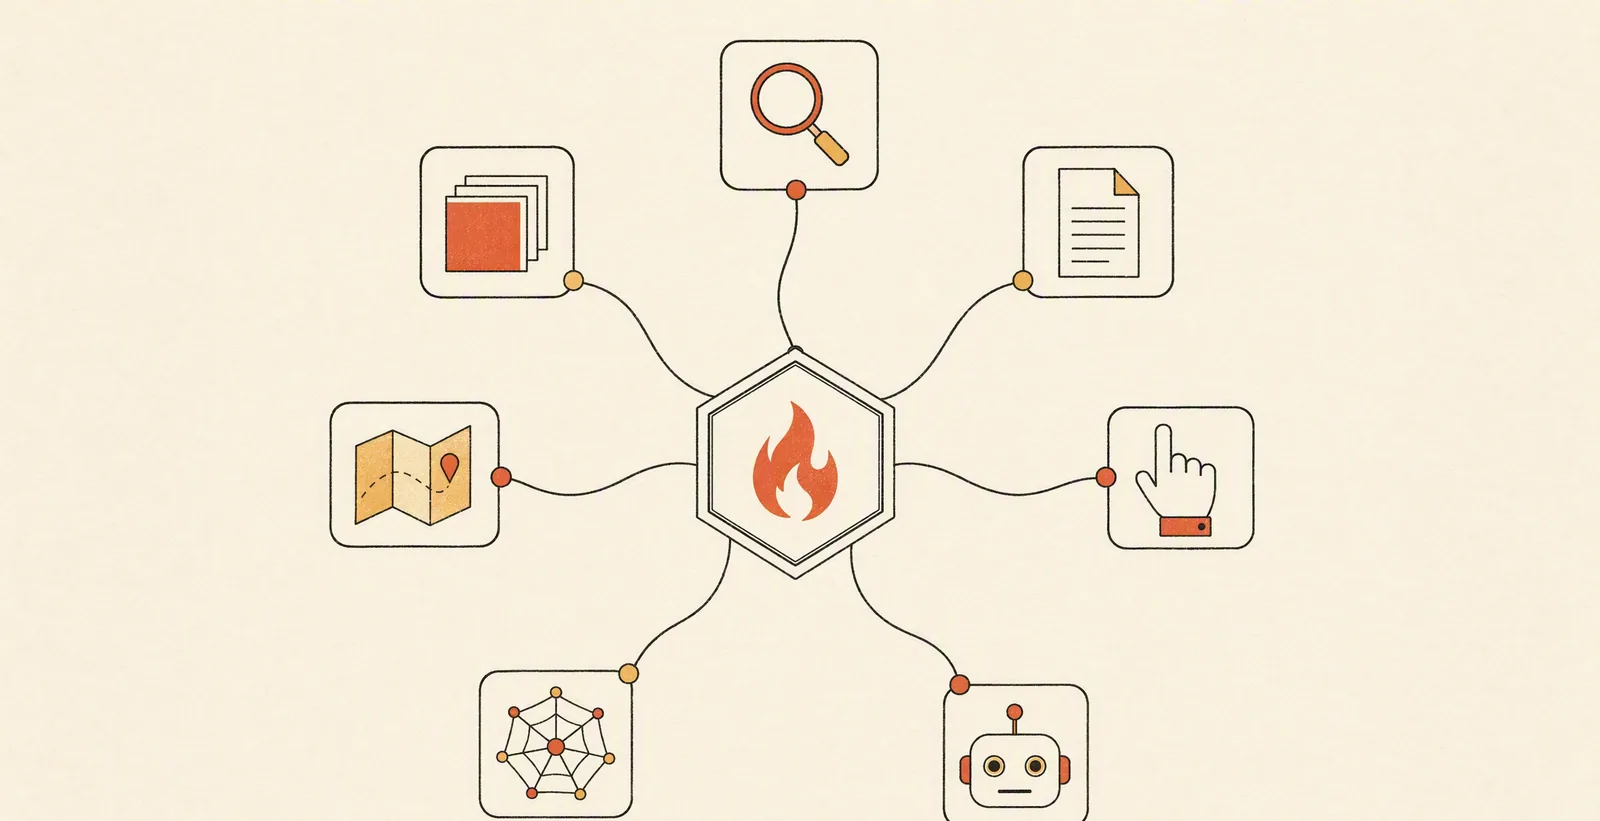
单个页面之外,Firecrawl 提供三种批量能力,构成了它的「整站」视角:
一个请求抓完整站。传 URL 加 limit,返回一个 job ID;用 SDK 时会自动轮询到完成,拿到 status、total、creditsUsed 和全部页面数据。
瞬间列出站点上所有 URL 及其标题、描述。还能带 search 参数,按与关键词的相关度排序——想在一个大站里精准定位某类页面时特别省事。
一次丢进上千个 URL 异步抓取,适合已有链接清单的场景。
# 找出一个站点里和 pricing 最相关的页面
result = app.map("https://firecrawl.dev", search="pricing")
🤖 两个进阶能力,值得单独说
Advanced
AAgent:不用知道 URL 也能拿数据
这是原 /extract 端点的演进版。你只描述要什么,它自己去搜、去导航、去取——不需要事先知道数据在哪个网址上。
curl -X POST 'https://api.firecrawl.dev/v2/agent' \
  -H 'Authorization: Bearer fc-YOUR_API_KEY' \
  -H 'Content-Type: application/json' \
  -d '{ "prompt": "Find the pricing plans" }'
BInteract:先抓页面,再用自然语言操作它
抓取之后拿到一个 scrape_id,就可以用提示词驱动页面动作,也可以直接用代码控制点击、滚动、输入、等待、按键。
result = app.scrape("https://amazon.com")
scrape_id = result.metadata.scrape_id

app.interact(scrape_id, prompt="Search for 'mechanical keyboard'")
app.interact(scrape_id, prompt="Click the first result")
返回里带一个 liveViewUrl,可以实时观看 Agent 在页面上操作——调试时非常直观。
🔌 接入你的 AI 编程助手
Agent Setup
官方推荐两种方式,都很短。
方式一Skill + CLI,一条命令
npx -y firecrawl-cli@latest init --all --browser
装完记得重启你的 Agent。支持 Claude Code、Antigravity、OpenCode 等。
方式二MCP 配置
{
  "mcpServers": {
    "firecrawl-mcp": {
      "command": "npx",
      "args": ["-y", "firecrawl-mcp"],
      "env": { "FIRECRAWL_API_KEY": "fc-YOUR_API_KEY" }
    }
  }
}
此外还有 Lovable、Zapier、n8n 等平台集成,以及 LangChain、LlamaIndex 等框架的适配。有意思的是官方甚至给 AI Agent 准备了一份入职文档——让 Agent 自己读着帮你注册、拿 Key、开始调用:curl -s https://firecrawl.dev/agent-onboarding/SKILL.md。
✅ 验证与排错
Verification
- 先走 Playground——不用写代码,在官方 Playground 里输入 URL 看返回,确认账号与 Key 可用。
- 本地跑一条 scrape——能拿到非空 Markdown,说明 SDK 与网络正常。
- 跑一次 map——返回 URL 列表即说明整站发现能力正常,这一步通常比 crawl 便宜得多,适合先探路。
- 检查 creditsUsed——crawl 完成后返回体里有
total、completed、creditsUsed三个字段,用它们核对消耗是否符合预期。
🛡 常见问题解答
FAQ
Q1:开源版、云版、自托管有什么区别?
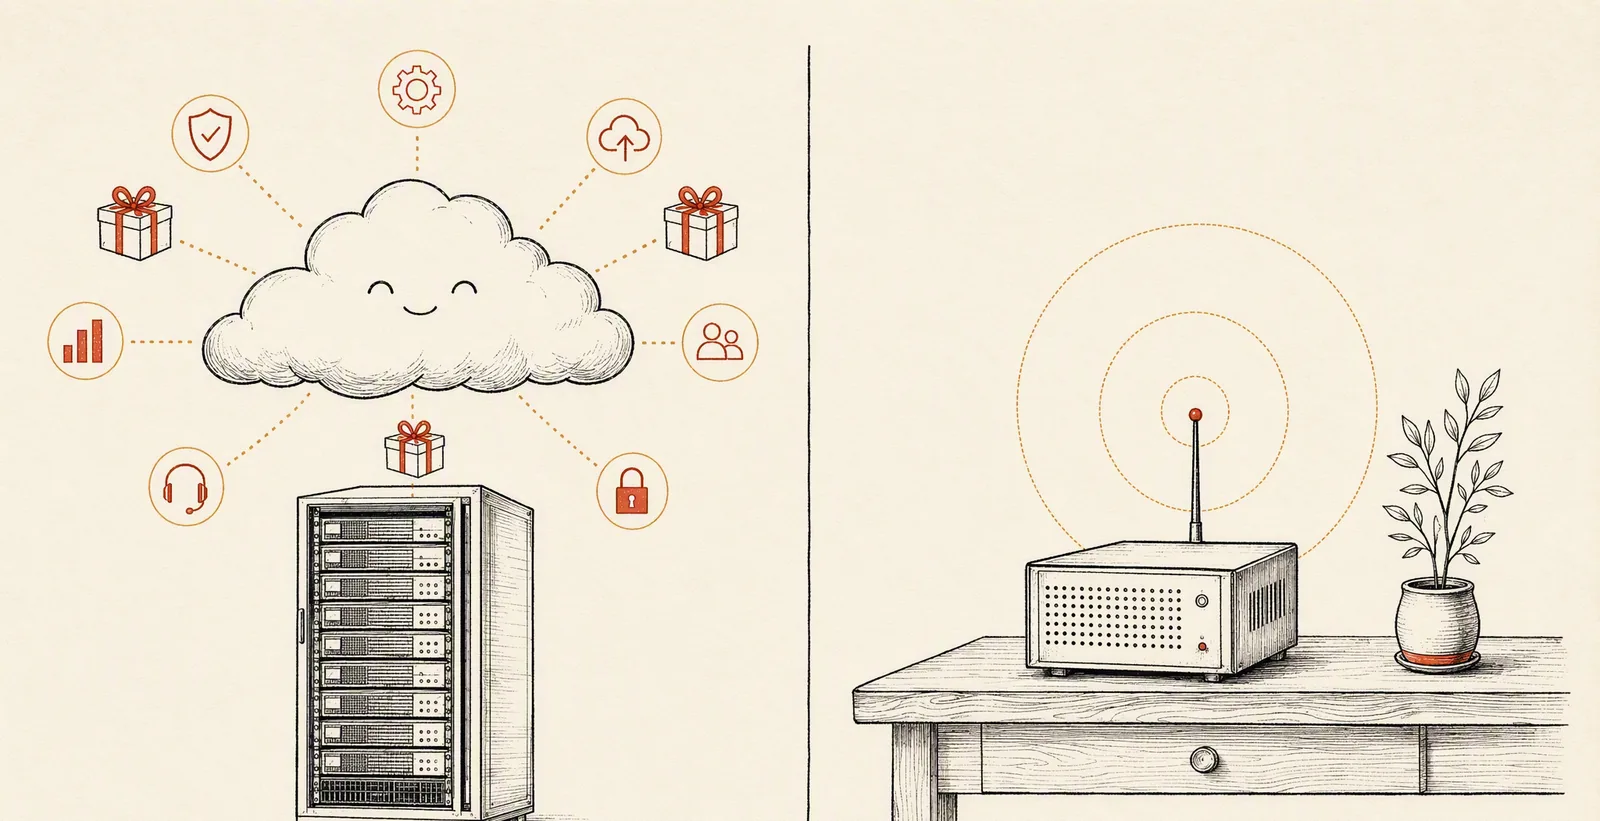
Firecrawl 主体开源(AGPL-3.0),但云版包含额外功能,官方在 README 里专门放了一张对比图。要本地跑,看 Contributing Guide;要自托管部署,看官方 Self-Hosting Guide。
Q2:JS 重站点和反爬页面能搞定吗?
这正是它的主要卖点:官方称覆盖 96% 的网页(含 JS 重度页面),代理轮换、编排、限流、JS 拦截内容都由平台处理,零配置。P95 延迟 3.4 秒,是为实时 Agent 场景设计的量级。
Q3:随便抓别人的站,合规吗?
Firecrawl 默认遵守 robots.txt,但官方在 License 段落写得很直白:尊重目标站点政策是使用者的唯一责任,你需要自行遵守相关隐私条款与使用条款。把它当成一把电钻——工具没问题,用在别人家承重墙上就是你的事了。
Q4:公司项目用 AGPL 协议有问题吗?
核心仓库是 AGPL-3.0,SDK 与部分 UI 组件是 MIT。调用云端 API 通常不涉及 AGPL 的网络服务条款;但如果你修改 Firecrawl 本体并作为网络服务对外提供,就需要考虑公开相应修改。商业授权问题建议直接联系官方确认。
Q5:和 wigolo 这类本地方案怎么选?
| 维度 | Firecrawl | wigolo |
|---|---|---|
| 运行位置 | 云端托管 API | 本机进程 |
| API Key | 需要 | 核心功能不需要 |
| 成本模型 | 按量计费 / credits | $0 每次查询 |
| 数据是否出本机 | 会经云端处理 | 默认不出 |
| 覆盖能力 | 官方称 96% 网页、含重 JS | 依赖公共引擎 + 本地浏览器 |
| 整站爬取 | 成熟(含 map / batch) | 支持 |
| 安装体积 | SDK 轻量,算力在云端 | 约 1.5 GB(本地浏览器 + 模型) |
| 协议 | AGPL-3.0(SDK 为 MIT) | AGPL-3.0 |
* 表中 wigolo 信息来自其公开 README,Firecrawl 数据来自其官方 README,均为各自口径,不构成第三方评测结论。
简单说:要规模、要稳定覆盖、不想自己养基础设施,选 Firecrawl;要零成本、数据绝对不出本机、能接受自己扛算力,wigolo 更合适。两者都提供 MCP,接进同一个 Agent 也不冲突。
Q6:有哪些典型用法?
- RAG 知识库构建——用 crawl 把产品文档整站转成 Markdown 入库。
- 竞品价格监控——batch_scrape 一批商品页 + JSON Schema 抽结构化字段。
- Agent 实时联网——MCP 接入,让编程助手直接查最新文档。
- 需要登录/交互的流程——Interact 驱动点击输入,配合 liveView 观察。
◆ 项目信息
官网与文档:firecrawl.dev · docs.firecrawl.dev
在线试用:firecrawl.dev/playground · API 参考:docs.firecrawl.dev/api-reference
最快上手:
pip install firecrawl-py → app.scrape("https://example.com", formats=["markdown"])







