
 AI智汇具 - AI工具推荐与技能教程_好用的AI工具大全
BrowserAct Skills 安装使用完整教程
(2026 年最新)
当你让 AI agent 去操作一个真实网站,卡点往往不是「不会点」,而是反爬拦截、登录态复用、多任务互相污染这三件事。BrowserAct 就是为此而生的浏览器自动化 CLI:面向 AI agent 和团队,做真实浏览器自动化、网页数据抽取与基于账号的工作流,底层靠 stealth 指纹伪装、TLS 轮换、住宅代理与验证码求解托底。这个仓库用 Python 写成,MIT 协议开源,目前已有 5,907 Stars。本文带你厘清它的两种使用模式,并完整走通安装、快速上手与核心能力。
browser-act Skills/CLI 是MIT 开源仓库;而 README 里引导的 BrowserAct 云端托管是需要注册账号的商业服务。开源部分基础能力「无需注册」即可用,但 stealth 浏览器、验证码求解、Skill Forge 等需登录,受管代理与超过 5 个 stealth 浏览器需付费,免费范围以官方为准。抓取请遵守目标网站条款与当地法规。🔧 准备工作
Preparation
BrowserAct 的定位很明确:给 agent 用的浏览器,而不是给人写的脚本。开始安装前,先确认下面几件事。
- 一个能执行 shell 命令的 agent——README 列出兼容 Claude Code、Cursor、VS Code、OpenCode、OpenClaw、Codex、Gemini CLI,只要是能跑命令、能加载 Skill 的 agent 都可以。
- 操作系统——支持 Windows、macOS、Linux 三大平台。
- 想清模式——是要本地浏览器控制、复用本地 Chrome 登录态,还是用云端托管?两者差别很大,下一节展开。
- 账号预期——只用最基础的浏览器自动化无需注册;用到 stealth 相关能力需要一个已登录账号。
🎯 两种使用模式
Two Usage Modes
README 开篇就把话说清:提供两种模式——完全云端托管执行,或由你自己的 agent 工作流驱动的本地浏览器控制。选错模式,后面全白搭。两种模式背后其实是同一套定位:让 AI agent 和团队做真实浏览器自动化、网页数据抽取、基于账号的工作流,帮 agent 突破反爬墙、卡住时跨平台移交人工、并行多任务不互相污染、多账号在相互独立的浏览器里隔离。
① 云端托管执行。官方描述为「无需配置 agent,运营成本更低」:你描述网站、筛选条件和要抓的字段,它在真实云浏览器里构建并测试一个可复用的抓取 Bot,然后从云端运行,口号是 Build once. Run reliably. Improve continuously.
② 本地用 Skills。当你需要本地浏览器控制、复用本地 Chrome 登录态,或把它集成进自己的 agent 工作流时用这一档。agent 加载 BrowserAct Skill 后,用 get-skills 发现浏览器状态,直接从本地环境执行浏览器自动化命令。
| 维度 | 云端托管 | 本地 Skills(本教程主角) |
|---|---|---|
| 是否需要配置 agent | 无需 | 由你的 agent 加载 Skill |
| 运行位置 | 真实云浏览器 | 你的本地环境 |
| 本地 Chrome 登录态 | — | 可复用 |
| 适合场景 | 描述字段即出结果、追求低运营成本 | 深度集成进自有 agent 工作流 |
| 性质 | 商业托管服务 | MIT 开源 CLI |
* 云端服务的具体价格 README 未披露;本地 Skills 的免费与付费边界见「What’s Free」一节。
📦 安装步骤详解
Installation
官方给出的安装方式很「agent 化」:不是让你手动敲一串命令,而是把一句话发给你的 AI agent,让它自己完成安装与校验。
Step 1把安装指令发给你的 agent
README 原文是让你对 agent 说下面这句话,指定 Skill 源仓库地址,并要求装完后验证。
Install browser-act. Skill source: https://github.com/browser-act/skills/tree/main/browser-act . Verify it works after installation.
Step 2让 agent 用 get-skills 自检
安装后,agent 会在每个会话开始时运行 get-skills,一次拿到环境状态、浏览器列表和可用命令。
browser-act get-skills core --skill-version 2.0.2
这一步能跑通,就说明 Skill 已被正确加载。
⚡ 快速上手
Quick Start
README 的 Quick Start 给了两段示例:一段是零配置抽取受保护页面,一段是完整的浏览器自动化。命令与参数保持原样。值得注意的是它的交互范式——不像传统脚本那样选择器定位元素,而是先取回带索引的页面状态,再用序号点击或输入,这对 agent 推理更友好。
示例 A抽取受保护页面内容(零配置)
# Extract protected page content (zero config)
browser-act stealth-extract https://example.com
示例 B完整浏览器自动化
用 --session 给任务命名,再用带索引的 state/click/input 与页面交互,agent 不需要解析 DOM。
# Full browser automation
browser-act --session my-task browser open <id> https://example.com
browser-act --session my-task state          # See clickable elements
browser-act --session my-task click 3        # Click by index
browser-act --session my-task input 2 "hi"   # Type into a field
🧩 为 agent 做对的浏览器
Why BrowserAct
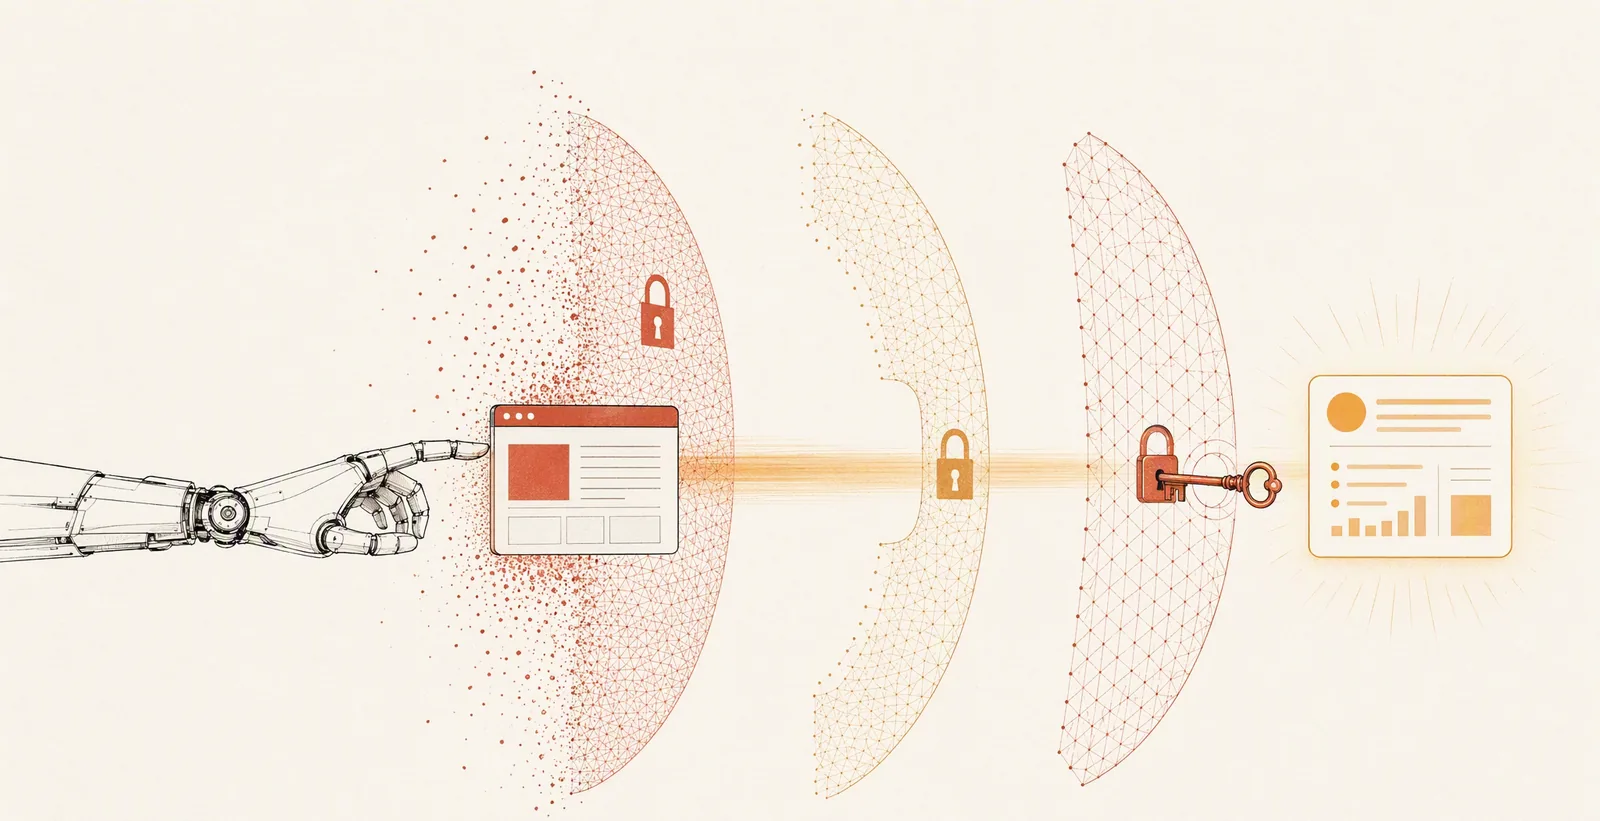
README 的「Why BrowserAct」提出了一个判断标准:给 agent 用的浏览器,必须能到达标准工具到不了的地方、在 agent 卡住时让人无缝接手、保持并行任务不互相污染,并且为 LLM 推理而设计——而不是给人写的脚本。它把这归纳为「必须做对四件事」。下面逐条如实展开。
第一件:突破封锁——三层递进。
- 环境层——stealth 指纹伪装、TLS 轮换、代理切换。绝大多数封锁根本不会触发。
- 执行层——
solve-captcha自动解验证码;stealth-extract一条命令抽取受保护页面。 - 人工层——
remote-assist生成一个实时 URL,用户可从任意设备接手,完成后 agent 无缝继续。
第二件:三种浏览器模式。按真实场景划分。
| 模式 | 场景 | 关键特性 |
|---|---|---|
chrome |
复用本地 Chrome 登录态 | Profile 导入或 CDP attach |
stealth 隐私模式 |
无需登录的无摩擦批量抓取 | 每会话新指纹 + 代理轮换,零残留 |
stealth 固定身份 |
已登录账号 · 多浏览器并行 | 稳定指纹 + 稳定 IP,不被判定为 bot |
第三件:零干扰并发。每个 agent 都在自己的赛道上。
- 跨浏览器并行——独立的 cookie、指纹、代理,站点无法把它们关联起来。
- 同浏览器多会话——共享登录态、独立执行,任务之间不互相阻塞。
- 隐私模式——每会话新指纹与空 profile,用完零残留。
第四件:为 agent 推理而设计,而非人写的脚本。
索引化文本格式,比 JSON 或 HTML 高出数倍的 token 效率。
state 返回带索引的列表,用 click 3/input 2 "...",无需解析 DOM。
每个浏览器都带一个 desc,按语义与任务匹配。
会话所有权 + 显式命名,多 agent 操作永不冲突。
🌐 生态与相关项目
Ecosystem
README 还提到几项相关能力,以及兼容生态。
- Skill Forge · 你的个人抓取工程师——对同一网站要反复大规模取数时,它把站点探索一次、发现其 API 与数据模式,生成一个可直接部署的 Skill 包,之后无需重复探索即可稳定跑 500 或 5,000 条。
- Solutions Catalog——30 多个已由 Skill Forge 生成的预制 Skill,开箱即用,覆盖 Amazon、Google Maps、YouTube、Reddit、WeChat、Zhihu 等。
- Build Your Own——找不到现成的?描述你要的数据或动作,几分钟生成任意网站的自定义 Skill,无需写代码。
安装 Skill Forge 同样是把一句话发给 agent:
Install browser-act-skill-forge. Skill source: https://github.com/browser-act/skills/tree/main/browser-act-skill-forge . Verify it works after installation.
兼容性方面,除上面列出的 Claude Code / Cursor / Codex / OpenClaw 等之外,官方表述是「任何能执行 shell 命令并加载 Skills 的 agent」都能用。另有两项顺带能力:更好的 headless(默认无头不打扰用户、stealth 无头不被检测)与跨平台远程移交(任意设备打开链接即可接手)。
✅ 验证与排错
Verification
装完之后,按这个顺序确认它真的在跑。
- 跑自检——执行
browser-act get-skills core --skill-version 2.0.2,能看到环境状态、浏览器列表与命令即算加载成功。 - 验零配置抽取——用
browser-act stealth-extract https://example.com试一条,确认能取回内容。 - 验会话式操作——开一个
--session,依次试state、click、input,观察索引交互是否符合预期。
stealth-extract、solve-captcha、remote-assist、隐私模式、Skill Forge 都需要已登录账号,未登录会拿不到;②超过 5 个 stealth 浏览器或受管代理(Dynamic/Static)属付费项;③安装是给 agent 的自然语言指令,别当成一条本地 shell 命令直接敲。🛡 常见问题解答
FAQ
Q1:这是开源项目还是商业产品?
两者都有。仓库里的 browser-act Skills/CLI 采用 MIT 协议开源;README 里引导的 BrowserAct 云端是需注册的商业托管服务,页面带有获客链接(首页带 ?co-from=github 参数、YouTube demo、云服务入口)。评估时请把开源部分与云服务分开看。
Q2:真的几乎全免费吗?
README 的「What’s Free」说大部分免费,只有两项要付费:受管代理(Dynamic/Static),以及超过前 5 个的 stealth 浏览器。基础浏览器自动化与 Chrome/Chrome-direct 无需注册即可用;stealth 相关能力登录后可用。具体免费范围以官方为准。
Q3:需要 API Key 吗?
README 未提到 API Key。本地模式通过 browser-act CLI 命令运行;云端模式称「无需配置 agent」。两者的鉴权细节官方未在 README 中展开。
Q4:Skill 和 Skill Forge 是什么关系?
Skill 是给 agent 加载的浏览器自动化能力包;Skill Forge 则是「生成 Skill 的工程师」——它自动探索网站并产出一个可部署的 Skill 包。Solutions Catalog 是 Skill Forge 已生成的 30 多个现成 Skill。
Q5:它怎么保证不被滥用?
CLI 层有「确认门控」:创建/删除浏览器、Profile 导入、代理变更等敏感操作都要用户显式批准,且不沿用历史批准。但抓取是否合规仍取决于使用者,请遵守目标站点条款与当地法规。
Q6:适合谁用?
适合已在使用 Claude Code、Cursor 等 agent、又需要真实浏览器取数或跨账号工作流的开发者与团队。若你只想要「描述字段即出结果」,官方更推荐云端;若你要本地控制与集成,就用 Skills。
◆ 项目信息
官网/文档:browseract.com · docs.browseract.com
最快上手:
browser-act stealth-extract https://example.com







