
 AI智汇具 - AI工具推荐与技能教程_好用的AI工具大全
oMLX 安装使用完整教程
(2026 年最新)
在 Apple Silicon 上跑本地大模型,很多人卡在同一个地方:要么图省事用一体化客户端,牺牲对上下文、显存、模型的掌控;要么自己搭服务,被调度、缓存、并发折磨到放弃。oMLX 想同时给你「方便」和「可控」——它以连续批处理(continuous batching)加分层 KV 缓存(热的内存层与冷的 SSD 层)为核心,并且整套服务直接从 macOS 菜单栏管理。项目开源,已积累 21,676 Stars,采用 Apache-2.0 协议。本文带你从系统要求、三种安装方式一路走到运行形态与常见坑,把 oMLX 真正跑起来、用明白。
localhost:8000 仅限本机访问,无需鉴权;一旦把地址改绑到局域网或 0.0.0.0,官方强制要求先设置 API Key,否则服务拒绝启动。请仅在你有权限的设备与网络上部署,并遵守所用模型的许可证。🔧 准备工作
Preparation
oMLX 是为 Apple Silicon 量身定做的推理服务器,因此它对运行环境有硬性要求,开工前先逐条核对。
- 芯片与平台——必须是 Apple Silicon,覆盖 M1/M2/M3/M4/M5;Intel Mac 不在支持范围内。
- 操作系统——macOS 15.0 及以上(Sequoia)。
- Python 版本——3.11 至 3.13;若走源码安装或需要构建自定义内核,还要装完整的 Xcode(仅 Command Line Tools 不够,缺 Metal 工具链)。
- 模型准备——oMLX 加载 MLX 格式的模型,可直接在管理后台一键从 HuggingFace 搜索下载,无需事先手动准备。
📦 安装步骤详解
Installation
官方提供三条安装路径,功能定位略有差异,按需选一条即可。下面从最省心的图形化方式讲起。
Step 1macOS 应用(推荐新手)
从仓库 Releases 页下载 .dmg,拖进 Applications 即可。App 内置自动更新,后续升级一键完成。同时它会安装一个轻量的 ~/.omlx/bin/omlx CLI 垫片(shim),让你能用终端命令、甚至 Apple 快捷指令(Shortcuts)去控制由 App 托管的服务器。
Step 2Homebrew(适合命令行常驻)
先添加 tap 再安装;升级用 brew update && brew upgrade omlx;用 omlx start 以后台服务运行,崩溃会自动重启。
brew tap jundot/omlx https://github.com/jundot/omlx
brew install jundot/omlx/omlx

# 升级到最新版
brew update && brew upgrade omlx

# 作为后台服务运行(崩溃自动重启)
omlx start

# 可选:安装 MCP(Model Context Protocol)支持
/opt/homebrew/opt/omlx/libexec/bin/pip install mcp
如果要用 GLM-5.2 / MiniMax M3 的原生自定义内核,官方注明目前需要 HEAD 构建:
brew install jundot/omlx/omlx --HEAD --with-custom-kernel
Step 3源码安装(适合开发者)
克隆仓库后按需安装依赖,仅核心用 pip install -e .,带 MCP 支持用 pip install -e ".[mcp]"。
git clone https://github.com/jundot/omlx.git
cd omlx
pip install -e .          # 仅核心
pip install -e ".[mcp]"   # 带 MCP 支持
要构建 GLM-5.2 / MiniMax M3 / Qwen3.5 的原生自定义内核(官方强烈建议服务这些系列时开启),用带环境变量的安装命令:
OMLX_WITH_CUSTOM_KERNEL=1 pip install -e .
pip install -e . 不会构建这些原生自定义内核,受影响的模型系列会静默回退到慢得多的通用路径。构建需要 Metal 工具链,仅装 Command Line Tools 会报 xcrun: error: unable to find utility "metal",必须装完整 Xcode,或直接用官方 DMG(内核已预编译)。Homebrew 的 --HEAD --with-custom-kernel 同样需要完整 Xcode。🧠 核心机制:分层 KV 缓存 + 连续批处理
Tiered KV Cache
理解 oMLX 为什么「好用」,要看它解决的是什么问题。作者在 README 开头的一段自述,把动机讲得很直白(原文为英文,此处保留关键句):他试过的每个 LLM 服务器都逼他在「方便」和「可控」之间二选一;他想把常用模型常驻内存、更重的模型按需换入、并且能设上下文上限,还全部在菜单栏管理。
他给出的答案是:oMLX 让 KV 缓存在热的内存层与冷的 SSD 层之间持久化——即使对话中途上下文发生变化,历史上下文仍然保持缓存、并跨请求复用,这让本地 LLM 配合 Claude Code 这类工具做真实编码工作变得可行。 换句话说,oMLX 的价值不在「让模型跑得更快一秒」,而在「让重复的上下文不必每次重算」。
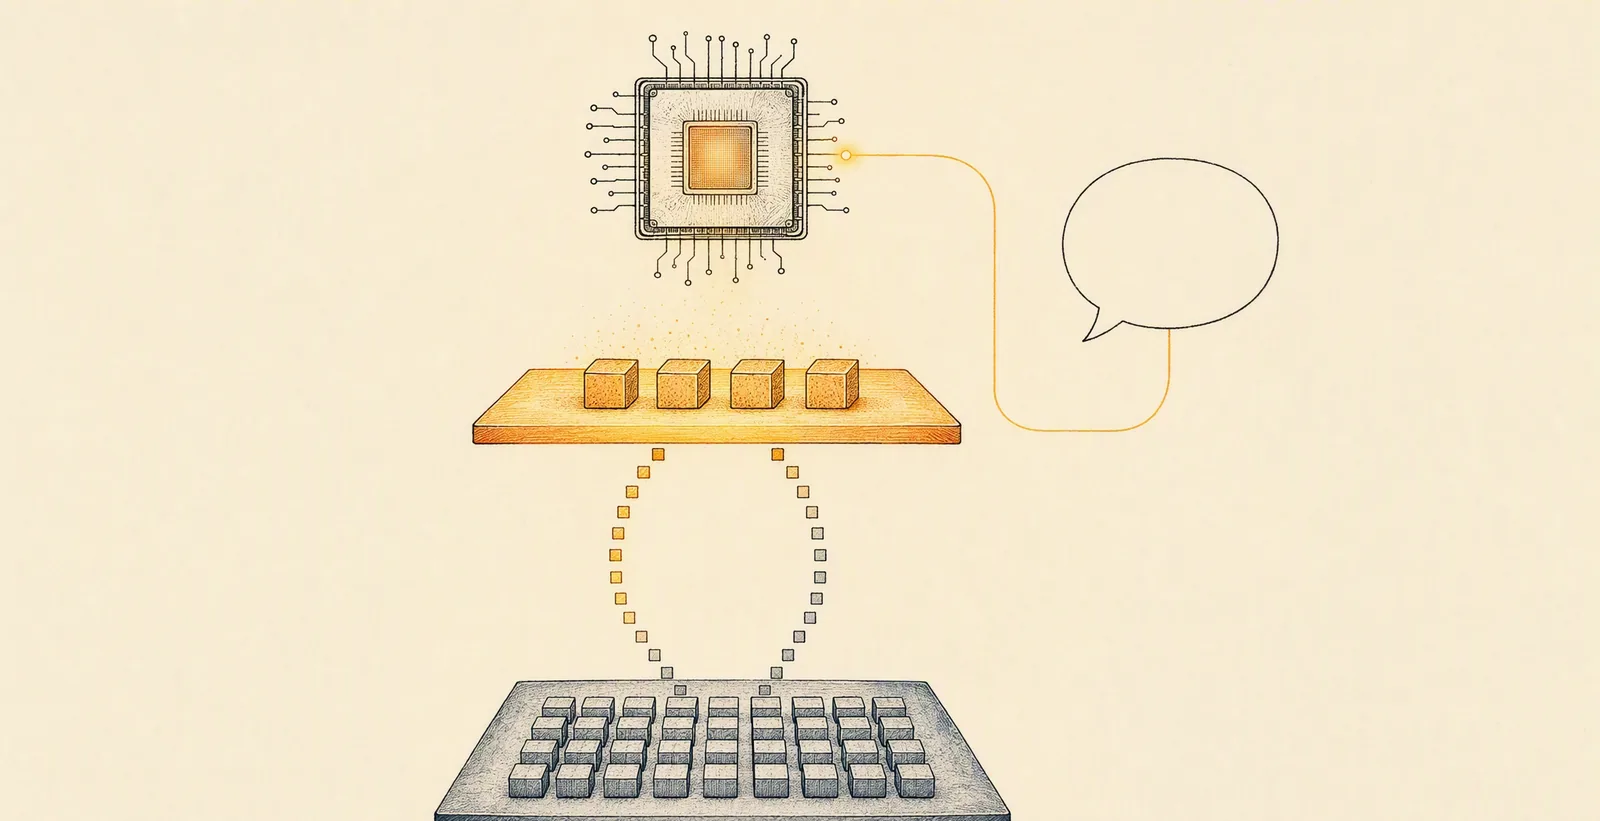
具体到实现,这套分层缓存借鉴了 vLLM 的思路,采用基于块(block-based)的 KV 缓存管理,支持前缀共享与写时复制(Copy-on-Write),分两层协作:
- 热层(RAM)——高频访问的缓存块留在内存里,读取最快。
- 冷层(SSD)——热缓存写满后,块以 safetensors 格式下沉到 SSD;下一次请求若前缀命中,直接从磁盘恢复,而不是从头重算——即便服务器重启后依然有效。
与分层缓存配套的是连续批处理:并发请求通过 mlx-lm 的 BatchGenerator 统一调度,最大并发数可在 CLI 或管理面板配置。两者叠加,才让「一台 Mac 常驻多个模型、边聊边复用」成为日常。
omlx serve --model-dir ~/models --paged-ssd-cache-dir ~/.omlx/cache;热层大小可用 --hot-cache-max-size 20% 调整。关于吞吐、时延的具体数字,README 的 Benchmarks 章节以官方发布为准,本文不引用或复述具体分数。🖥 三种运行形态
Run Modes
装好之后,oMLX 提供三种运行形态,覆盖从「点了就用」到「常驻后台」的不同需求。
- 菜单栏管理——原生 Swift / SwiftUI 菜单栏 App(非 Electron)。不打开终端就能启停、监控服务,附带本地用量历史、按小时热力图、跨重启常驻的服务统计、崩溃自动重启与内置自动更新。
- 前台附着终端运行——用
omlx serve --model-dir ~/models,进程直接跑在当前终端里,日志实时可见,适合调试与首次体验。 - 托管后台服务——用
omlx start/omlx stop/omlx restart作为可移植的生命周期命令;Homebrew 安装会把它委托给brew services,崩溃自动重启。
后台服务默认零配置运行:模型目录 ~/.omlx/models、端口 8000。日志分两处:服务日志在 $(brew --prefix)/var/log/omlx.log(stdout/stderr),结构化服务器日志在 ~/.omlx/logs/server.log。想自定义,设环境变量(如 OMLX_MODEL_DIR、OMLX_PORT),或先手动跑一次 omlx serve --model-dir /your/path 把设置持久化到 ~/.omlx/settings.json。
http://localhost:8000/v1;内置聊天界面在 http://localhost:8000/admin/chat。🧩 能力全景
Features
除了缓存与调度这条主线,README 的 Features 章节还列出了一批配套能力。以下择要介绍,均为官方已写明的功能。
Web 管理台位于 /admin,实时监看、模型管理、聊天、跑分、逐模型设置一应俱全;支持中/英/日/韩等多语言,所有 CDN 依赖本地内置,可完全离线运行。
实验性功能:源码构建可把单个模型拆分到内存不等的多台 Mac,经 MLX pipeline ranks 走 Ring 或 Thunderbolt RDMA 协同推理,并有 Cluster 面板管理分片与性能图。仍属实验阶段,需按官方清单验证硬件。
VLM 与文本 LLM 共用同一套连续批处理与分层缓存栈,支持多图对话、base64/URL/文件图片输入、带视觉上下文的工具调用;OCR 模型(DeepSeek-OCR、DOTS-OCR、GLM-OCR)可自动识别并用优化提示词处理。
同一服务里加载 LLM、VLM、embedding、reranker,靠 LRU 自动淘汰、手动装卸、模型钉选、逐模型 TTL 与进程内存上限(默认系统内存 − 8GB)组合管理,防止全局 OOM。
在后台逐模型配置采样参数、chat template kwargs、TTL、别名、类型覆盖等,改动即时生效、无需重启;还可用「Profiles」把一组设置存成命名档,以 <model>:<profile> 形式当作独立模型暴露。
面向小上下文模型跑 Claude Code 的场景做上下文缩放:调整上报 token 数以让自动压缩在正确时机触发,并用 SSE keep-alive 防止长 prefill 期间的读取超时。
API 层是 OpenAI 与 Anthropic 的即插即用替代,主要端点如下:
| 端点 | 能力 | 说明 |
|---|---|---|
| POST /v1/chat/completions | Chat 补全 | 支持流式 |
| POST /v1/completions | 文本补全 | 支持流式 |
| POST /v1/messages | Anthropic Messages | 兼容 Claude 生态 |
| POST /v1/embeddings | 文本向量化 | embedding 模型 |
| POST /v1/rerank | 文档重排 | reranker 模型 |
| GET /v1/models | 模型列表 | 返回别名与目录名 |
* 端点与能力均取自 README「API Compatibility」章节;工具调用与结构化输出也受支持,需模型的 chat template 接受 tools 参数。
✅ 验证与排错
Verification
装完别急着用,先花两分钟确认关键能力真的到位,尤其是那个会「静默回退」的自定义内核坑。
- 确认服务在跑——浏览器打开
http://localhost:8000/admin能看到后台,或连http://localhost:8000/v1有 OpenAI 兼容响应,即说明加载成功。 - 验证内核是否构建——若你服务 GLM-5.2 / MiniMax M3 / Qwen3.5,用下面这行核对原生内核状态。
python -c "from omlx.custom_kernels import native_kernel_status; print(native_kernel_status())"
pip install -e . 就直接服务 GLM-5.2 等模型,功能照样「能出结果」,但走的是慢得多的通用回退路径,且更占内存。README 举例:官方称 GLM-5.2 的 fused DSA prefill 在启用内核时约快 30 倍(此为内核回退的对比,非整体跑分,最终以官方 Benchmarks 为准)。解法是装完整 Xcode 后带 --with-custom-kernel 构建,或直接使用已预编译内核的官方 DMG。🛡 常见问题解答
FAQ
Q1:oMLX 能在 Intel Mac 或 Windows/Linux 上用吗?
不能。oMLX 明确只支持 Apple Silicon(M1/M2/M3/M4/M5)且要求 macOS 15.0 及以上(Sequoia),Python 需在 3.11–3.13 之间。
Q2:三种安装方式该怎么选?
只想点图标就用、要菜单栏体验,选 macOS 应用(还自带自动更新与 CLI 垫片);想在命令行常驻后台服务,选 Homebrew;需要改源码或二次开发,走源码安装。
Q3:它到底「快」在哪?
核心不是单请求更快,而是 KV 缓存在内存热层与 SSD 冷层之间持久化:历史上下文跨请求、甚至跨重启复用,重复前缀不必重算。这也是本地模型能配合 Claude Code 这类工具做真实编码任务的关键。
Q4:服务 GLM-5.2 / MiniMax M3 / Qwen3.5 时为什么感觉特别慢?
多半是原生自定义内核没被构建。普通 pip install -e . 不会构建它们,模型会静默回退到慢得多的通用路径。用带 OMLX_WITH_CUSTOM_KERNEL=1 或 Homebrew --HEAD --with-custom-kernel 重建,或直接用官方 DMG;两者都需完整 Xcode。
Q5:多台 Mac 协同推理可靠吗?
官方把 Multi-Mac Inference 标为实验性(Experimental):源码构建可把模型拆分到内存不等的多台 Mac,但需按官方分布式文档做硬件验证,存在安全边界与限制,尚不宜当作稳定生产特性。
Q6:有官方性能数据吗?协议是什么?
README 链接了 omlx.ai 的 Benchmarks 页,具体吞吐请以官方为准,本文不复述分数。项目采用 Apache-2.0 协议开源,仓库位于 github.com/jundot/omlx。
◆ 项目信息
官网/文档:omlx.ai(含 Benchmarks 页)
最快上手:从 Releases 下载
.dmg 拖进 Applications,或 brew tap jundot/omlx https://github.com/jundot/omlx → brew install jundot/omlx/omlx → omlx start







