
 AI智汇具 - AI工具推荐与技能教程_好用的AI工具大全
OpenViking:统一 Agent 记忆、RAG 与技能的上下文数据库
AI Agent 的自演化上下文数据库,把记忆、知识与技能统一到一个虚拟文件系统。
2.9K Forks
Python
AGPL-3.0
Unify Memory · RAG · Skills
OpenViking 是字节跳动火山引擎开源的 AI Agent 上下文数据库(context database),把知识、用户记忆与技能统一编排在一个名为「viking://」的虚拟文件系统里。它用三层按需加载(摘要 / 概览 / 全文)和目录感知检索,让智能体像操作文件一样读写上下文,并能把一次会话自动沉淀为长期记忆。项目提供 Python、Go、TypeScript SDK 与 HTTP API,并通过 Hooks + MCP 原生接入 Claude Code、Codex、Cursor 等主流 Agent。本文覆盖它的定位、核心能力、安装使用、架构机制、对比与常见问题。
一、产品深度介绍
(一)它是什么
OpenViking 是一个开源的 AI Agent 上下文数据库。它给智能体一个统一的地方来存储知识、记住用户,并在多次会话之间复用经验。官方把它的定位概括为「AI Agent 的自演化上下文数据库,统一 Agent 记忆、知识 RAG 与技能」。
它的核心抽象是把上下文组织成一个位于「viking://」下的虚拟文件系统。智能体可以像操作文件一样使用 ls、tree、read、write 来浏览目录、读取、创建与编辑内容,或在目录内检索;目录摘要支持按需加载。换句话说,记忆、知识与技能都被抽象成同构的资源,用统一的 URI 寻址。
(二)技术表现
- 统一的虚拟文件系统:资源(resources)保存文档与代码,记忆(memories)保留用户偏好与经验,技能(skills)定义如何完成任务;三者各自拥有「viking://」URI 供浏览与检索。
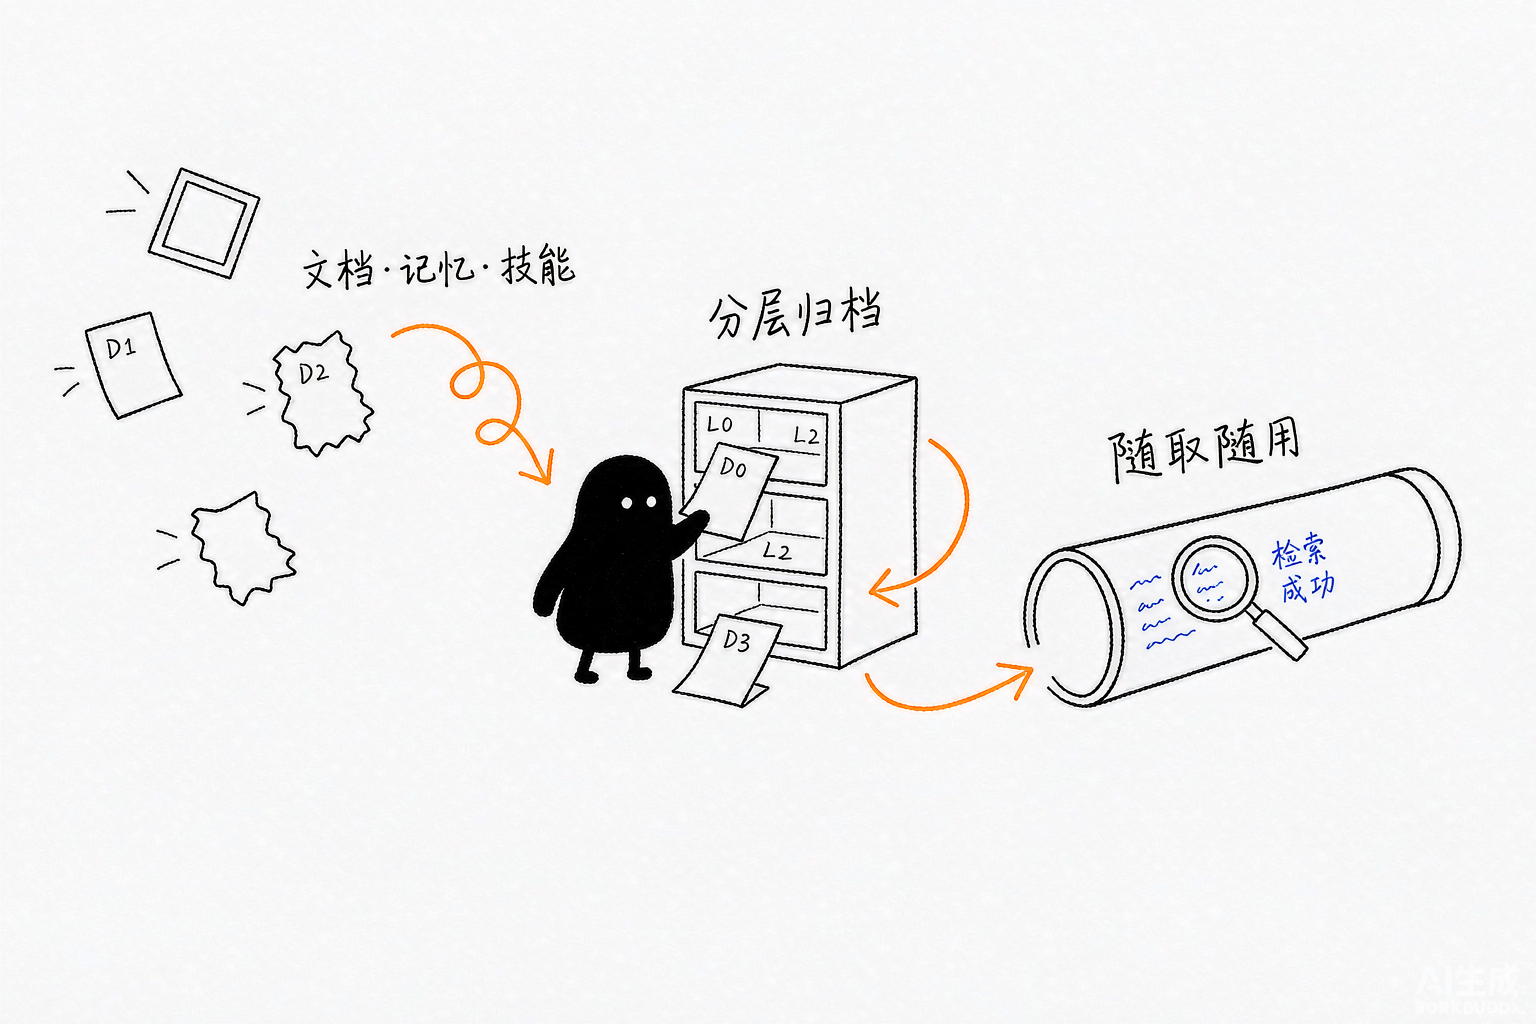
- 三层按需加载:L0 摘要用一句话做相关性初判,L1 概览给出结构与要点用于规划,L2 细节才是完整原文,仅在必要时读取,显著降低上下文开销。
- 目录感知检索:向量检索先定位候选目录,再展开其内容;find 直接执行查询,search 还能结合会话上下文来规划召回。
- 会话沉淀为记忆:提交一次会话会归档对话并触发后台抽取,记忆策略控制保留粒度,新候选会与既有记忆比对,决定创建、合并还是跳过。
- 多语言 SDK:提供 Python、Go、TypeScript SDK 与 HTTP API,便于自建集成。
- 多 Agent 原生集成:通过 Hooks + MCP 接入 Claude Code、Codex、Cursor、TRAE、OpenClaw、Hermes、OpenCode、LangChain 等。
二、主要功能特点与应用场景
OpenViking 的能力可以归纳成三条主线。其一是「三类上下文同构」:resources 承载项目文档、仓库与网页,memories 承载用户偏好与历史经验,skills 承载任务执行方式,三者用同一套文件系统语义管理。其二是「目录感知检索」:智能体可以针对某个项目或某段记忆子树做范围检索,并保留其周围上下文。其三是「会话到记忆的闭环」:开启 VikingBot 后,ov compile 还能用技能把素材整理成 wiki、知识图谱或报告。
典型应用场景包括:给长期运行的 coding agent 提供跨会话的用户与项目记忆;把团队文档、代码仓库与网页沉淀为可检索的知识库(RAG);用 VikingBot 搭建对话式知识助手;以及作为多 Agent 系统的共享上下文底座。研究论文 VikingMem、Directory-Aware Query 与 VikingRAG 为其目录感知检索与记忆机制提供了形式化基础与实验证据。
三、如何安装与使用
OpenViking 要求 Python 3.10+,并需要能够访问一个 embedding 模型和一个 VLM(云端或本地均可)。支持的模型供应商包括 Volcengine、OpenAI、Codex OAuth、Kimi、GLM 以及本地 Ollama。核心服务通过 pip 安装:
pip install openviking --upgrade
openviking-server init      # 配置 providers 与 models,写入 ~/.openviking/ov.conf
openviking-server doctor    # 检查配置与连通性
openviking-server           # 启动服务
如果希望启用对话式 VikingBot,安装时带上 bot 额外依赖,并以 –with-bot 启动:
pip install "openviking[bot]"
openviking-server --with-bot
ov chat   # 在另一个终端进入对话
服务就绪后,可以用命令行把素材接入并按文件系统方式检索:
ov status
ov add-resource https://github.com/volcengine/OpenViking
ov task status TASK_ID      # 用返回的 task_id 轮询,直到状态为 completed
ov ls viking://resources/
ov tree viking://resources/volcengine -L 2
ov find "what is openviking"
ov grep "openviking" --uri viking://resources/volcengine/OpenViking/docs/en
ov find 会返回命中上下文及其 URI 供进一步查看;客户端配置、独立 CLI 安装与索引维护可参考官方 CLI setup 文档。
四、官方地址与获取方式
- GitHub 仓库:https://github.com/volcengine/OpenViking
- 官方文档:https://docs.openviking.ai
- 桌面端(Beta):提供 macOS 与 Windows x64 下载,适合不想自建服务的个人用户。
- 商业版本:提供 Managed SaaS 与 Self-Managed 两种交付,详见仓库 Commercial editions 章节。
五、与同类方案对比
| 对比维度 | OpenViking | 传统向量数据库 | 通用 RAG 框架 | 记忆插件 |
|---|---|---|---|---|
| 上下文建模 | viking:// 文件系统,资源/记忆/技能同构 | 多为扁平向量集合 | 文档切块 + 索引 | 单一对话历史 |
| 检索方式 | 目录感知,先定位目录再展开 | 全局向量召回 | 向量召回 + 重排 | 最近消息窗口 |
| 记忆/经验沉淀 | 会话提交后后台抽取并合并记忆 | 不涉及 | 需自建 | 简单追加 |
| Agent 集成 | Hooks + MCP 原生接入多 Agent | 需自行封装 | 部分支持 | 通常绑定单一平台 |
| License | 主项目 AGPL-3.0 | 各异 | 各异 | 各异 |
六、核心机制深度解析
OpenViking 的底座是一个「viking://」虚拟文件系统。顶层通常分为 resources(项目文档、仓库、网页等)与 user(按用户隔离的记忆、私有资源、技能与 peers)。每段目录会被自动抽取出三层语义结构:.abstract.md(L0)、.overview.md(L1)与底层原文(L2),分别服务于快速相关性判断、规划与按需读取。
检索环节集成了来自研究论文的 TrieHI 索引,在向量排序之前先解析目录作用域,从而把「文件系统范式」与「检索」连接起来:智能体可以搜索某个项目或记忆子树,保留其周围上下文,并随知识演化重新组织。会话沉淀由记忆策略驱动,候选记忆会与既有记忆比对,决定新建、合并或跳过。
七、实用技巧
- 先自检再启动:每次改完配置跑一次 openviking-server doctor,可提前发现 provider 与连通性问题。
- 按需加载省 token:优先读 L0 / L1 摘要做判断,只有真正相关时才读取 L2 全文,控制上下文体积。
- 调好记忆策略:通过 memory policies 控制保存粒度,避免把噪声也写进长期记忆。
- 混用云与本地模型:embedding 与 VLM 不必同源,本地 Ollama 也能作为供应商之一。
- 让 Agent 自动取上下文:用 Hooks + MCP 把 OpenViking 接入 Claude Code、Cursor 等,使其在编码时自动检索项目记忆与技能。
八、最新更新动态
研究底座持续完善:VikingMem、Directory-Aware Query、VikingRAG 三篇论文给出了目录感知检索的形式化基础、索引设计与实验证据,TrieHI 已被集成进检索路径。
- 桌面端(Beta):发布 macOS 与 Windows x64 客户端,降低非服务端用户的使用门槛。
- 生产部署能力:支持自托管 + 账户隔离 + ACL + 认证;同时提供商业版 Managed SaaS 与 Self-Managed。
- 通用集成:新增 Agent Plugins 1.0 与 MCP 客户端接入方式,覆盖更多 harness。
- 基准验证:官方在 README 中以 LoCoMo 与 tau2-bench 等基准展示其记忆与检索效果。
九、常见问题 FAQ
Q1:需要怎样的运行环境?
需要 Python 3.10+,并能够访问一个 embedding 模型和一个 VLM,云端或本地 Ollama 均可;支持的供应商包括 Volcengine、OpenAI、Codex OAuth、Kimi、GLM 等。
Q2:它和传统向量数据库有什么不同?
它不是单纯的向量库,而是以「viking://」文件系统组织上下文,并提供目录感知检索与记忆沉淀。向量检索只是其中一层,真正的差异在于上下文建模与跨会话经验复用。
Q3:支持哪些 Agent 框架?
原生支持 Claude Code、Codex、Cursor、TRAE、OpenClaw、Hermes、OpenCode、LangChain 等,主要通过 Hooks + MCP 或 MCP 客户端接入;也提供 Agent Plugins 1.0 通用集成。
Q4:可以商用吗?
主项目采用 AGPL-3.0;若需脱离 AGPL 约束的商用部署,仓库提供商业版本(Managed SaaS / Self-Managed),使用前请阅读 LICENSE 与商业版说明。
Q5:数据存在哪里、是否隔离?
自托管部署时配置写入 ~/.openviking/ov.conf;生产部署支持账户隔离与 ACL,不同用户与项目的上下文相互隔离。
十、总结
OpenViking 想解决的不是「再做一个向量库」,而是把 Agent 的记忆、知识与技能统一进一套可寻址、可检索、可演化的上下文底座。它用「viking://」虚拟文件系统把三类上下文同构管理,用三层按需加载和目录感知检索控制上下文成本,再用会话到记忆的闭环让经验跨会话累积。对正在构建长期运行 Agent、团队知识库或对话式助手的开发者而言,这是一个值得关注的开源基础设施;配合 VikingBot 与多 Agent 原生集成,它已经能作为真实工作流里的共享记忆层使用。
主项目采用 AGPL-3.0 协议,自托管与二次分发需遵守其条款;其中 crates/ov_cli 与 examples 为 Apache 2.0,third_party 沿用各自原始协议。商用请考虑官方商业版本,并留意模型供应商的服务条款与数据合规要求。
在撰写本文的过程中,我主要参考了 OpenViking GitHub 仓库(volcengine/OpenViking)的 README.md、官方文档 docs.openviking.ai、LICENSE,以及三篇研究论文(VikingMem / Directory-Aware Query / VikingRAG)。文中数据以官方公开信息为准,可能随版本更新而变化。
本文由 AI 辅助整理,基于 OpenViking(volcengine/OpenViking)的公开文档撰写;配图由 小黑 IP 生成。内容仅用于技术介绍,不构成商业使用授权建议。







