
 AI智汇具 - AI工具推荐与技能教程_好用的AI工具大全
SKILL 清单
研发自动化
CI/CD
开源方案
摘要
这篇文章整理 10 个研发场景里最值得配的 AI SKILL,分成开发测试、数据处理、发布运维三类:Agent Swarm、Playwright Scout、Terminal Sense、CI Fixer、Screenshot QA、Data Cleaner、Changelog Miner、Dependency Guard、Release Notes、Nightly Runner。需要说明一点:这 10 个名字是「能力位」而不是某个具体仓库——同样的能力,社区里已经存在多个成熟实现。因此本文对每一项都给出一个已核实、可直接上手的真实开源方案(含 Stars 与协议),以及真实可跑的命令;名字是壳,能力是核,落地看的是后者。每个能力配一张插图,最后附一张总表和一份风险边界清单。
一、先说清楚:这 10 个 SKILL 到底是什么
在 AI 编程工具里,SKILL 是一个很具体的工程概念:一个文件夹,里面有一份 SKILL.md 写明「做什么、什么时候用、按什么流程做」,可选再带脚本、模板和参考资料。Agent 启动时只读元数据,判断要不要激活;激活后才按需加载正文与资源。这套「渐进式披露」的设计,让技能包不必一次性塞进上下文,也因此才有了「一个人可以同时装几十个技能」的可行性。
但这里有个现实问题:同一个能力位,不同团队给的名字天差地别。有人叫 Agent Swarm,有人叫 subagent orchestration,有人直接在 README 里写「parallel agents」;有人叫 Screenshot QA,有人叫 visual regression。名字不统一,讨论就没法落地。所以这篇文章采取的办法是——把名字当作能力位,每个能力位下面挂一个已经被验证过的真实方案,连同它的 Stars、协议和真实命令一起给出。这样你读完得到的不是十个名词,而是十条可以今天就试的路径。
判断标准有三条:一是这个方案解决的是不是同一件事(不是「沾边」);二是它是否仍在维护、能拿到源码;三是它有没有可以在本地跑起来的最小路径。三条都满足才写进来。下文所有 Stars 数据取自 2026-09-20 的仓库快照,仅供横向参考。
二、开发测试类:把「点点点」和「等流水线」交出去
开发测试环节的重复劳动有两个典型形态:一是排队等待,二是机械操作。下面的五个能力位,攻击的正是这两件事。
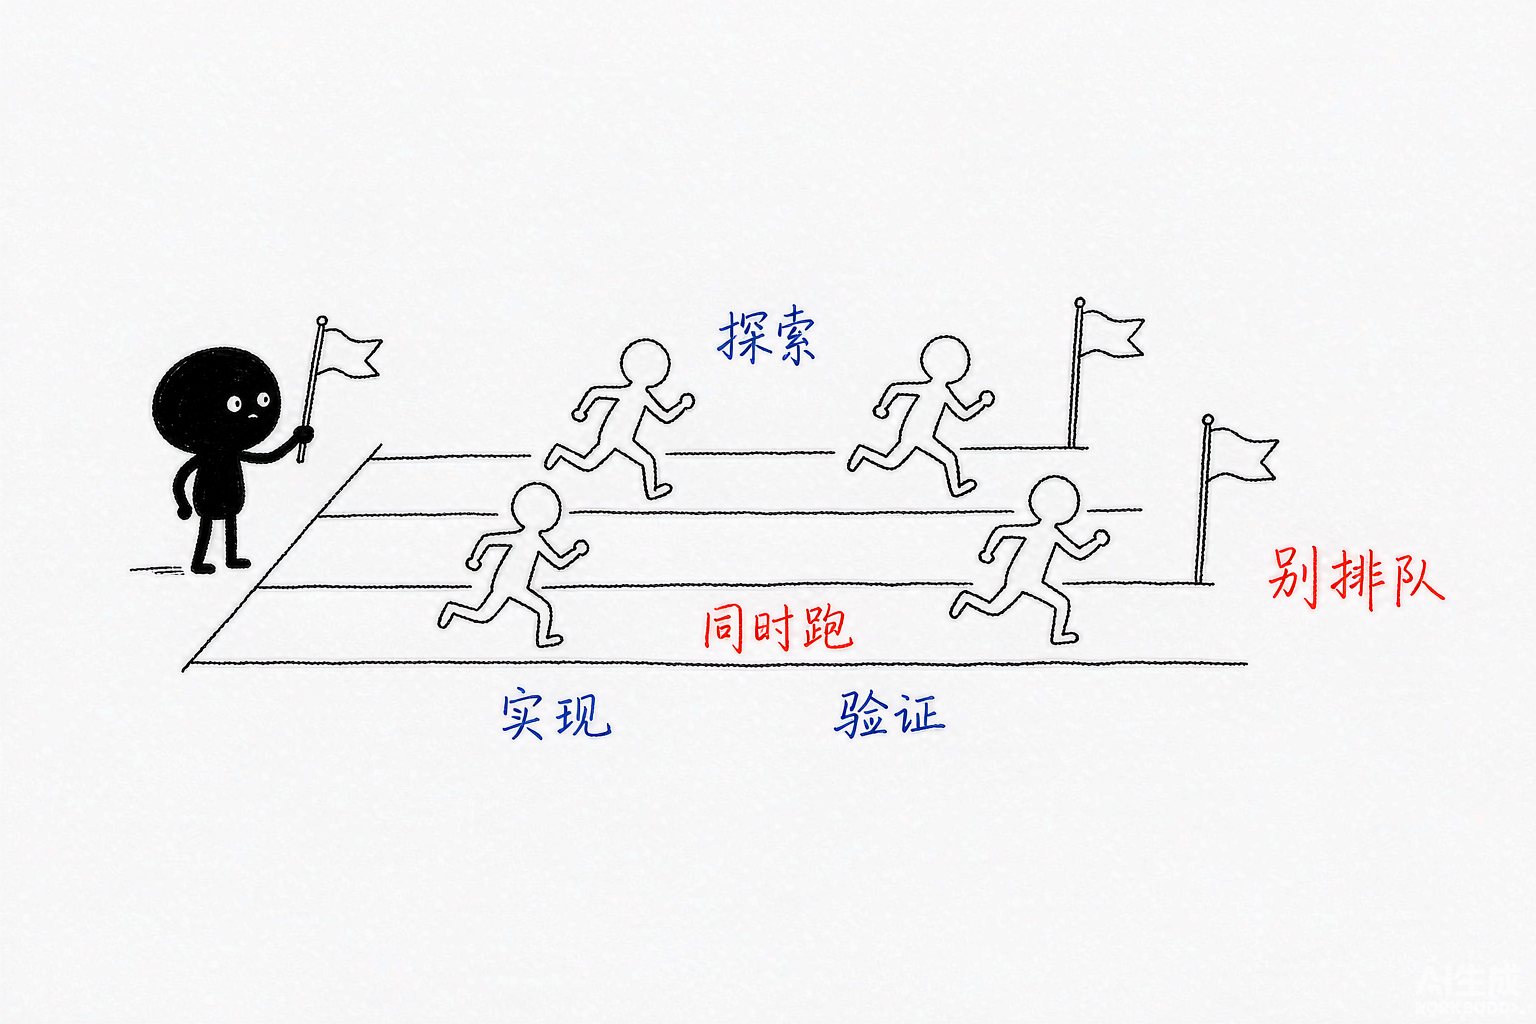
2.1 Agent Swarm——多个 AI 并行分工,探索、实现、验证一起跑
这是原文里那句「效率翻倍」的真实来源:一个任务如果按「先探索、再实现、最后验证」串行做,三分之二的时间花在等待上;拆成三条线同时推进,总时长取决于最慢的那条,而不是三条之和。关键在于三条线必须共享同一份结论——探索线的调研结果要能直接喂给实现线,验证线的失败要能回写给实现线,否则并行只会制造三份互相矛盾的工作。
对应真实方案:obra/superpowers(288,985 Stars,MIT)是一套以子代理驱动开发的技能框架,明确要求「先出规格、再写可执行计划、强制红绿 TDD」;wshobson/agents(39,826 Stars,MIT)则提供多角色 agent 的编排示例。更轻量的做法是直接用宿主自带的子代理能力:把探索任务派给一个只读代理,让它回传精简结论,主上下文只保留决策所需的那一小段。
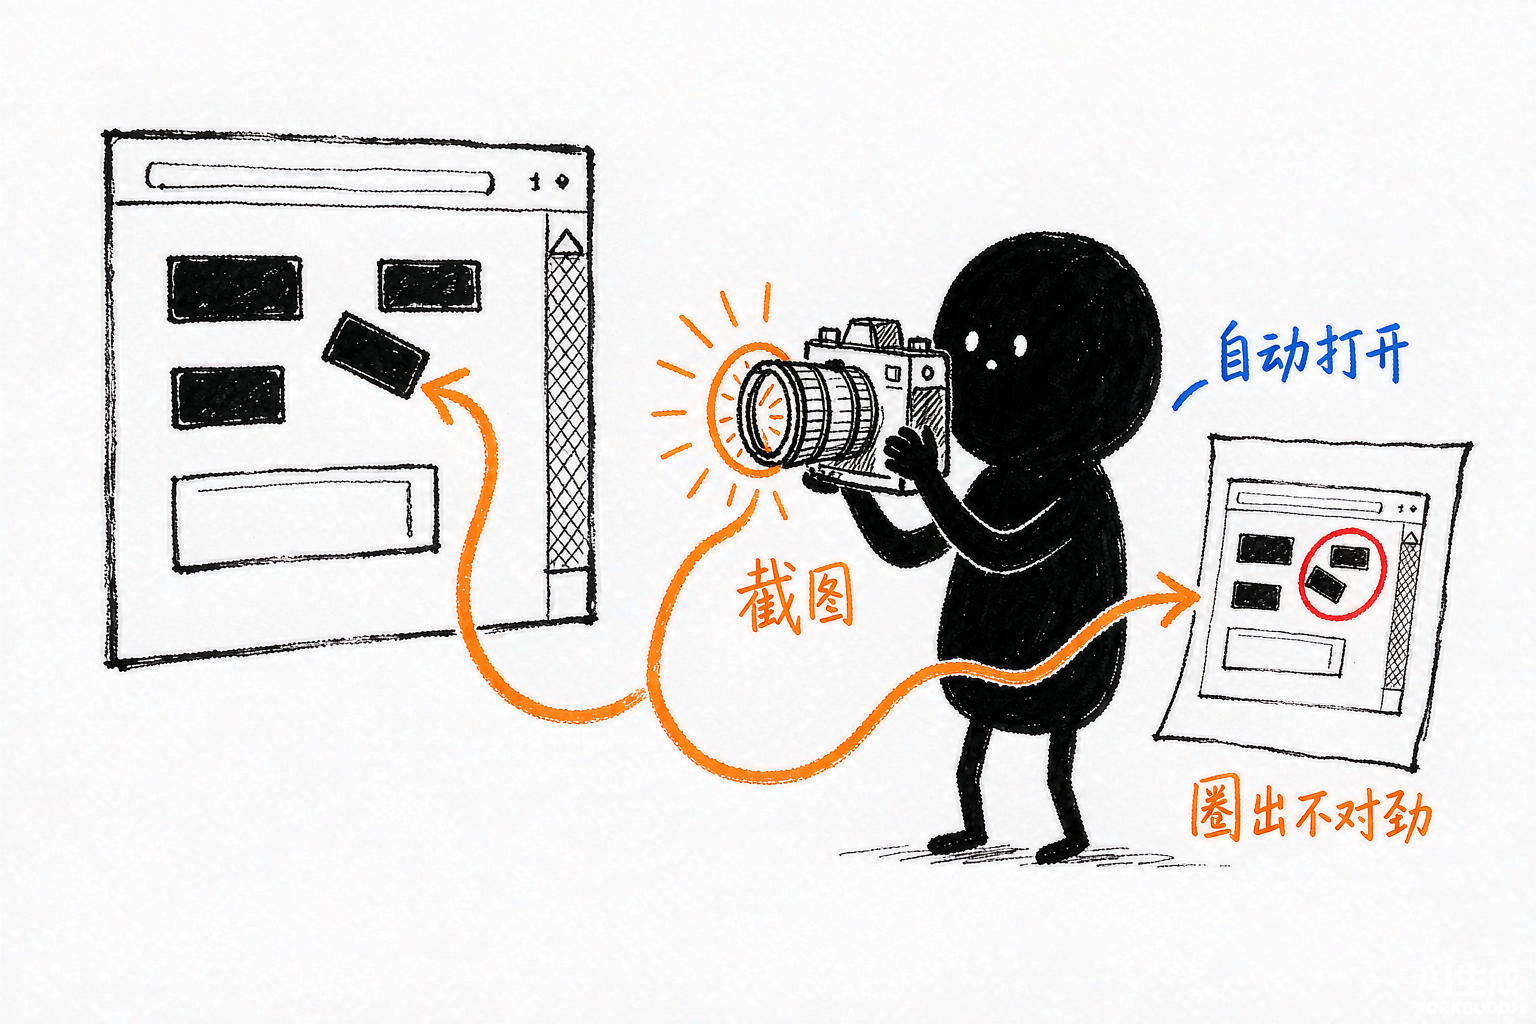
2.2 Playwright Scout——自动打开网页、截图、定位 UI 问题
「不用手动点点点」这句话的价值,不在于省下点击的力气,而在于把「我点了一遍没问题」变成「每次改动都点一遍并且留了证据」。文字描述 UI 问题是低效的:一句「登录按钮好像错位了」,实现者要在脑子里重建半天;一张圈出问题位置的截图,沟通成本接近于零。
对应真实方案:lackeyjb/playwright-skill(3,129 Stars,MIT)是专为编码 Agent 做的浏览器自动化技能,工作方式是「Agent 写 Playwright 代码 → 通用执行器运行 → 回传截图与控制台输出」,默认有头运行便于观察。底层能力来自 microsoft/playwright(96,394 Stars,Apache-2.0);如果只需要驱动浏览器而不写测试,vercel-labs/agent-browser(42,904 Stars,Apache-2.0)这类 CLI 更轻。
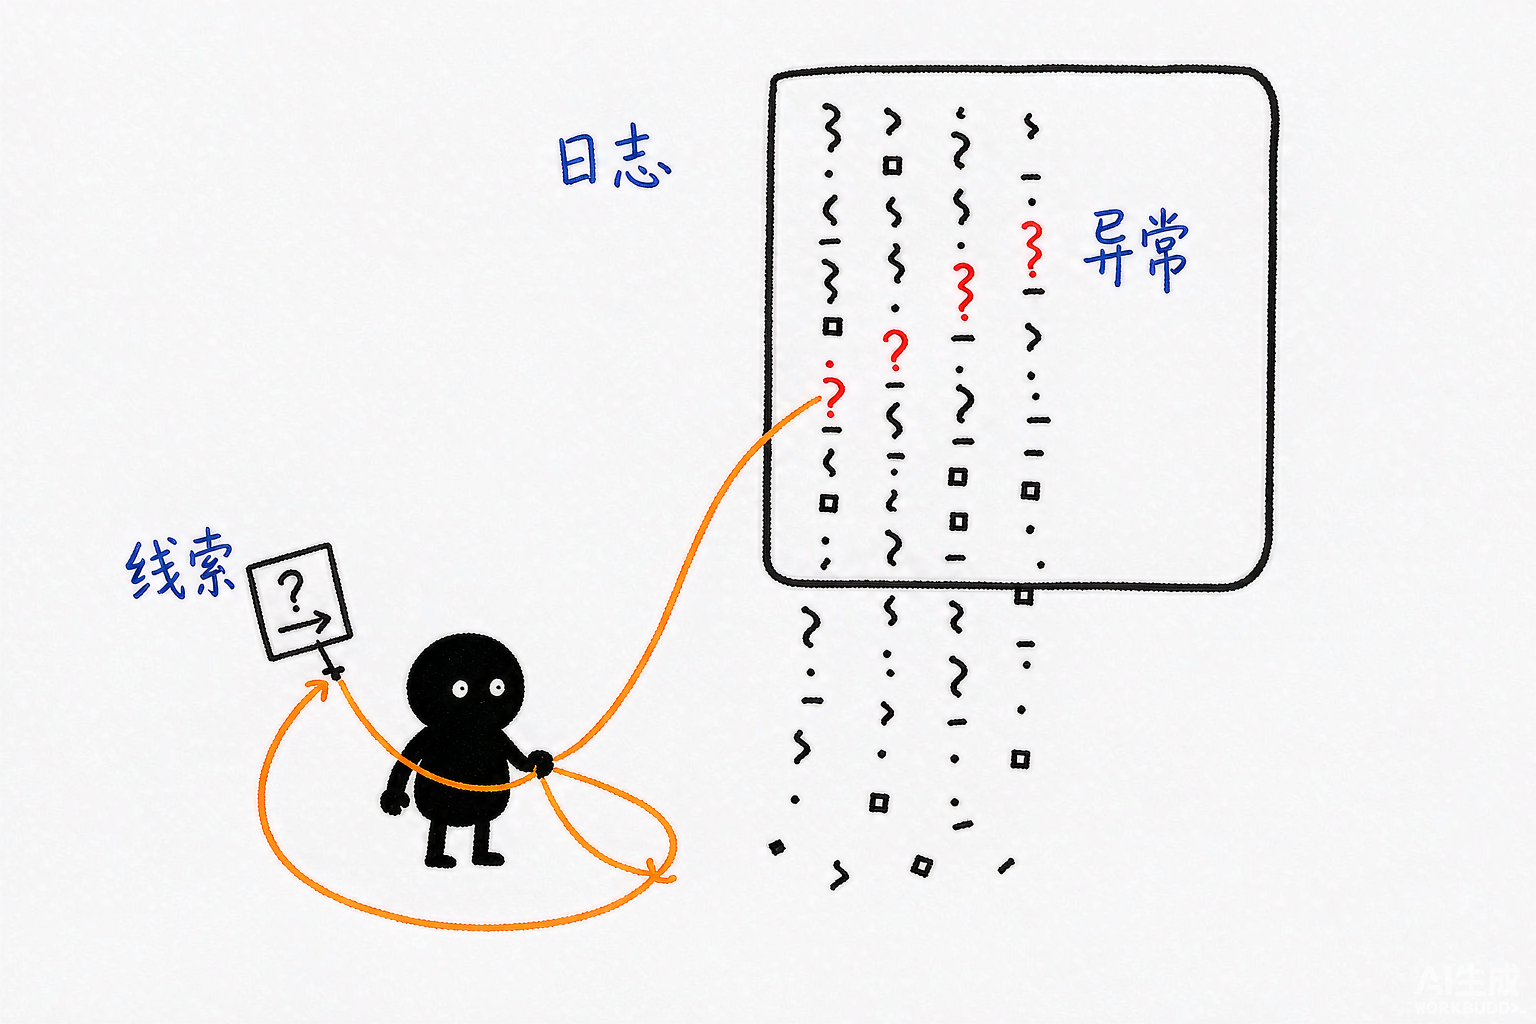
2.3 Terminal Sense——读日志、跑命令,把异常翻译成线索
日志的问题从来不是「没有信息」,而是信息太多。一次失败的构建动辄几千行输出,其中真正有用的可能只有三行。这个能力位的实质是「降噪 + 串联」:从噪声里挑出真正的异常,再把它和上下文(哪次提交、哪个步骤、什么参数)串成一条可以追的线。
对应真实方案:最实用的不是某个仓库,而是 GitHub CLI(46,336 Stars,MIT)里那条被严重低估的子命令:gh run view <run-id> --log-failed,它只打印失败步骤的日志,天然完成了一半降噪。剩下的一半交给 Agent:让它把失败日志与最近的提交列表对照,输出「最可能相关的三个改动」。
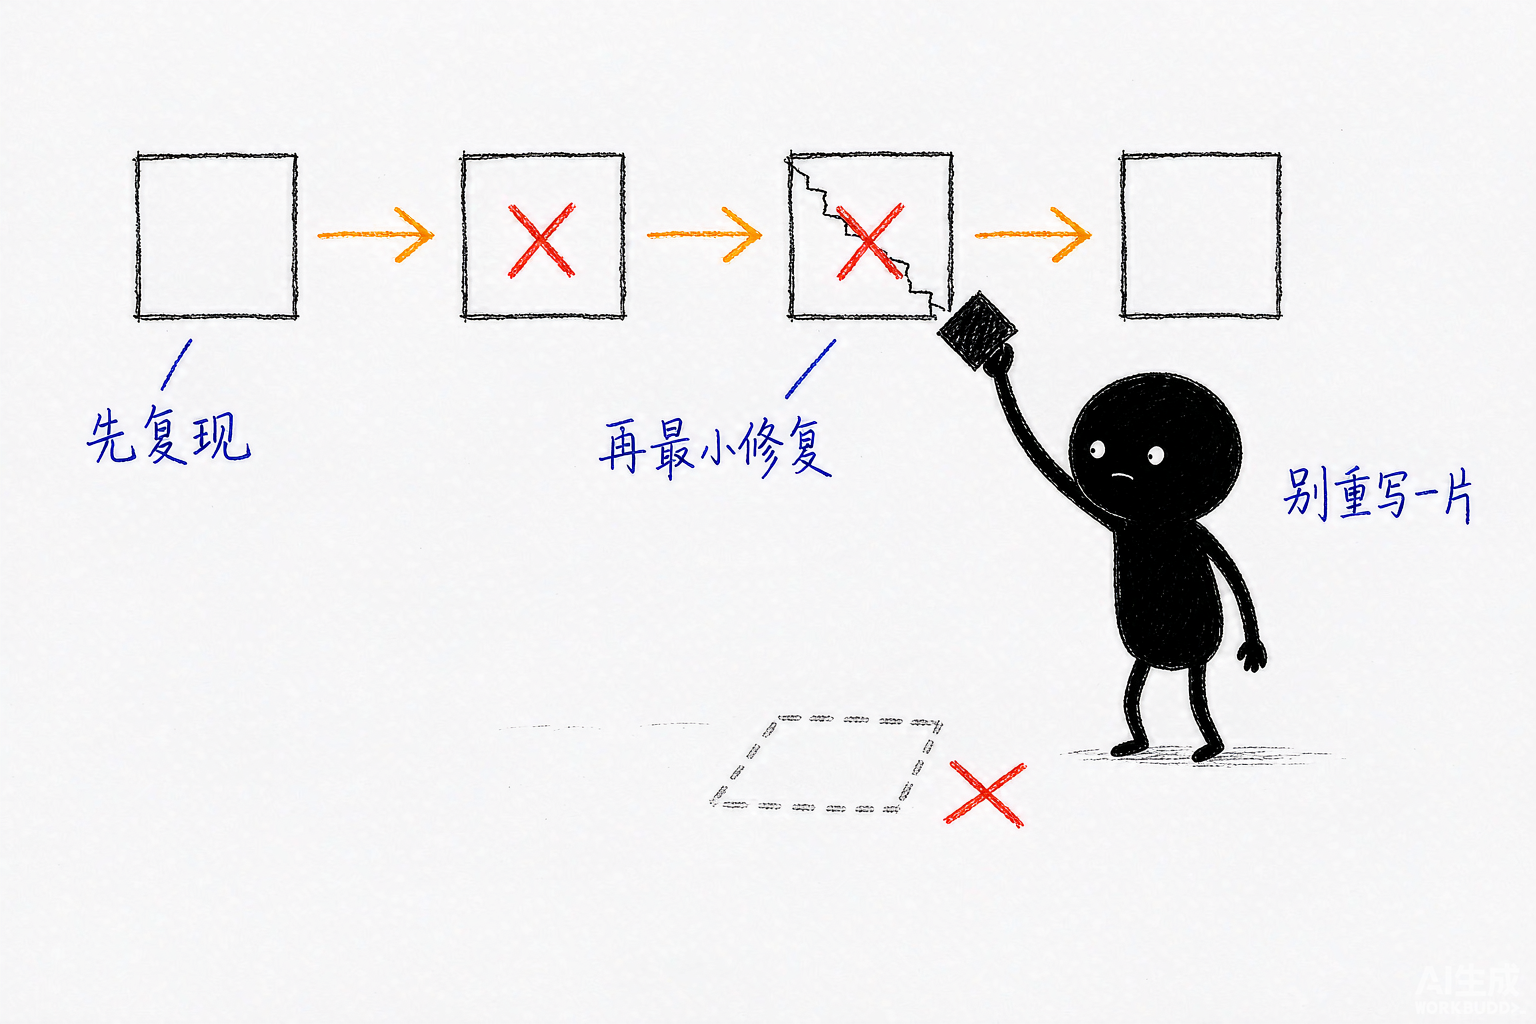
2.4 CI Fixer——流水线失败了?先复现,再补最小修复
流水线挂掉时最诱人的动作是「直接把报错那行删了」,最贵的动作是「顺手重构一大片」。这个能力位的纪律恰恰在两头之间:先复现,再最小修复。复现意味着把失败变成一个可重复触发的事实,而不是一条偶然的红色日志;最小修复意味着改动范围刚好覆盖根因,让 diff 小到可以被审阅。
对应真实方案:流程侧靠 gh run list 定位失败运行、gh run view --log-failed 取失败步骤、gh run watch 观察重跑;配合「每次修复单独开一个分支」的纪律,复现与修复就能各自留下记录。工具层面没有银弹,约束在流程里——这也是为什么这个能力位值得显式写进团队规范,而不是靠 Agent 自觉。
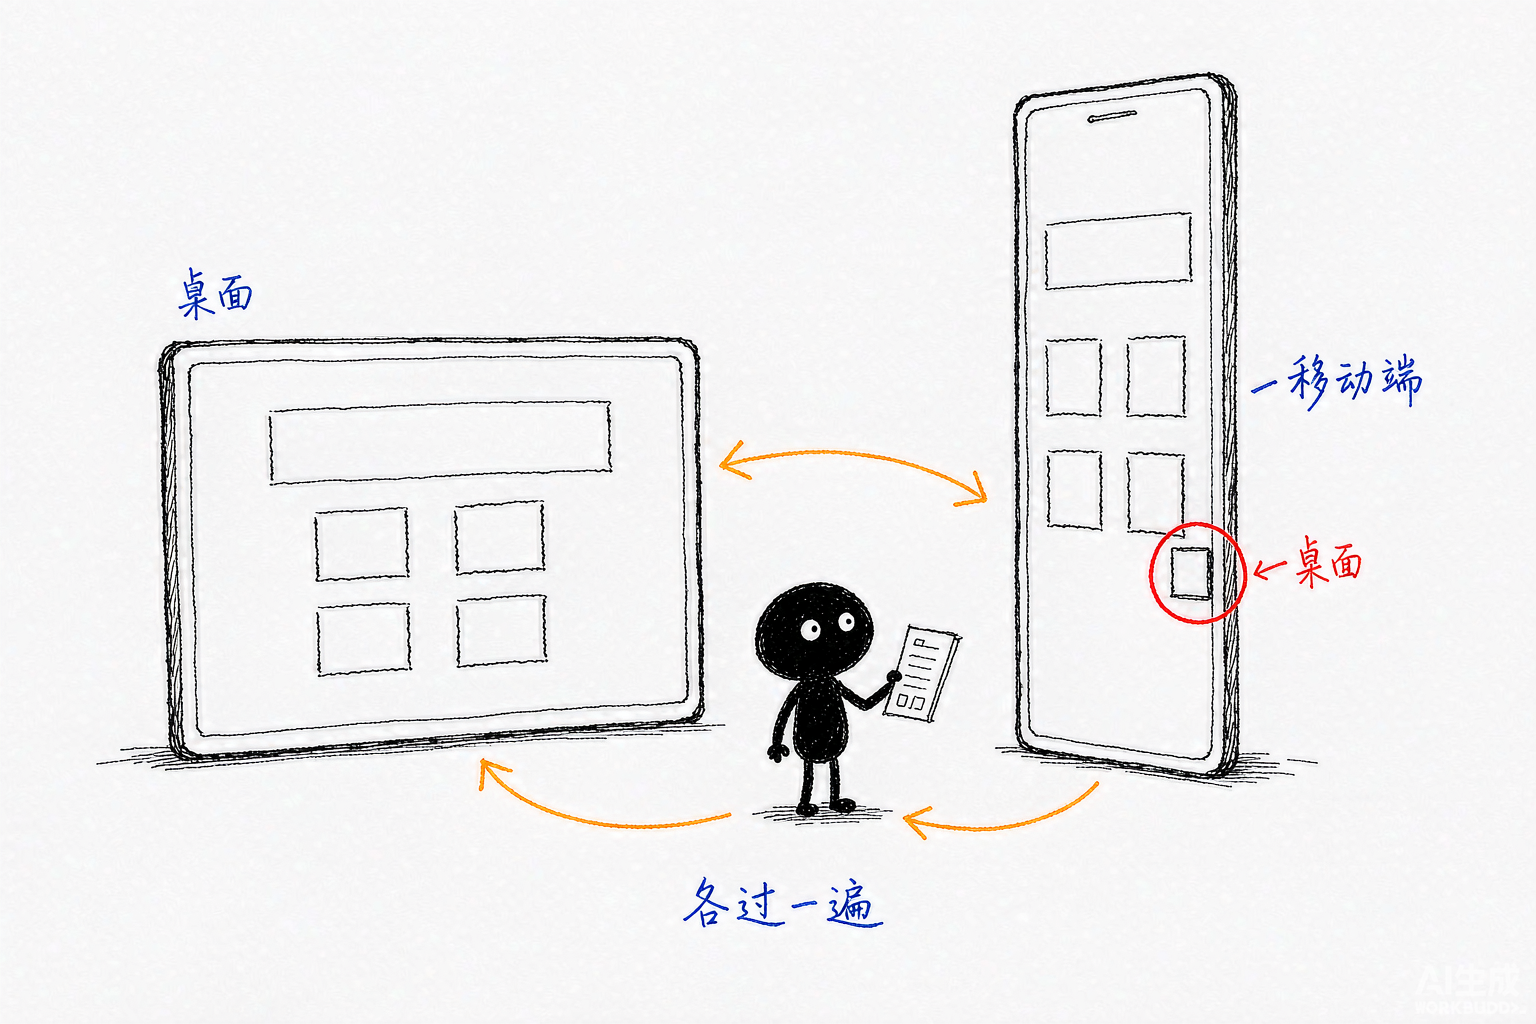
2.5 Screenshot QA——桌面和移动端自动过一遍视觉检查
功能测试全绿但页面在手机上挤成一团的例子,现实中比比皆是:断点写错、按钮溢出、长文案撑破容器——这些都不是断言能抓到的,只能靠看。视觉回归的价值在于把「看」变成可重复的比对:存一张基线图,之后每次改动都自动比一遍,差异超过阈值就报警。
对应真实方案:Playwright 原生的 toHaveScreenshot() 就是为这件事设计的,配合多 viewport 项目配置即可覆盖桌面与移动端;官方文档里同步给出了差异阈值、动态内容遮罩与动画处理的做法。首次运行会生成基线,之后基线更新需要显式确认——这个「人工确认」环节不要省,它是防止把 bug 固化成基线的唯一闸门。
三、数据处理类:把重复的清洗与核对交给它
数据类任务的共同特征是「规则明确、量很大、错一次很难查」。这类活最适合自动化,但也最忌讳「黑箱处理」——每一步都要能看到前后差异。
3.1 Data Cleaner——CSV、Excel、JSON 批量清洗,不手抖不出错
手工清洗的通病是「不可复现」:这次删掉三行重复、补了两个空值,下次换个人来做,结果又不一样。把清洗写成脚本,好处不只是快,而是可审计——每一条规则都留在代码里,出错能回溯到具体哪一步。
对应真实方案:轻量结构化用 wireservice/csvkit(6,408 Stars,MIT),一条管道就能完成列筛选与统计;大文件用 DuckDB(41,573 Stars,MIT)直接在 CSV/Parquet/JSON 上跑 SQL,不必先建库;要人工盯着逐条修正的场景,用 OpenRefine(12,003 Stars,BSD-3-Clause)——它会把每一步操作都记成一个可撤销、可导出的操作记录。三者可以组合:OpenRefine 探路定规则,DuckDB 批量执行,csvkit 做结果校验。
# 先看清数据长什么样
csvstat data.csv

# 只保留需要的列,再做去重与统计
csvcut -c 1,3,5 data.csv | csvsql --query "SELECT DISTINCT * FROM stdin" > clean.csv

# 大文件直接用 SQL 清洗,不建库
duckdb -c "COPY (SELECT DISTINCT * REPLACE (COALESCE(name,'') AS name) FROM 'raw.parquet') TO 'clean.parquet';"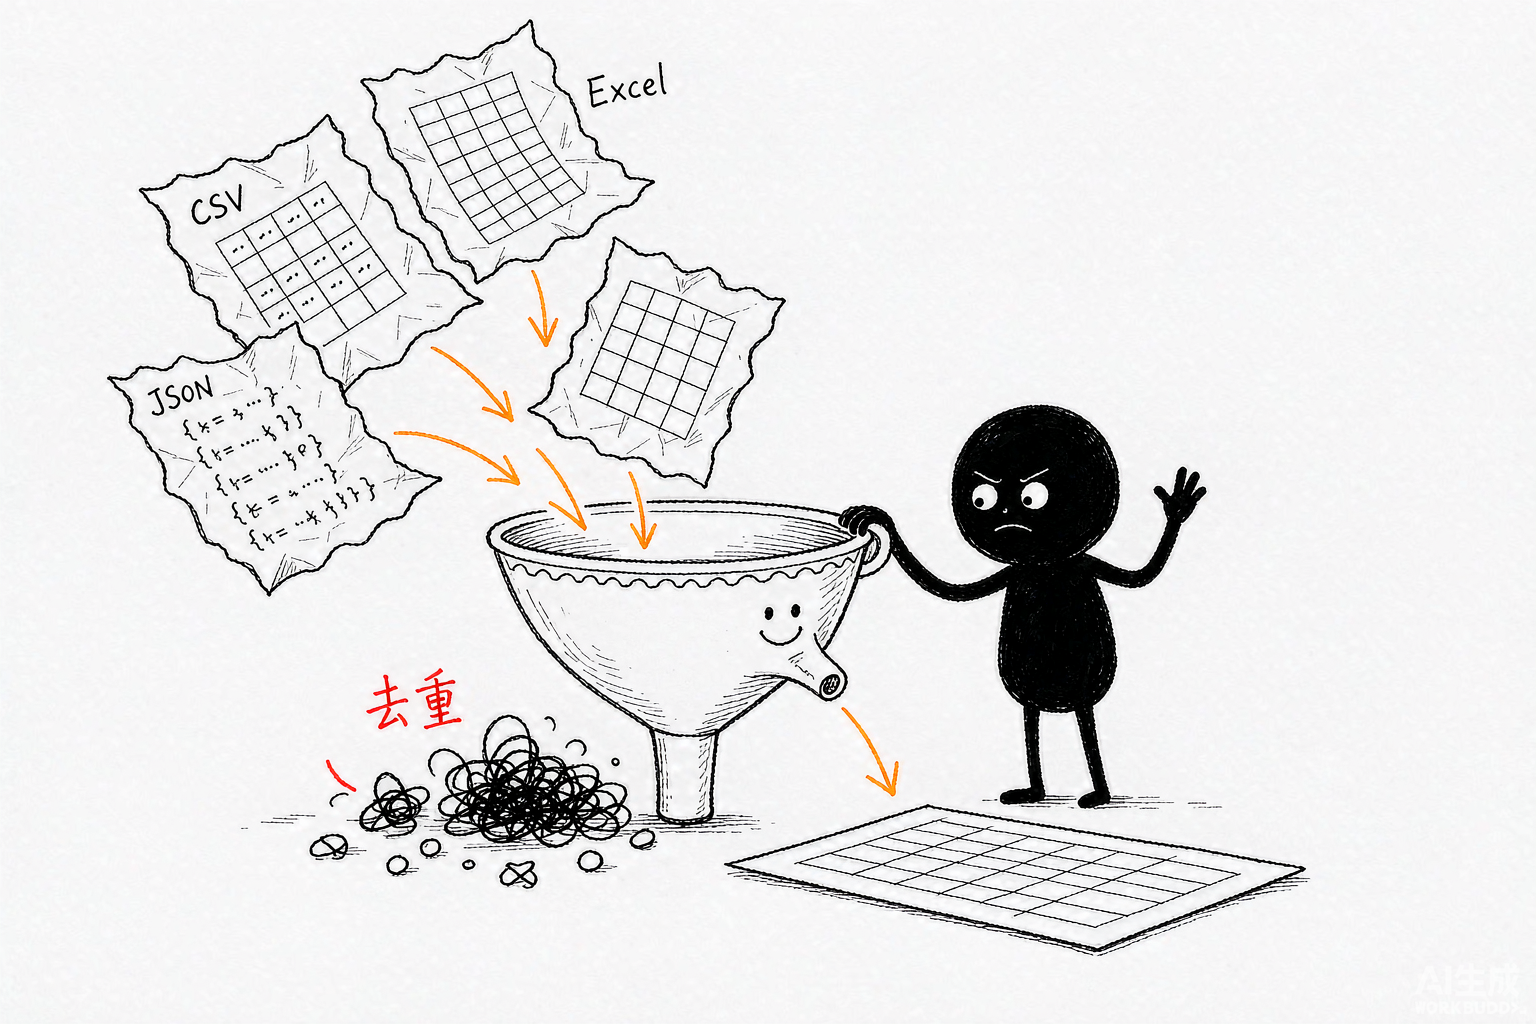
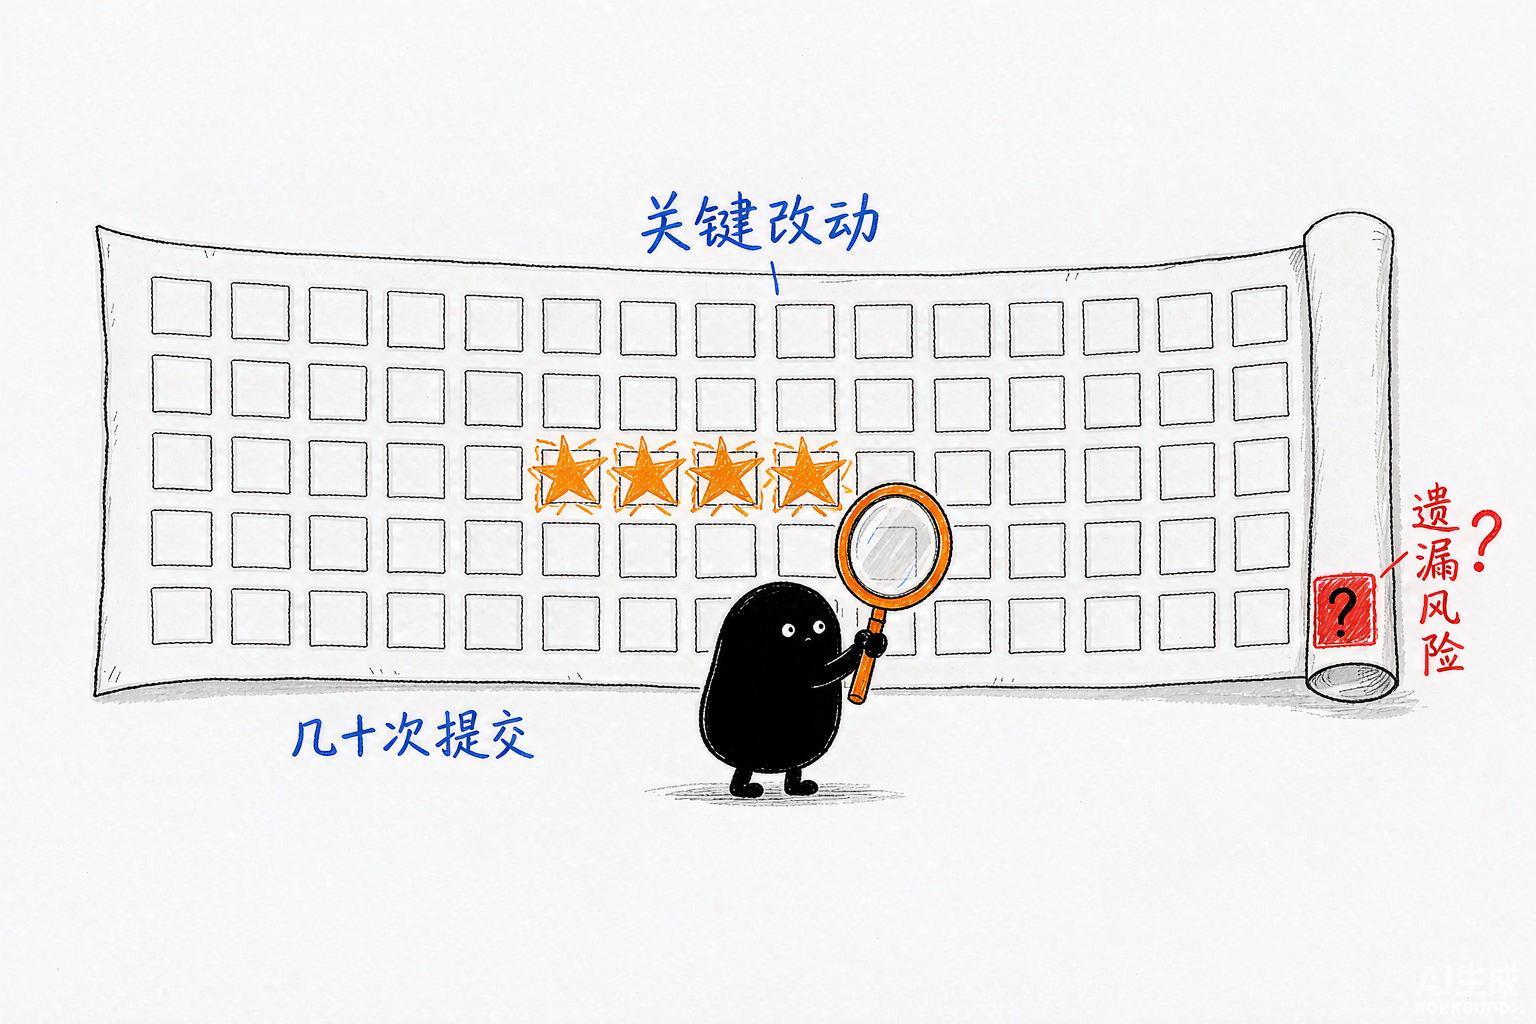
3.2 Changelog Miner——找出关键改动,补齐遗漏风险
一次版本迭代几十上百条提交,真正影响用户的往往只有几条,剩下的是重构、格式化、依赖小版本更新。Changelog Miner 要做两件事:把要紧的挑出来,把「没写进说明但会炸」的标出来。后者更值钱——数据库迁移、配置项重命名、接口字段删改,这类改动一旦漏在发布说明之外,用户是在出故障的那天才知道的。
对应真实方案:orhun/git-cliff(12,247 Stars,Apache-2.0)是以 Conventional Commits 为输入、高度可定制的变更日志生成器,可按 commit 类型分组,也能只输出未发布的部分。它省掉的是「从 diff 里读人话」这一步;至于「遗漏风险」,仍需一条人工规则:凡是触及 schema、配置键、公开接口的提交,必须显式标注。
3.3 Dependency Guard——升级依赖前先看破坏面
依赖升级的代价从来不在「升」这个动作本身,而在它连带破坏了什么:主版本跳跃里的破坏性变更、传递依赖的版本冲突、构建脚本里对旧行为的隐式假设。所以这个能力位的正确姿势是「先量再升」——把破坏面量清楚,再决定这次升不升、怎么升。
对应真实方案:renovatebot/renovate(22,540 Stars,AGPL-3.0)把升级变成可审阅的 PR,支持分组、排期与「先 dry-run 看会改什么」;安全面用 pip-audit(1,365 Stars,Apache-2.0)扫已知漏洞;想连「上游是否弃坑、维护者是否集中、安装脚本是否可疑」一起评估,可参考 trailofbits/skills(7,171 Stars,CC-BY-SA-4.0)里的供应链风险审计技能。
# 只查不改:先看这次升级会动哪些包
npx renovate --dry-run=lookup

# Python 侧先扫已知漏洞
pip-audit -r requirements.txt

# 升级后立刻验证破坏面
npm ls --depth=0 && npm test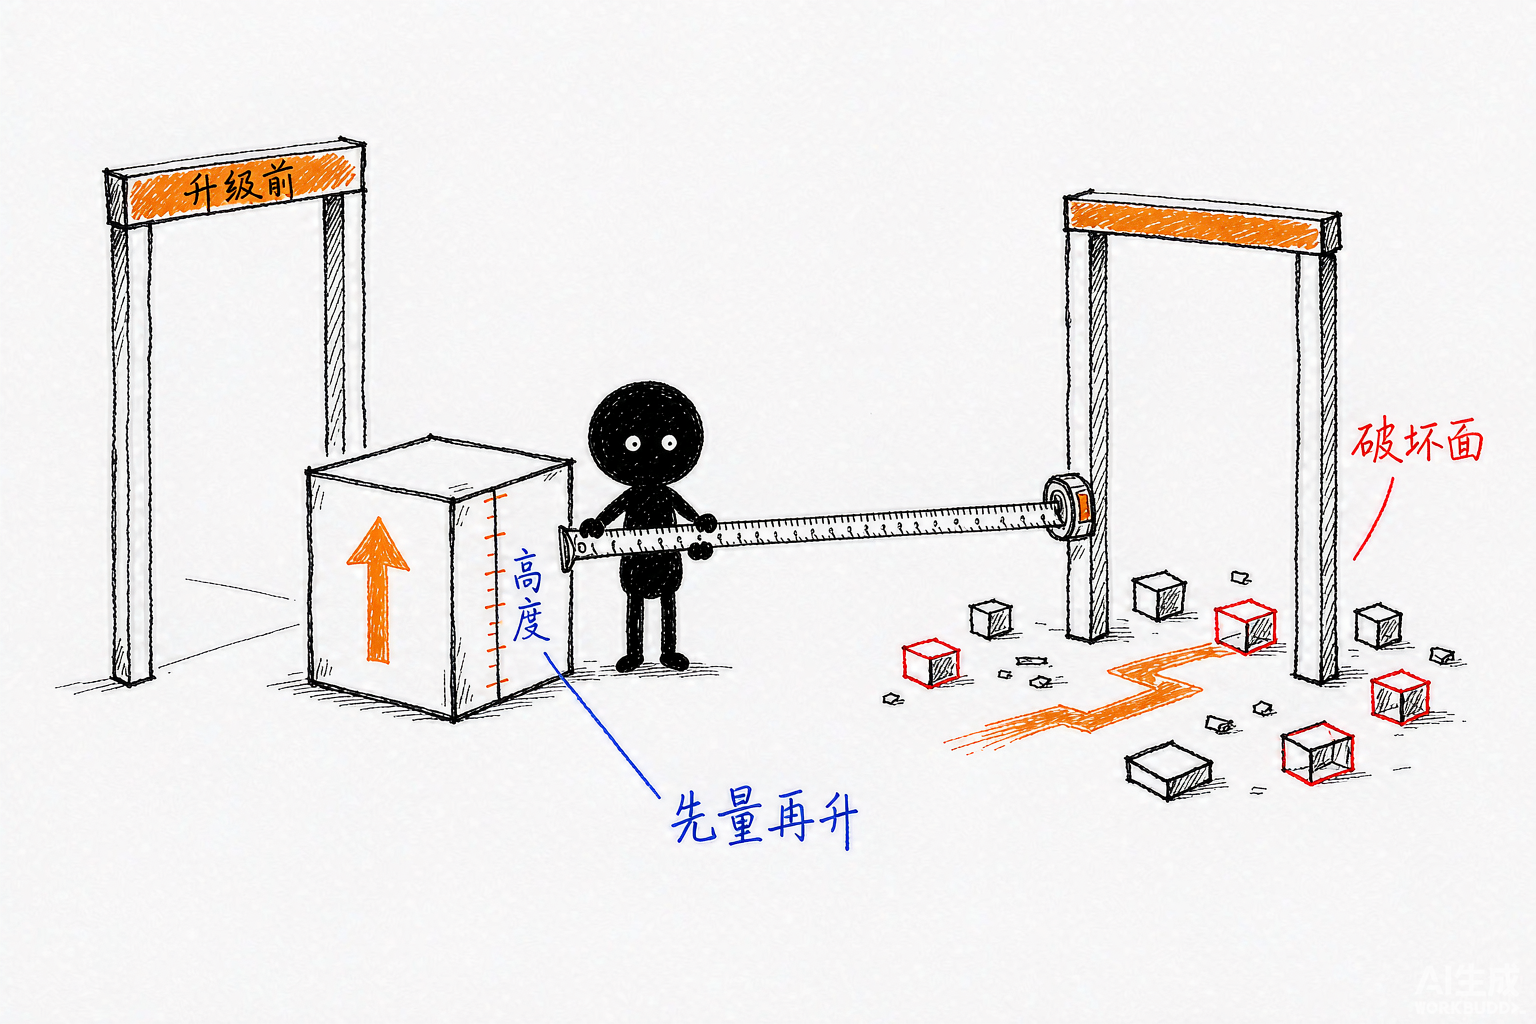
四、发布运维类:让「发版」和「巡检」不再占用人
4.1 Release Notes——从代码 diff 里提炼用户能看懂的更新说明
代码差异是给机器看的:函数改名、参数调整、依赖升级,每一条都精确但没人读得懂。更新说明是给用户看的:新增了什么、修好了什么、有什么行为变了。这个能力位就是把前者翻译成后者——关键在于「用户视角」:一个内部重构对开发者是大事,对用户是零信息,不该出现在发布说明里。
对应真实方案:semantic-release(24,051 Stars,MIT)把「版本号 + 更新说明 + 发布」整条链自动化,完全由提交信息驱动;如果只想生成说明而不接管发布流程,git-cliff 的模板机制更灵活,可以用自定义模板把 commit 类型映射成用户能读懂的三个分区。
# 只生成「自上个 tag 以来」的更新说明
git-cliff --unreleased --tag v2.0.0 --output RELEASE_NOTES.md

# 或者整条链路自动化(校验提交规范 → 定版本 → 发说明)
npx semantic-release --dry-run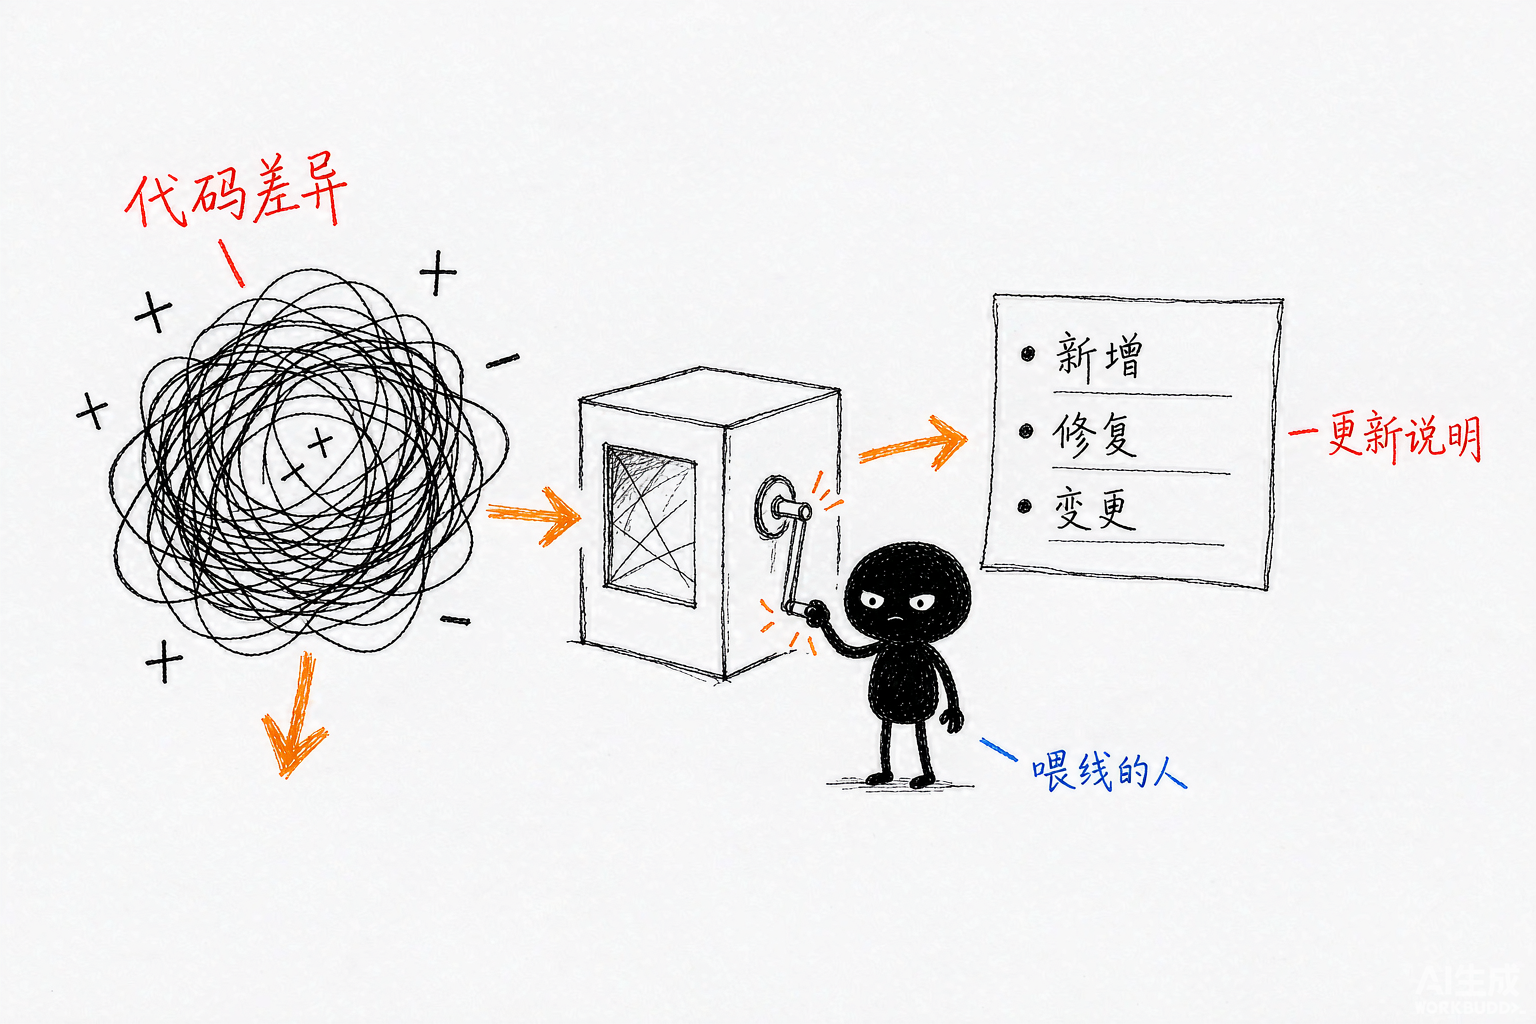
4.2 Nightly Runner——重复任务定时巡检,晚上自动跑完
有一类活永远不值得占用人:每晚跑一遍回归、检查依赖有没有新漏洞、扫描文档是否与代码脱节。它们的共同点是「结果大多数时候是好的」,所以人来做就是浪费;但一旦出事,早发现的价值又极大。这类任务的标准解法是定时调度 + 结果通知:夜里跑,早上看,异常才打扰人。
对应真实方案:在 CI 里用 GitHub Actions 的 schedule 触发器(cron 表达式),在本机用系统的计划任务;Renovate 也自带排期能力,可以把依赖升级固定到低峰时段。设计要点有三条:任务必须幂等(重复跑不会产生副作用)、失败必须有通知(否则等于没跑)、产出必须落在可查的地方(日志或 Issue,而不是只留在控制台)。
# GitHub Actions:每天凌晨 3 点跑一次巡检
on:
  schedule:
    - cron: '0 3 * * *'
  workflow_dispatch:      # 保留手动触发,便于复现问题

jobs:
  nightly:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - run: pip-audit -r requirements.txt
      - run: npm test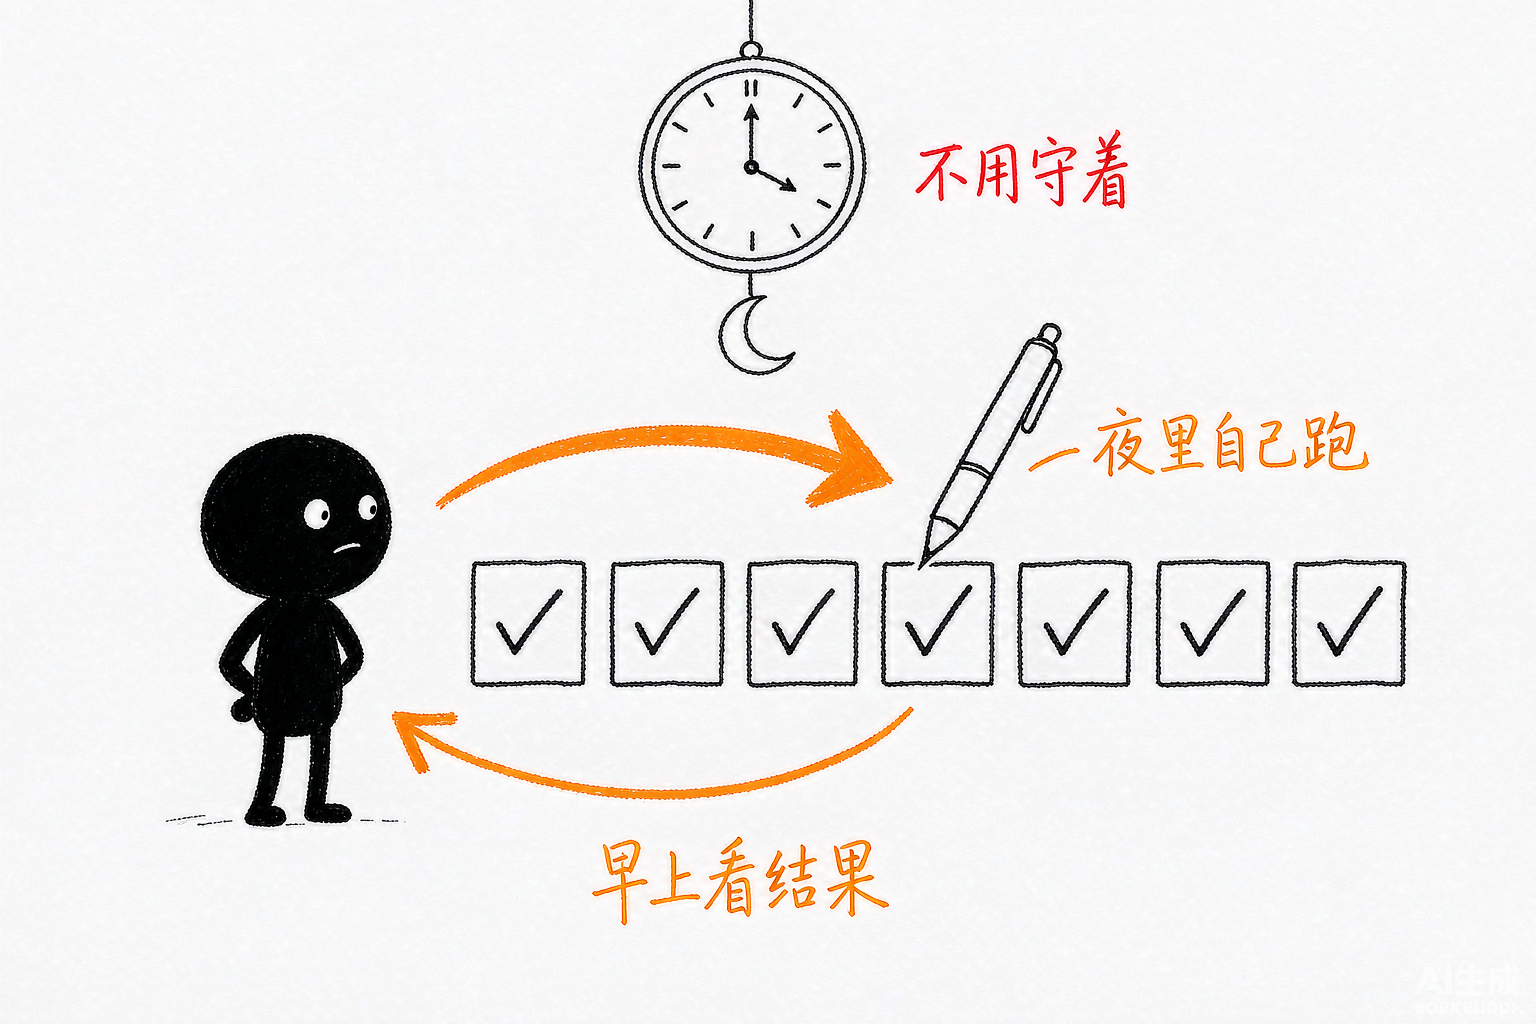
五、一张表看全:10 个能力位与它们的真实方案
| 能力位 | 真实方案 | Stars · 协议 | 最适用 |
|---|---|---|---|
| Agent Swarm | obra/superpowers | 288,985 · MIT | 多代理分工的开发流程 |
| Playwright Scout | lackeyjb/playwright-skill | 3,129 · MIT | 让 Agent 自己开浏览器取证 |
| Terminal Sense | cli/cli(gh) | 46,336 · MIT | 从海量日志里降噪定位 |
| CI Fixer | gh run view –log-failed | 同上 | 先复现、再最小修复 |
| Screenshot QA | microsoft/playwright | 96,394 · Apache-2.0 | 桌面 + 移动端视觉回归 |
| Data Cleaner | DuckDB / csvkit / OpenRefine | 41,573 / 6,408 / 12,003 | 批量清洗与可审计修正 |
| Changelog Miner | orhun/git-cliff | 12,247 · Apache-2.0 | 从提交里挑关键改动 |
| Dependency Guard | Renovate / pip-audit | 22,540 / 1,365 | 升级前先看破坏面 |
| Release Notes | semantic-release / git-cliff | 24,051 · MIT | 把 diff 翻译成用户语言 |
| Nightly Runner | Actions schedule / 计划任务 | 内置 | 定时巡检与结果通知 |
需要提醒的是,Stars 只代表关注度,不代表适配度。选型时更要看三件事:最近一次提交距今多久、有没有可运行的示例、以及它是否与你的既有工具链兼容。一个 3,000 星的专用技能,在特定场景里往往比 90,000 星的通用库更好用——因为前者已经把流程写死了,不需要你再设计一遍。
六、怎么把它们接进日常:一条真实的日循环
能力清单如果只是清单就没有价值。把它们串成一条每天都会走的回路,才算真的落地。一个可用的组合是:夜里由定时任务跑巡检与依赖检查 → 早上用 Terminal Sense 的思路看失败日志 → 需要修就按 CI Fixer 的纪律先复现再最小修改 → 涉及界面改动时让 Playwright Scout 取证、Screenshot QA 比对基线 → 发版前用 Changelog Miner 挑关键改动、Release Notes 生成面向用户的说明 → 数据类杂活交给 Data Cleaner 写成脚本而不是手工处理。
# 早上:一眼看清昨晚发生了什么
gh run list --limit 10
gh run view <run-id> --log-failed

# 中午:界面改动取证(截图 + 视觉对比)
npx playwright test --project=desktop --project=mobile

# 傍晚:发版前生成面向用户的说明
git-cliff --unreleased --tag v2.0.0 --output RELEASE_NOTES.md这条回路的价值不在单点提速,而在于把判断留在人手里、把搬运交出去:机器负责跑、抓、比、列,人负责决定改不改、发不发、升不升。这也是后文风险清单的立足点。
七、边界与风险:哪些不能交出去
自动化越顺手,越要显式写清哪些环节必须有人。以下五条来自实践中的高频翻车点,建议直接写进团队的技能使用规范。
第一,视觉基线必须人工确认。自动更新基线等于把 bug 固化成「正确」,所以基线的每一次变更都应当由人看过再提交。第二,依赖升级必须可回滚。Renovate 之类的工具把升级变成 PR 是对的,但前提是测试能在 PR 阶段跑完;没有测试覆盖的升级,即使自动化了也只是把风险挪了个位置。第三,日志与截图可能包含密钥。把日志、截图交给外部模型前要做脱敏,这是很容易被忽略的一环。
第四,自动修复要限额。允许 Agent 直接提交修复没问题,但要限制它的改动范围(比如只允许改测试代码或配置文件),而不是放任它重写业务逻辑。第五,定时任务必须幂等且有通知。一个会重复产生副作用的夜间任务,比没有这个任务更危险;一个静默失败的巡检,等于自欺欺人。
八、精简总结
这 10 个 SKILL 覆盖了研发流程里最容易被重复劳动吃掉的三段:开发测试、数据处理、发布运维。它们分别是 Agent Swarm(多代理并行分工)、Playwright Scout(自动开页面取证)、Terminal Sense(日志降噪成线索)、CI Fixer(先复现再最小修复)、Screenshot QA(桌面与移动端视觉回归)、Data Cleaner(CSV/Excel/JSON 批量清洗)、Changelog Miner(挑出关键改动与遗漏风险)、Dependency Guard(升级前评估破坏面)、Release Notes(把 diff 翻译成用户语言)、Nightly Runner(定时夜间巡检)。每个能力位在社区里都有成熟实现:superpowers、playwright-skill、gh CLI、Playwright 的截图断言、DuckDB 与 csvkit、git-cliff、Renovate 与 pip-audit、semantic-release,以及 GitHub Actions 的 schedule 触发器。落地时记住三条纪律——机器负责跑抓比列,人负责改不发升;视觉基线与依赖升级必须可回滚可审阅;定时任务必须幂等且有通知。做到这三点,这 10 个能力位才能真正把时间还给你。
相关仓库:superpowers · playwright-skill · playwright · gh CLI · DuckDB · git-cliff · Renovate · semantic-release







