
 AI智汇具 - AI工具推荐与技能教程_好用的AI工具大全
把截图、设计稿、Figma 与屏幕录像直接翻译成可运行代码——六套技术栈 · 多模型并排生成 · 真实素材抠图复用 · 无头浏览器自检。
MIT License
Python + React/Vite
9.5k Forks
Drop in a screenshot, get clean code
screenshot-to-code 是一个把截图、mockup、Figma 设计和屏幕录像转成干净功能代码的开源项目,前端 React/Vite、后端 FastAPI,支持 HTML+Tailwind、React+Tailwind、Vue+Tailwind 等六套技术栈,默认接入 Gemini、GPT、Claude 与 Replicate 多家模型并排生成变体。本文按它 README 自身的脉络展开:先讲它真正解决的还原度问题,再拆六套技术栈与默认模型清单、四把 API 钥匙各自的职责、一次生成的完整链路,然后是本地部署、Docker、截图自检与视频模式、FAQ 里的六个真实坑,以及三个官方示例说明了什么。
一、从截图到代码:它要解决的从来不是「写一段 HTML」
screenshot-to-code 对自己的全部介绍,压在仓库第一行:Drop in a screenshot and convert it to clean code (HTML/Tailwind/React/Vue)。丢一张截图进去,换一段干净代码出来。没有愿景宣言,没有路线图,一句功能描述就完事,后面紧跟着一句更实在的:Convert screenshots, mockups, Figma designs, and screen recordings into clean, functional code using AI。
但这句话背后是一个真实且长期存在的痛点。把设计稿变成页面这件事,从来不难在「写出 div 和 class」,而是难在还原度:栅格是几列、间距是 16 还是 24、标题层级是三层还是四层、卡片阴影有多深、那颗 logo 到底是原图还是灰色占位块。人类前端工程师扫一眼就能判断的东西,恰恰是最难用规则描述、也最难写进代码的东西。
它的思路是把视觉判断整个交给多模态模型,再用工程手段把输出约束住:一次生成同时跑多个模型变体、把截图里真实的图片与 logo 抠出来复用、生成完还能自己开一个无头浏览器渲染并截图自检。仓库数据也在说明这套思路被多少人验证过——78306 个 Star、9517 次 Fork、143 个未关闭 Issue,主语言 Python,MIT 许可,2023 年 11 月 14 日建仓,最近一次提交推送在 2026 年 8 月 14 日。官方还提供了一个托管版 screenshottocode.com,README 说得很直白:想最快体验就用托管版,想自定义、自托管或贡献代码才跑本地。
二、六套技术栈与默认模型清单
先看输出侧。README 列出的 Supported stacks 一共六套,覆盖了从静态页到移动端跨端框架的常见选择:
- HTML + Tailwind:默认主力,也是大多数演示用的栈;
- HTML + CSS:不想要 Tailwind 时的纯手写版本;
- React + Tailwind:组件化输出,方便直接并进现有工程;
- Vue + Tailwind:Vue 生态同款;
- Bootstrap:老项目友好;
- Ionic + Tailwind:往跨端移动应用方向延伸的那一支。
再看模型侧。README 的 Default AI models 一节给出了当前默认接入的清单:Gemini 3 Flash Preview 与 Gemini 3.1 Pro Preview(README 原话是 the best models)、GPT-5.5 与 GPT-5.4 Mini、Claude Opus 4.6 与 Claude Opus 4.8,以及负责图片生成的 z-image-turbo(经 Replicate 调用)。
这里有个容易被忽略的机制:模型不是二选一,而是并排跑。README 写得很清楚,配的 key 越多,应用会在每次生成时自动挑选更强的一组模型组合;只有一把 key 时,就只用那一家供应商的模型。也就是说,四把钥匙配齐,你看到的是「同一张截图的四种解法」,可以横向对比挑一个最接近的,而不是被单一模型的脾气绑架。
顺带一个提醒:README 里 Claude 型号的写法并不完全自洽。模型清单写的是 Opus 4.6 与 Opus 4.8,而 API key 表格里写的是 Opus 5、Opus 4.8、Fable 5、Sonnet 4.6。这类漂移在高频迭代的仓库里很常见,接入时以你本地 Settings 对话框里实际列出来的为准。
三、四把 API 钥匙:为什么 Gemini 和 Replicate 被强烈推荐
本地运行至少需要一把模型供应商的 key,但 README 用了一整段加粗来强调:Gemini and Replicate are strongly recommended for the best quality of screenshot-to-code accuracy。这不是客套,两者管的是完全不同的两件事。
| Key | 是否必需 | 解锁什么 |
|---|---|---|
| OPENAI_API_KEY | 三选一 | GPT 系代码生成变体(GPT-5.5、GPT-5.4 Mini) |
| ANTHROPIC_API_KEY | 三选一 | Claude 系代码生成变体 |
| GEMINI_API_KEY | 三选一,强烈推荐 | Gemini 3 Flash / 3.1 Pro 变体;从截图中提取真实素材;视频模式必需 |
| REPLICATE_API_KEY | 强烈推荐 | 图片编辑、去背景、Replicate 侧图片生成;缺失则 edit_images 与 remove_backgrounds 不可用 |
(一)Gemini 管的不是「又一个模型」,而是素材复用
README 的原话是:Gemini powers asset extraction (reusing the real logos/images from your screenshot)。翻译过来就是,截图里那颗真实的 logo、那张真实的配图,会被提取出来直接用到生成结果里,而不是被替换成一个灰色方块加一句占位文字。这一条对还原度的贡献,比换更强的代码模型还大——毕竟页面像不像,第一眼看的往往是图,不是标签结构。
(二)Replicate 管的是图片处理这条支线
Replicate powers image generation, background removal, and image editing。它决定了你能不能把截图中抠出来的素材去背、修图,以及在需要时生成缺失的图片资产。README 给了个明确的边界:没有 REPLICATE_API_KEY,edit_images 和 remove_backgrounds 两个能力直接不可用,其余部分照常跑。
另外,Replicate 的 key 必须在 backend/.env 里写成 REPLICATE_API_KEY,不能像 OpenAI、Anthropic、Gemini 那样在前端齿轮图标的 Settings 对话框里配。这是部署时最容易漏的一步。
四、一次生成的完整链路
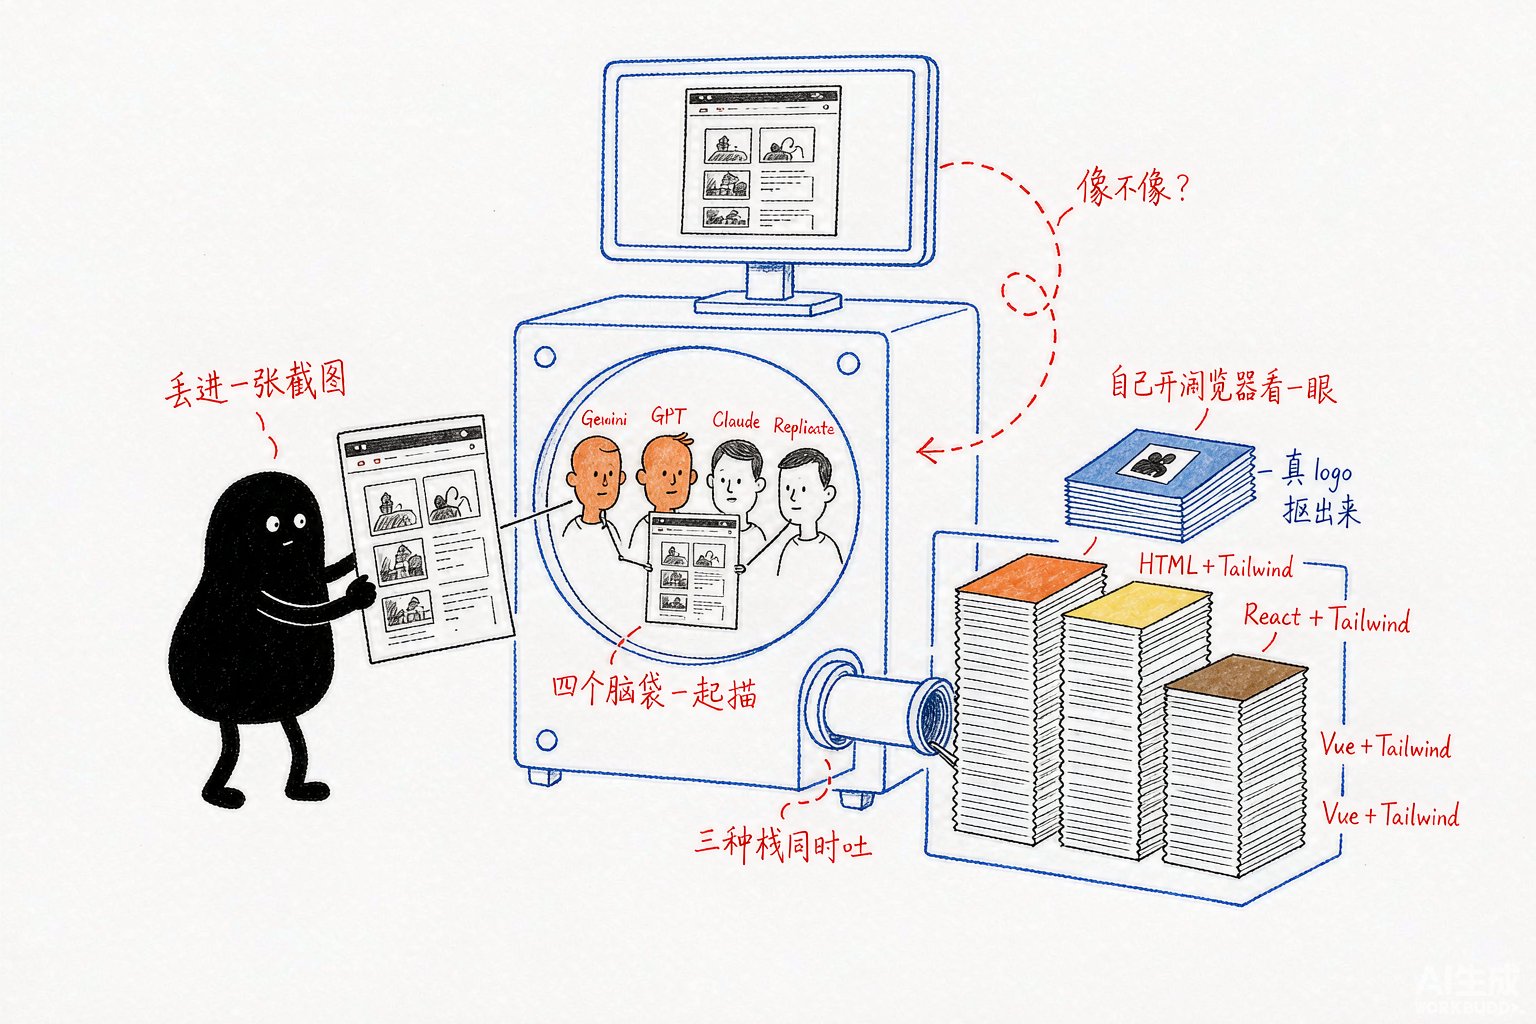
把 README 里散落的机制串起来,一次生成大致是下面这条流水线。它之所以比「把图丢给大模型」靠谱,就在于中间多了两段工程约束。
其中最值得单说的是第四段的截图自检。README 把它叫做 screenshot preview:让 agent 在无头浏览器里把自己刚生成的页面渲染出来,再视觉检查一遍自己的作品。这在工程上是个很关键的转折——模型不再盲写,而是有了「写完看一眼」的闭环。它靠 Playwright 的 Chromium 实现,装了就有,没装就自动跳过,Settings 对话框会明确告诉你当前后端是否可用。
多变体这一段则决定了你的使用姿势。四个 key 全配,你会拿到同一张截图的多个候选,可以挑结构最合理的那个继续改;只配一把,工具照样能用,但等于把判断权全交给单一模型。对个人玩票来说一把就够,对真要把产出并进工程的团队,多配几把的性价比明显更高。
五、本地部署:Poetry 后端 + pnpm 前端
后端用 Poetry 管理依赖(没有就先 pip install –upgrade poetry),命令基本照抄即可:
cd backend
echo 'OPENAI_API_KEY=sk-your-key' > .env
echo 'ANTHROPIC_API_KEY=your-key' >> .env
echo 'GEMINI_API_KEY=your-key' >> .env
echo 'REPLICATE_API_KEY=r8_your-key' >> .env
poetry install
poetry run playwright install chromium
poetry env activate
poetry run uvicorn main:app --reload --port 7001
注意 poetry env activate 会打印一条激活命令(形如 source /path/to/venv/bin/activate),需要你自己复制执行。Chromium 那步在 Linux 上建议用 poetry run playwright install –with-deps chromium,它会顺带装系统依赖,但需要 sudo/apt。
前端是独立的 React/Vite 工程:
cd frontend
pnpm install
pnpm dev
然后打开 http://localhost:5173。如果后端换了端口,改 frontend/.env.local 里的 VITE_WS_BACKEND_URL;如果后端在另一台机器上,VITE_HTTP_BACKEND_URL 和 VITE_WS_BACKEND_URL 都要改,README 给的例子是 VITE_HTTP_BACKEND_URL=http://124.10.20.1:7001。
六、Docker:一条命令起来,但别拿它开发
有 Docker 的话,在仓库根目录执行:
echo 'OPENAI_API_KEY=sk-your-key' > .env
docker-compose up -d --build
同样在 http://localhost:5173 访问。README 特意补了一句限制:you can’t develop the application with this setup, as file changes won’t trigger a rebuild。也就是说 Docker 这条路径只适合「先跑起来看看」,改代码还得回到第五节的双进程方案。好消息是 Docker 镜像里已经带了 Chromium,截图自检开箱可用。
七、从静态截图到屏幕录像:视频模式
README 里有一句容易被滑过去的话:Screenshot to Code also supports taking a screen recording of a website in action and turning that into a functional prototype。输入不再只是一张静止的图,而可以是一段网站运行中的录屏,输出是一个能跑的原型。
这件事的意义在于,截图只能表达「长什么样」,录屏还能表达「点下去会发生什么」——悬停、展开、切换、滚动加载。而这条能力对 key 有硬性要求:GEMINI_API_KEY 的表格说明里明确写着 required for video mode。也就是说,视频模式是 Gemini 独占的,只配 OpenAI 或 Anthropic 的朋友暂时用不上。
八、FAQ 里藏着的六个真实坑
Q1:后端起不来怎么办?
README 直接指向 issue #3 下的一个 comment,说先按那个排查;还不行就去开新 issue。这是这类高频仓库的典型处理:踩坑答案沉淀在 issue 里,而不是文档里。
Q2:访问不了 OpenAI,能配代理吗?
可以。在 backend/.env 里设置 OPENAI_BASE_URL,也可以在前端 Settings 对话框里直接填。README 特别强调:Make sure the URL has v1 in the path,例如 https://xxx.xxxxx.xxx/v1。少了 v1 是最常见的失败原因。
Q3:前端连不上另一台机器上的后端?
在 frontend/.env.local 里同时配 VITE_HTTP_BACKEND_URL 与 VITE_WS_BACKEND_URL。前者管 HTTP 请求,后者管 WebSocket 流式返回,只改一个会出现「能提交但收不到生成流」的怪现象。
Q4:Windows 上跑后端报 UTF-8 错误?
README 的做法很朴素:用 Notepad++ 打开 .env,Encoding 菜单里选 UTF-8 保存。本质是 .env 被存成了带 BOM 或本地编码。
Q5:能用 Ollama 跑开源模型吗?
能,但 README 的态度是 not recommended due to poor-quality results,并附了一个 issue 链接。截图到代码这件事对视觉理解能力要求很高,本地小模型目前的还原度还不在一个量级。
Q6:想反馈去哪里?
开 issue,或者去 Twitter 找作者 @_abi_。
九、NYTimes、Instagram、Hacker News:三个示例说了什么
README 的 Examples 一节挑了三个样本,恰好覆盖三类难度。NYTimes 是唯一给出 Original 与 Replica 并排对照表的,说明它主攻的是复杂排版:多栏、图片与文字混排、层级密集的新闻首页,这类页面最能检验栅格与间距的判断力。Instagram 与 Hacker News 则是两个极端,前者是重视觉、重图片的界面,后者是几乎纯文本、信息密度极高的列表页。
这三个样本合在一起,其实是在回答一个质疑:这类工具是不是只能做简单的落地页?选一个以排版复杂著称的新闻站、一个以图片流著称的社交产品、一个以密集列表著称的技术社区,覆盖的是三种完全不同的视觉结构。README 没有给出还原度打分,把判断留给看的人——这反而比自吹准确率更可信。
十、成本、边界与总结
先说成本。它是开源免费的,但模型调用不是。四个 key 意味着四份账单,一次生成跑多个变体意味着单次成本乘以变体数。托管版省的是部署成本,模型费用照付。这也是 README 反复强调「配齐 key 效果最好、但一把也能跑」的现实原因——你得在效果与账单之间自己找平衡点。
再说边界。它的产出是「干净、可运行的起点」,不是可以直接上线的成品。语义化标签是否合理、无障碍属性是否齐全、响应式断点是否覆盖、有没有引入多余依赖,这些仍然要人来把关。把它当成把设计稿切成第一版结构的加速器,而不是替代前端。
回过头看,screenshot-to-code 真正做对的,是把「视觉还原」这件玄学的事,拆成了几个可以分别优化的工程环节:用多模型并排对冲单一模型的不确定性,用素材提取保住截图的真实资产,用无头浏览器自检补上最后一道闭环。78306 个 Star 不是因为它是第一个做这件事的,而是因为它把这件事做到了能用的程度。对于手上堆着一堆设计稿、Figma 文件或者竞品截图,却懒得从零搭结构的人来说,它值得一试。
本文仅作技术介绍。使用该项目需自行承担模型 API 调用费用,并遵守 OpenAI、Anthropic、Google、Replicate 各家服务条款与数据处理政策;请勿上传包含个人隐私、商业秘密或未获授权设计稿的截图。生成的代码应经人工复核、安全审查与许可合规检查后再用于生产环境。文中 Star、Fork、Issue 等数据取自仓库公开信息,可能随版本更新而变化。
在撰写本文的过程中,我主要参考了以下来源:GitHub 仓库 abi/screenshot-to-code 的 README(Supported stacks、Default AI models、API keys 表格、Getting Started、Docker、FAQs、Examples 各节)与仓库 meta 数据,以及官方托管站点 screenshottocode.com。文中数据以官方公开信息为准,可能随版本更新而变化。
本文由 AI 辅助整理,基于 GitHub 项目 abi/screenshot-to-code 的公开文档撰写;配图为小黑风格手绘插图。内容仅用于技术介绍,不构成任何工具选型或商业承诺。







