AI智汇具 - AI工具推荐与技能教程_好用的AI工具大全
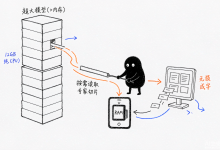
BigMoeOnEdge:在 12GB 手机上无损运行超内存 MoE 模型
BigMoeOnEdge 是一款让 MoE(混合专家)模型在内存远小于模型体积的设备上无损运行的推理引擎。它基于原版 llama.cpp 构建,通过把闪存当作内存层的一部分,按需从磁盘流式读取专家权重,把手机 RAM 留给真正活跃的参数。项目支持在 12GB 手机上以纯 CPU 运行 80–90GB 级别的前沿模型(如 DeepSeek V4 Flash 0731、Qwen3.8-Flash-Next 等),并提供 Expert cache、I/O overlap、Direct I/O 等十余个调优开关,输出结果与模型完全驻留内存时字节级一致。本文将介绍其核心机制、功能特点、安装方式、性能基准与常见使用问题。
 aitoolpush