
 AI智汇具 - AI工具推荐与技能教程_好用的AI工具大全
BigMoeOnEdge:在 12GB 手机上无损运行超内存 MoE 模型
Run MoE models bigger than your RAM —— 在 12GB 手机、纯 CPU 上无损运行前沿级 MoE 模型
C++ / llama.cpp
Apache-2.0
纯 CPU 推理
12GB 手机可跑
BigMoeOnEdge 是一款让 MoE(混合专家)模型在内存远小于模型体积的设备上无损运行的推理引擎。它基于原版 llama.cpp 构建,通过把闪存当作内存层的一部分,按需从磁盘流式读取专家权重,把手机 RAM 留给真正活跃的参数。项目支持在 12GB 手机上以纯 CPU 运行 80–90GB 级别的前沿模型(如 DeepSeek V4 Flash 0731、Qwen3.8-Flash-Next 等),并提供 Expert cache、I/O overlap、Direct I/O 等十余个调优开关,输出结果与模型完全驻留内存时字节级一致。本文将介绍其核心机制、功能特点、安装方式、性能基准与常见使用问题。
一、产品深度介绍
(一)它是什么
BigMoeOnEdge 不是另一个量化压缩工具,而是一套面向 MoE 架构的「内存外推理」引擎。它的自我定位非常直接:Run MoE models bigger than your RAM. Frontier-size MoE on a 12 GB phone, CPU only, lossless, on stock llama.cpp。
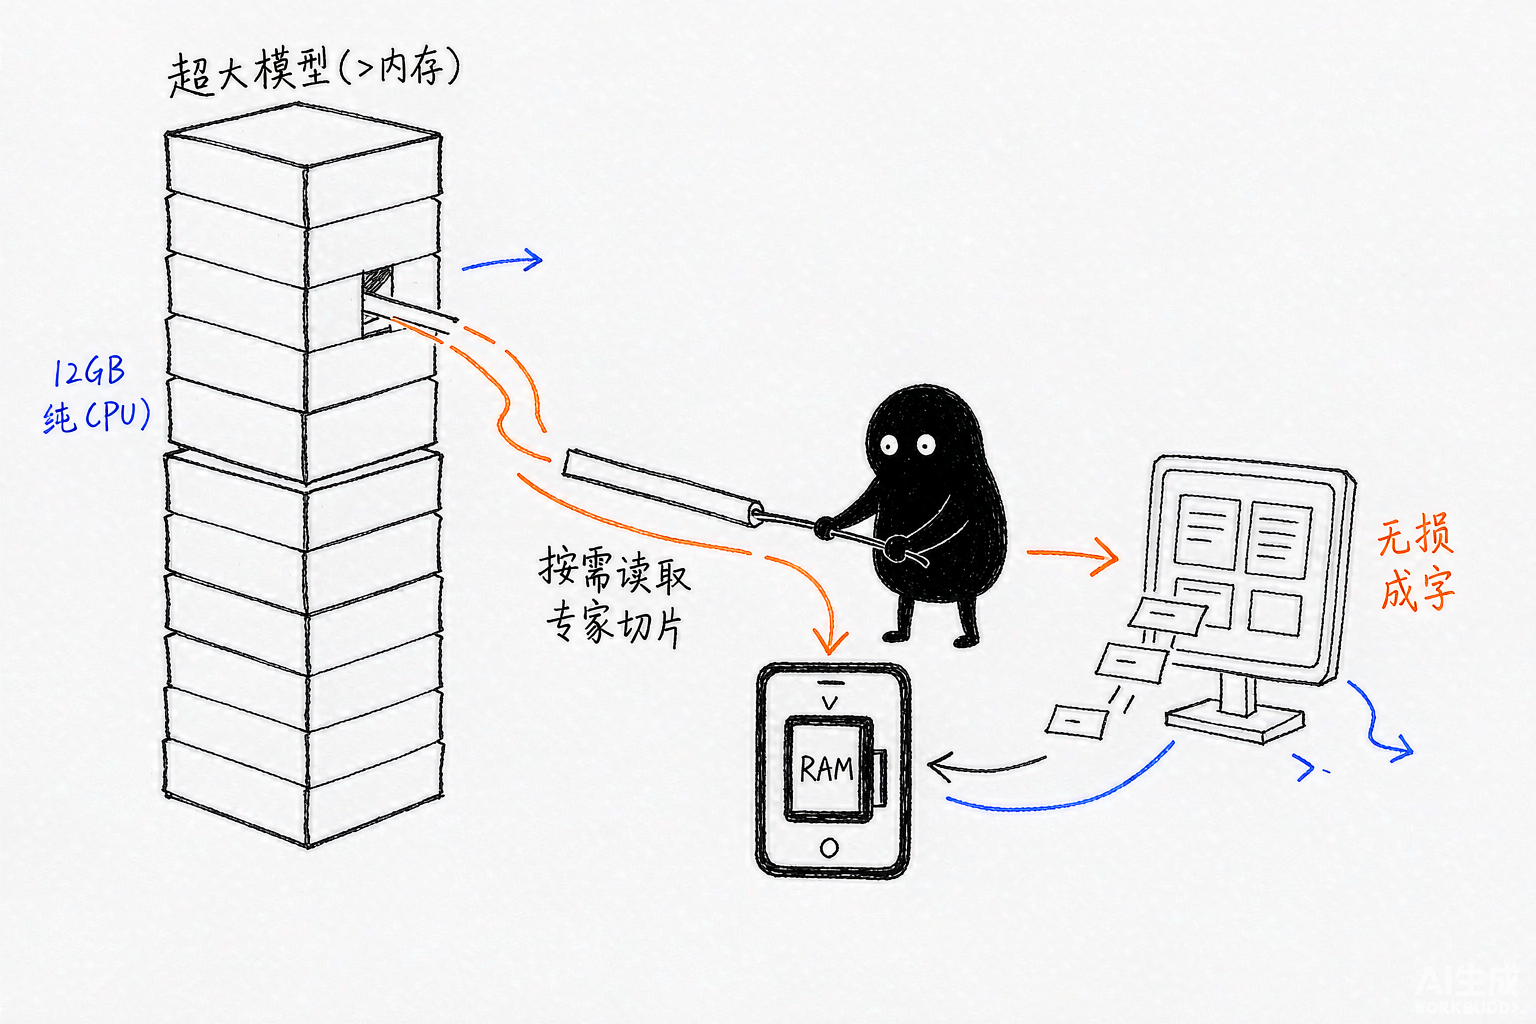
MoE 模型每 token 只激活少数专家,理论上可以把绝大多数权重留在更慢的存储里。BigMoeOnEdge 把这个特性贯彻到底:常驻非专家权重与近期热门专家,其余专家切片按需从闪存直接读取。由于只改变取权重的时机和方式,不改变计算本身,因此输出与把整份模型放进内存的运行结果完全相同——项目用 ctest 合成模型门控保证这一点。
(二)技术表现
- 纯 CPU:不依赖 GPU/NPU,4–8 核 ARM/x86 即可运行。
- 无损:字节级一致,由 ctest 自动化回归。
- 模型支持:一行注册表即可添加 qwen3moe、qwen35moe、qwen2moe、gemma4、gpt-oss、lfm2moe、deepseek4、bailingmoe3、qwen4exp 等架构。
- 量化兼容:所有 llama.cpp 格式开箱即用(Q4_K_M、Q2_K、UD-IQ3_XXS、MXFP4 等)。
- 多分片 GGUF:原生读取 Hugging Face 多分片 gguf,>50GB 模型无需合并。
- 实测:12GB 手机上 DeepSeek V4 Flash 0731(284B/约 91GB)可达约 0.94 tok/s;Qwen3.8-Flash-Next(125B/约 80GB Q2_K)可达约 3.48 tok/s。
二、主要功能特点与应用场景
BigMoeOnEdge 把功能分成无损与有损但可复现两类,用户可以根据速度/质量需求选择。
无损流式读取
- Expert cache(–cache-mb):常驻热门专家,缓存命中即可完全走内存。
- Cache ceiling(–cache-ceil-mb):限制 auto 模式申请上限,防止挤占系统。
- Parallel I/O lanes(–io-threads):并行读取专家切片,提高闪存吞吐。
- Direct I/O(–no-odirect):绕过操作系统页缓存,避免双重拷贝。
- I/O and compute overlap(–overlap):计算当前 token 时预取下一轮专家。
- Dense weights(–dense-weights):非专家权重驻留策略(mmap/warm/anon/ahwb)。
- Row-gathered tables(–row-stream):embedding 等稠密表按行从闪存读取。
- Release the model mapping(–release-mmap):加载后取消 gguf 映射,Windows 实测解码速度提升约 46%。
可调优速度与质量
- Drop cold experts(–drop-cold-experts):跳过缓存未命中的低分专家。
- Active experts(–n-expert-used):减少每 token 激活专家数,有损但可复现。
- Guess ahead(–mtp/–ngram):草稿验证多 token,无损。
- Route-ahead(–route-ahead):提前提交路由(有损,实验性)。
应用场景
- 远超 RAM 的模型:约 60–90GB 模型在 12GB 手机上可用。
- 略超 RAM 的模型:18–22GB 模型稳定 5 tok/s,避免缺页风暴。
- 刚好塞入的模型:用上限缓存避免挤占系统资源,保证手机其余功能可用。
三、如何安装与使用
手机(免构建)
从 latest release 下载 APK,安装后打开「Get a model」卡片选择模型目录,下载完成即可开始聊天。应用支持直接输入任意 gguf URL,也支持多分片集合同目录下指向首片。
Host 构建
Linux/macOS 上推荐用官方脚本构建:
git clone --recursive https://github.com/Helldez/BigMoeOnEdge.git
cd BigMoeOnEdge
scripts/build-host.sh
近 RAM 模型示例:
build/cli/bmoe-cli -m Qwen3-30B-A3B-Q4_K_M.gguf --moe-stream \
  --cache-mb auto --cache-ceil-mb 4000 --io-threads 4 -t 4 -n 48 \
  --chatml -p "Explain MoE routing."
远超 RAM 模型示例:
build/cli/bmoe-cli -m gpt-oss-120b-Q4_K_M.gguf --moe-stream --overlap \
  --dense-weights anon --cache-mb 2000 --io-threads 8 -t 4 -n 256 \
  --chatml --no-think -p "Explain MoE routing."
Windows 需用 CMake + MSVC 直接构建,二进制位于 build\cli\Release\bmoe-cli.exe;macOS 同源构建,无 O_DIRECT,使用 F_NOCACHE 替代;Android 可用 scripts/build-android.ps1 编 arm64 CLI 与 APK,也可直接下载 release 附带的预建 debug APK。
验证字节一致性:构建后执行 cd build && ctest –output-on-failure,需要 python3 与 gguf 包。
四、官方地址与获取方式
- GitHub 仓库:https://github.com/Helldez/BigMoeOnEdge
- 最新发布:https://github.com/Helldez/BigMoeOnEdge/releases/latest
- Android APK:latest release 附带预建 debug APK
- 开源协议:Apache-2.0
五、与同类方案对比
| 对比维度 | BigMoeOnEdge | 普通 mmap / 整模型驻留 | 云端 API |
|---|---|---|---|
| 内存要求 | 远小于模型体积 | 必须容纳完整模型 | 终端几乎无要求 |
| 离线运行 | 是 | 是 | 否 |
| 无损输出 | 是(ctest 门控) | 是 | 取决于服务商 |
| 纯 CPU 手机 | 是,核心目标 | 大模型基本不可用 | 不适用 |
| 隐私 | 完全本地 | 完全本地 | 上传云端 |
| 适用模型 | MoE GGUF | 任意 GGUF | 不限 |
六、核心机制深度解析
BigMoeOnEdge 的核心直觉是「把闪存当作内存层级的一部分」。传统运行时把模型文件映射或完全加载到 RAM,一旦模型大于 RAM,手机会进入缺页风暴,系统被杀或速度崩溃。BigMoeOnEdge 只保留两部分常驻:非专家稠密权重(embedding、norm、router 等),以及通过 cache 策略选出的热门专家。
为了降低延迟,引擎提供并行 I/O lanes、overlap 预取、Direct I/O 绕过 OS 页缓存、row-stream 按行读取稠密表等机制。由于计算图本身未变,输出与全驻留模型完全一致。项目为此设计了合成 MoE 模型(scripts/make-tiny-moe.py)并在 CI 中通过 ctest 进行字节级回归。
七、实用技巧
- 缓存上限要锁死:–cache-mb auto 让引擎自动决定常驻专家缓存;再用 –cache-ceil-mb 限定上限,避免挤占系统。
- 多通道 I/O:–io-threads 4~8 在 UFS 4.x 手机上通常能显著提升吞吐;NVMe 桌面可再提高。
- overlap 对远超 RAM 模型收益最大:计算时预取下轮专家,把 I/O 等待藏到计算后面。
- Windows 开 release-mmap:–release-mmap 加载后取消 gguf 映射,官方测试解码速度提升约 46%。
- 稠密权重策略:手机用 –dense-weights ahwb,桌面可用 mmap 或 anon,根据是否希望常驻选择。
- 实时遥测:–progress 查看每 token 的闪存 I/O、缓存命中与计算拆分;–csv 附加内存快照,便于调优缓存大小。
八、最新更新动态
项目当前已有 373 个 commit,最新提交为 2026-09-07(commit 74ba18f,信息 docs(changelog): close 0.24.0)。应用版本迭代到 0.24.0,之前的 0.22.0、0.23.0 逐步完善了 Android 演示应用、实时遥测面板与多模型支持。
仓库 docs/ 目录提供了 architecture.md、telemetry.md、adding-a-model.md、roadmap.md、benchmarks.md、community-benchmarks.md 等文档。其中 adding-a-model.md 说明新架构只需在注册表中添加一行即可接入 BigMoeOnEdge 的流式系统,这也解释了项目为何能快速跟进 Qwen3.8-Flash-Next、DeepSeek V4 Flash 等前沿模型。
九、常见问题 FAQ
Q1:必须 root 手机吗?
不需要。但模型文件必须放在真实文件系统(如 /data/local/tmp/),不要放在 /sdcard 等 FUSE 层上,否则顺序读取会被严重放大。
Q2:支持非 MoE 模型吗?
BigMoeOnEdge 的设计围绕 MoE 的专家稀疏性。普通稠密模型也能跑,但性能优势主要来自「每 token 只激活一小部分专家」。
Q3:GPU/NPU 能加速吗?
当前版本纯 CPU。作者把手机作为核心焦点,因此没有引入 GPU/NPU 推理路径;llama.cpp 公共 API 的兼容层仍是 CPU backend。
Q4:模型从哪里下载?
README 与 Android 应用内置「Get a model」列出推荐模型;也可直接提供任意 gguf URL 或本地多分片集合同目录下指向首片。
Q5:为什么是无损的?
因为只改变权重加载方式,不改变计算内核与采样逻辑。ctest 用合成模型对比全驻留与流式输出,保证字节一致。
十、总结
BigMoeOnEdge 提供了一种新的边缘推理思路:不是把模型变小,而是把内存当成「热缓存」、把闪存当成「扩展内存」。它利用 MoE 的稀疏性,只把每 token 真正需要的专家从闪存即时调入,从而在手机等 RAM 远小于模型体积的设备上实现无损、纯 CPU 的大模型推理。对于需要在本地离线跑前沿 MoE 模型的开发者、极客与隐私敏感场景,这是一套值得关注的工程方案。
项目采用 Apache-2.0 协议,商用与二次开发均较宽松,但具体使用仍需阅读 LICENSE 全文。运行模型时请遵守模型提供方的服务条款与许可协议,并注意生成内容的合规性。
在撰写本文的过程中,我主要参考了 Helldez/BigMoeOnEdge 仓库的 README.md、CHANGELOG.md、docs/ 目录下的 architecture.md、telemetry.md、benchmarks.md 与 adding-a-model.md,以及 GitHub 公开的 star/fork/license 信息。文中性能数据以官方公开基准为准,可能随版本更新而变化。
本文由 AI 辅助整理,基于 BigMoeOnEdge(Helldez/BigMoeOnEdge)的公开文档撰写;配图由 小黑 IP 生成。内容仅用于技术介绍,不构成商业使用授权建议。







