
 AI智汇具 - AI工具推荐与技能教程_好用的AI工具大全
一句话结论:FreeLLMAPI 把 34 家厂商的免费 LLM 额度收进一个 OpenAI 兼容的 /v1 端点——474 个模型族、635 个免费端点、约 74 亿 tokens/月,自动路由、故障转移、密钥本地加密。代价作者自己写在 README 里:没有前沿模型、没有 SLA、傍晚降智,且”for personal experimentation and learning, not production”。
一、三十四个玩具,叠起来是一座发电站
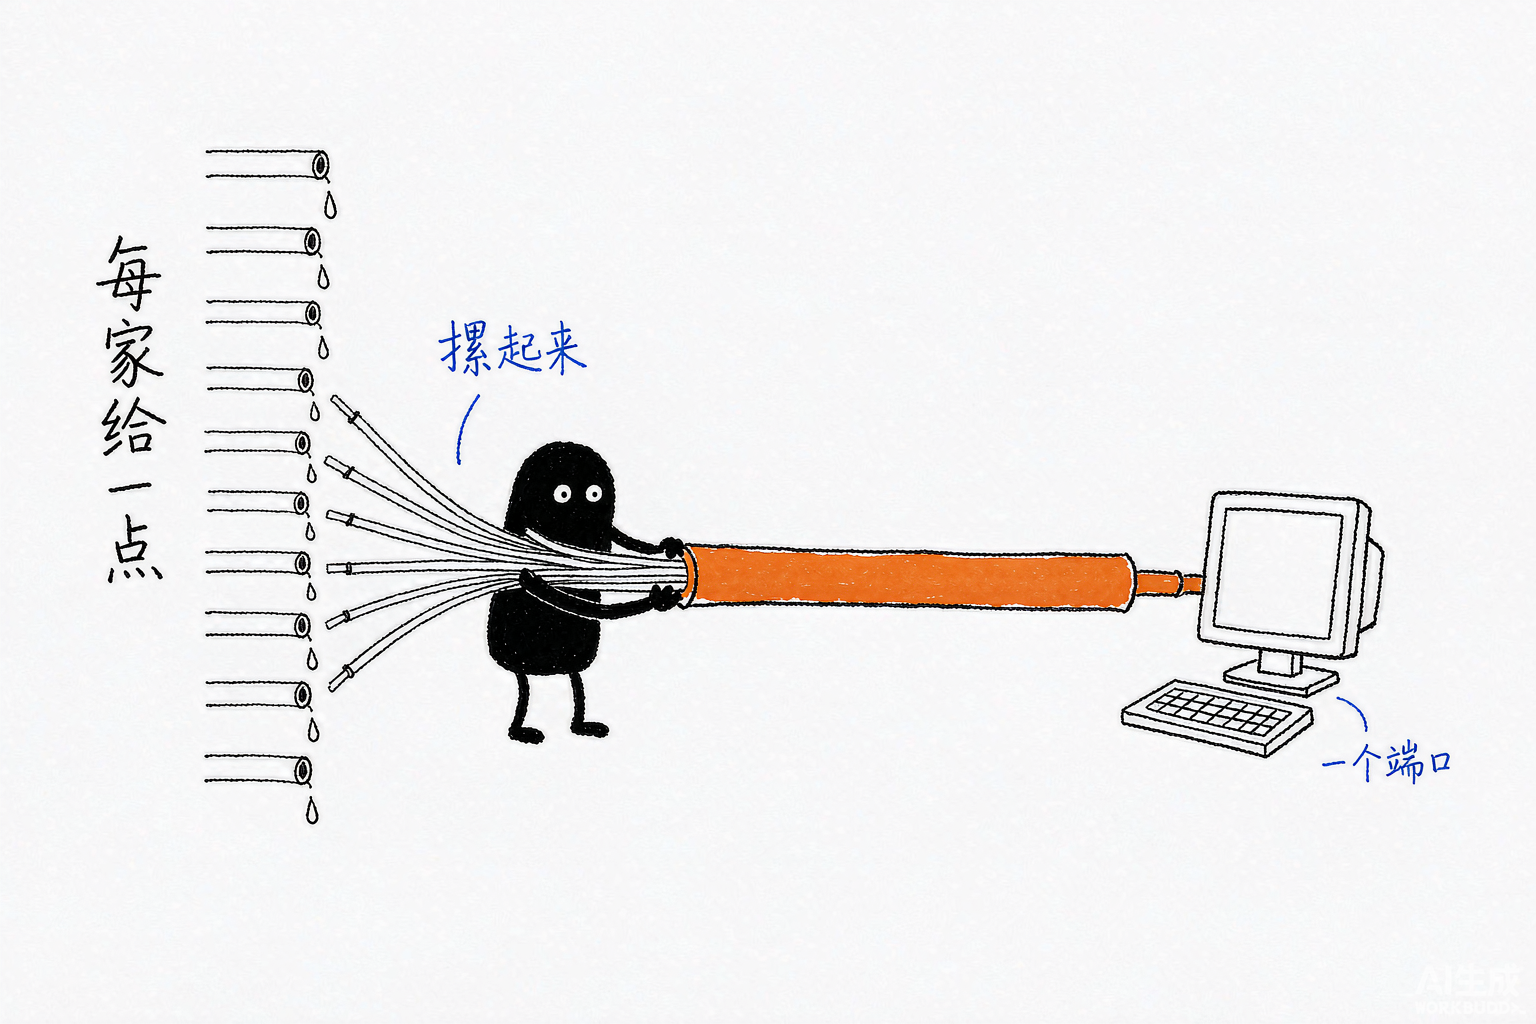
README 里 “Why this exists” 那一节写得相当直白,值得原文照抄一句:“Every serious AI lab now offers a free tier, a few million tokens a month, a few thousand requests a day. On its own each tier is a toy.”——每家厂商都给一点免费额度,单拿出来都是玩具,能跑通 demo,撑不起一个真正的应用。
但把它们摞起来就不一样了。目录当前收录的是 34 个厂商、474 个模型族、635 个免费端点,拆开看是 584 个对话、41 个嵌入、7 个语音转写、3 个视频;合起来是每月约 74 亿 tokens 的可用推理容量。这个数字对个人开发者来说已经不是”够玩”的量级,而是”够跑一个真实原型”的量级。
问题是手工摞这三十四层非常痛苦,作者的概括是三个”三十四”:“thirty-four different SDKs, thirty-four different rate limits, thirty-four places a request can fail.” 三十四套 SDK 要接、三十四套限速规则要背、三十四个地方可能让你这次调用挂掉。FreeLLMAPI 要做的,就是把这三十四个失败点收敛成一个端口、一把钥匙、一套错误处理。
二、一个 /v1 端点后面,站的是路由器不是代理
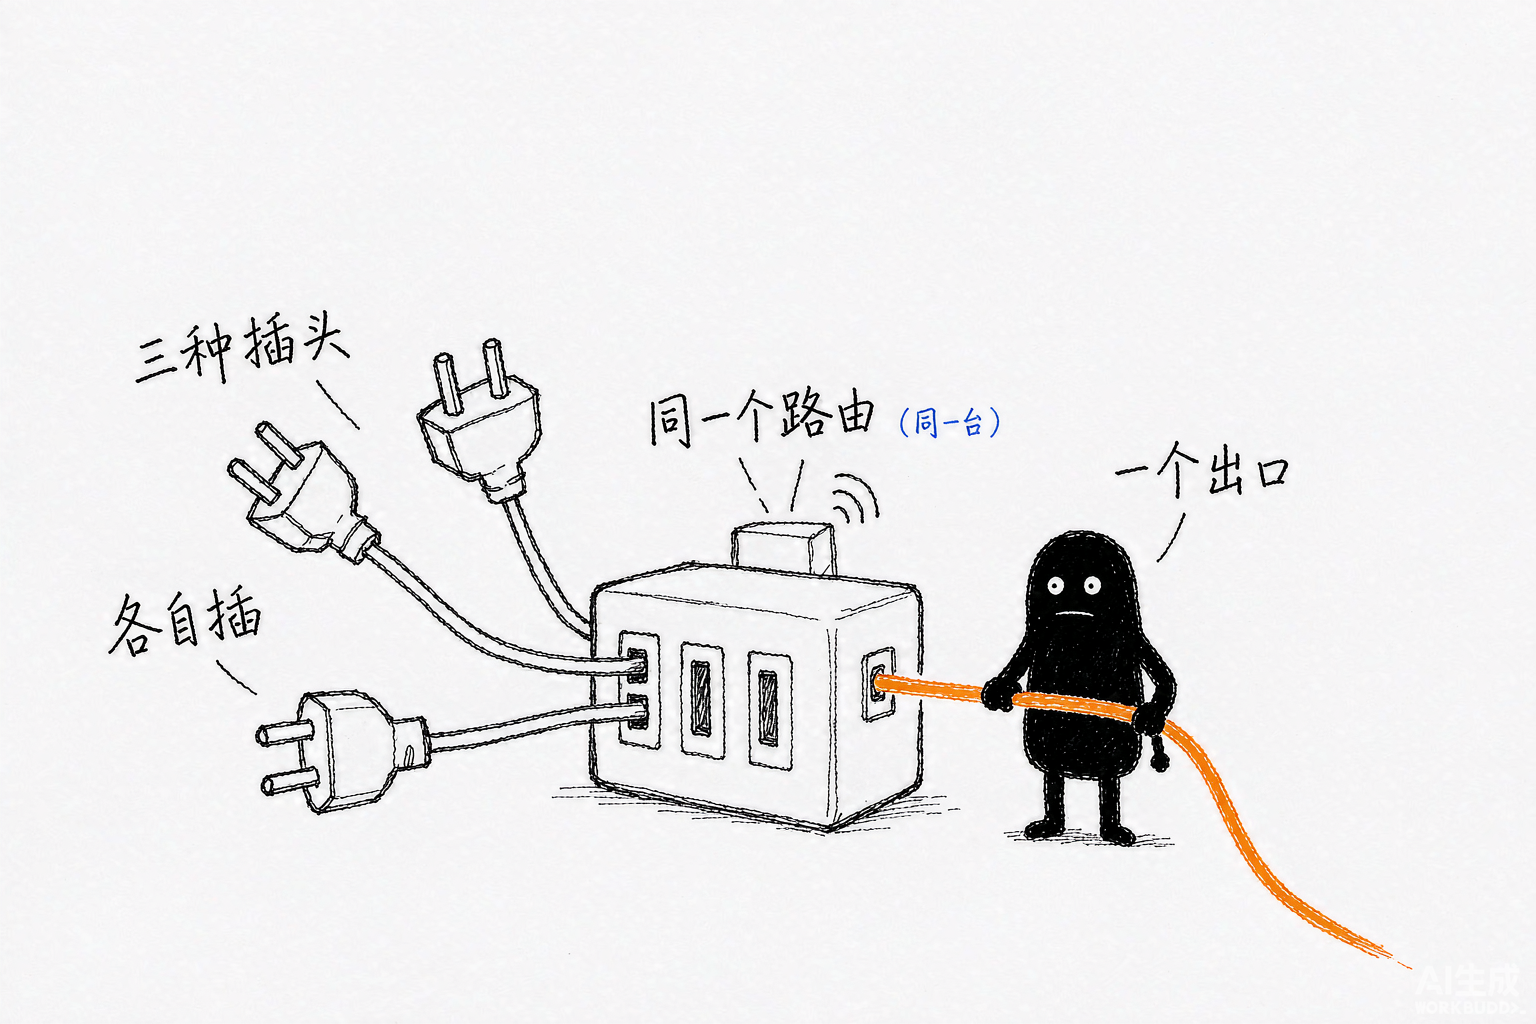
很多人第一眼会把它当成”免费 API 的反向代理”,这个理解只对了三分之一。它真正的行为是:你把任何 OpenAI 客户端库指向本地的 3001 端口,“it routes transparently across whichever providers you’ve added keys for”——请求进来后由路由器挑一家当前可用的厂商发出去,而不是固定转发给某一家。
它把 OpenAI 的表面几乎都实现了:/v1/chat/completions、/v1/responses、/v1/completions、/v1/embeddings、/v1/images/generations、/v1/videos/generations、/v1/audio/speech、/v1/audio/transcriptions、/v1/models。工具调用与结构化输出也走 OpenAI 风格的 tools 往返。
接入侧的代码量小到有点不真实——换掉 base_url 和 api_key 就够了,模型名写 auto 交给路由器选:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:3001/v1",
    api_key="freellmapi-your-unified-key",
)

resp = client.chat.completions.create(
    model="auto",
    messages=[{"role": "user", "content": "Summarise the fall of Rome in one sentence."}],
)
print(resp.choices[0].message.content)
print("Routed via:", resp.headers.get("x-routed-via"))
最后那行值得留意:响应头里带一个 x-routed-via,告诉你这次实际走了哪家厂商。对调试来说这是关键信息——同一个 auto 请求,早上和傍晚可能落到完全不同的模型上。
三、Claude Code 和 Gemini CLI 也能直接接进来
如果只做 OpenAI 兼容,它的适用面就止于”用了 OpenAI SDK 的项目”。但命令行编码代理这两年基本三分天下,于是它把另外两套表面也补齐了:Anthropic 的 Messages API 走 /v1/messages(README 明确点名支持 Claude Code),Gemini 侧则提供 /v1beta 给 Gemini CLI 用,另外还有可选的 Ollama emulation。
配置也不用手动改 JSON,官方 CLI 直接帮你写进客户端配置:
npx freellmapi setup-claude --url http://localhost:3001 --api-key <unified-key>它还同时是个 MCP server:代理可以透过 /mcp 中途查询当前可用模型、厂商健康度和路由策略,另有一个零依赖的 OpenAPI 浏览器挂在 /v1/docs。换句话说,它不只是给人用的网关,也把自己暴露给 agent 去自省。
四、Fusion:把”额度多”换成”答案好”的一个取巧用法
这是我觉得整个项目里最有意思的一处设计。既然手里同时握着几十个免费模型,那除了”这家挂了换下家”,还能干什么?README 给的答案是 Fusion:请求一个并不真实存在的虚拟模型 fusion,路由器会把你的 prompt “fans out to a panel of diverse free models in parallel”,并行发给一组不同来源的免费模型,再由 judge model 从这些草稿里综合出一份答案。
这个思路的巧妙之处在于,它把”免费额度的唯一优势——量大”转化成了免费模型本来最缺的”质量稳定性”。单个免费小模型时好时坏,但一组模型同时跑、再由裁判收敛,方差会明显小下去。当然代价也很直接:一次请求烧掉 N 份 tokens,还外加一次 judge 的开销。所以它适合的是”这一条 prompt 值得多花几倍成本换一个稳”的场景,比如批量生成训练数据、跑评测,而不是日常闲聊。
五、限速是这套系统的命门,也是它最下功夫的地方
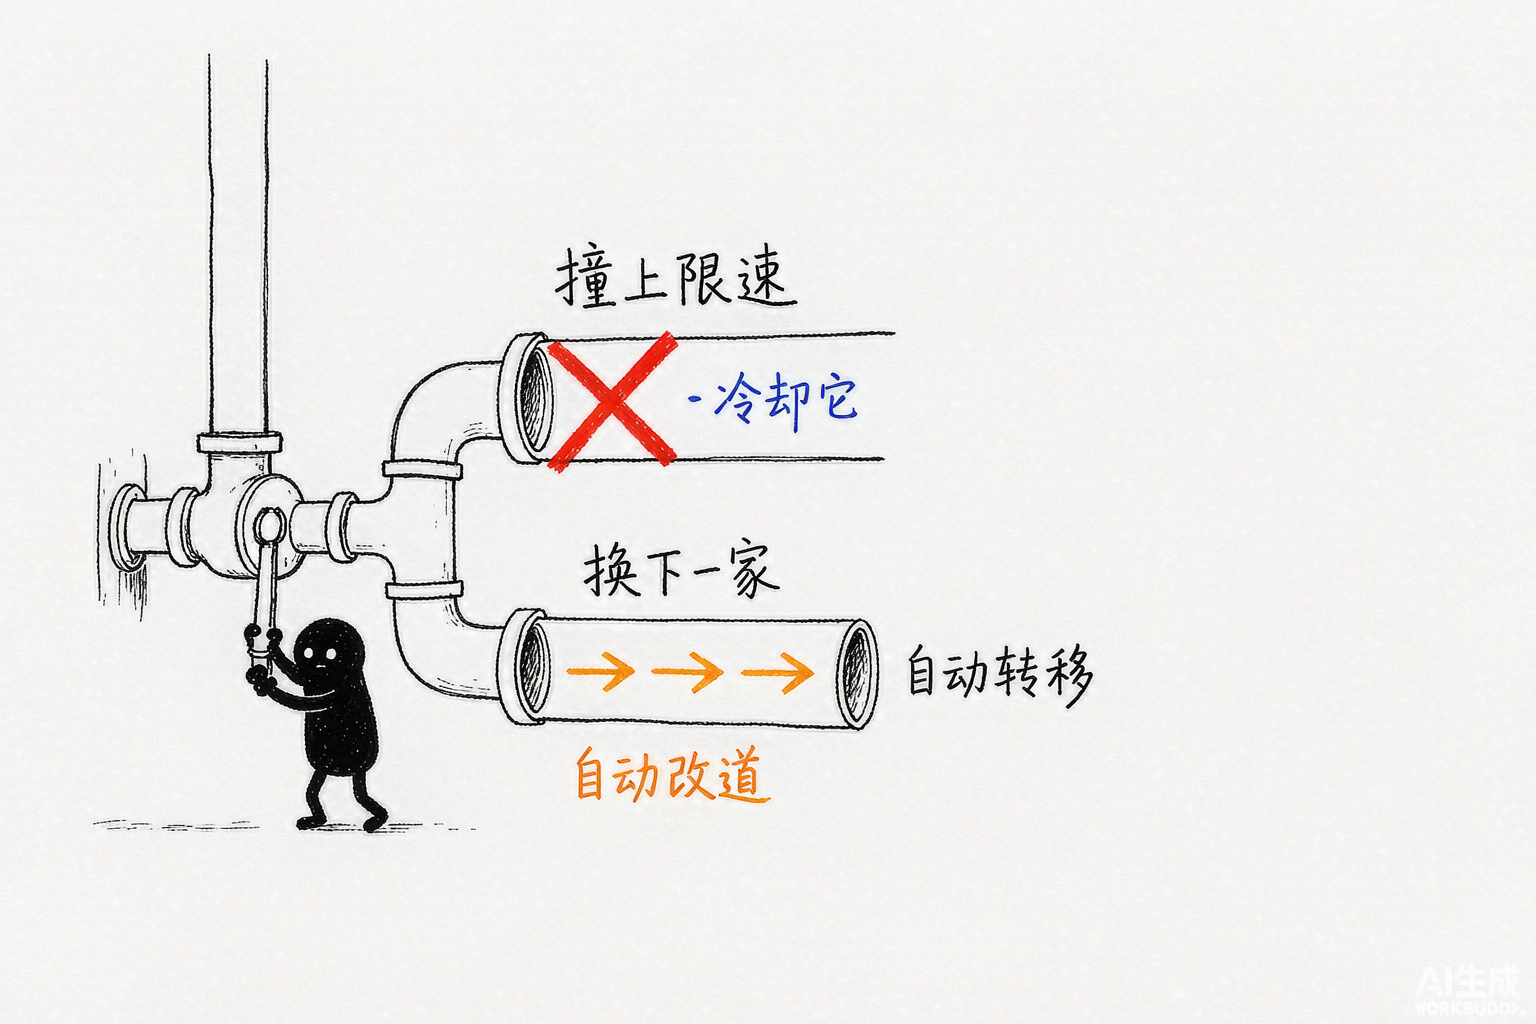
把三十四家的免费额度摞起来用,最难的不是发请求,而是不让任何一家把你掐了。FreeLLMAPI 的做法是给每个 (platform, model, key) 组合单独记账,按 RPM / RPD / TPM / TPD 四个维度计数,并且会去学习厂商自己上报的上限,让路由始终压在每一家的天花板之下。
配套的几个机制也都指向同一个目标——让”额度耗尽”这件事对用户透明。路由策略一共六档,实时评分 + 自动 fallover + cooldown + key rotation 是它的基本盘;对话层面有 30 分钟黏性会话,同一个会话尽量待在一个模型上,万一中途切换了,还有一份可选的精简 handoff 笔记把上下文接住;此外还有一个可选的请求压缩管线,能在查缓存和路由之前做 prompt 去重、过滤工具输出、压缩重复的 JSON、裁掉过期上下文,而且是 fail-open 的(压缩失败不影响请求本身)。
六、目录每天自己更新两次,Premium 卖的只是一个”时间差”
免费额度的版图是每周都在变的:厂商上线新模型、悄悄收紧配额、下线旧模型,README 的原话是 “providers launch models, retire them, and change quotas without notice”。所以路由器的模型目录不能靠你手动 git pull。
它的做法是每天两次从 freellmapi.co 拉一份签名目录,覆盖新模型、配额变更和厂商怪癖修复;每次下载都要先拿固定的 Ed25519 公钥校验通过才落本地库。你自己的启用/禁用选择和自定义厂商不会被覆盖。免费安装拉的是月度快照,一个模型进入 live feed 30 天后才会进快照——按作者的说法,“the free build currently sits about 303 models behind”,目前大约落后 303 个模型。
这里要把商业模式的边界说清楚,因为它很容易被误读成”开源项目开始收费了”:Premium 只卖 live feed 这一项,$19/年 或 $49 一次性买断,一个 fla_ key 覆盖你跑的所有路由器。原文那句承诺很硬:“The router itself stays MIT-licensed and fully free, forever.”——路由本体永远 MIT、永远免费,Premium 只是给目录同步提速,用来养活每天的模型测试。还有一句对隐私敏感的人很关键:“The catalog server never sees your prompts, completions, or provider keys.”
| 维度 | 免费安装 | Premium($19/年 或 $49 买断) |
|---|---|---|
| 路由本体 | 完整可用,MIT 永久免费 | 完全相同 |
| 模型目录 | 月度快照,滞后约 303 个模型 | 当天同步 live feed |
| 同步频率 | 每天两次(拉快照) | 每天两次(拉实时源) |
| 签名校验 | Ed25519 固定公钥 | Ed25519 固定公钥 |
| 密钥覆盖 | — | 一个 fla_ key 覆盖所有自建路由器 |
七、密钥怎么存,数据出不出你家门
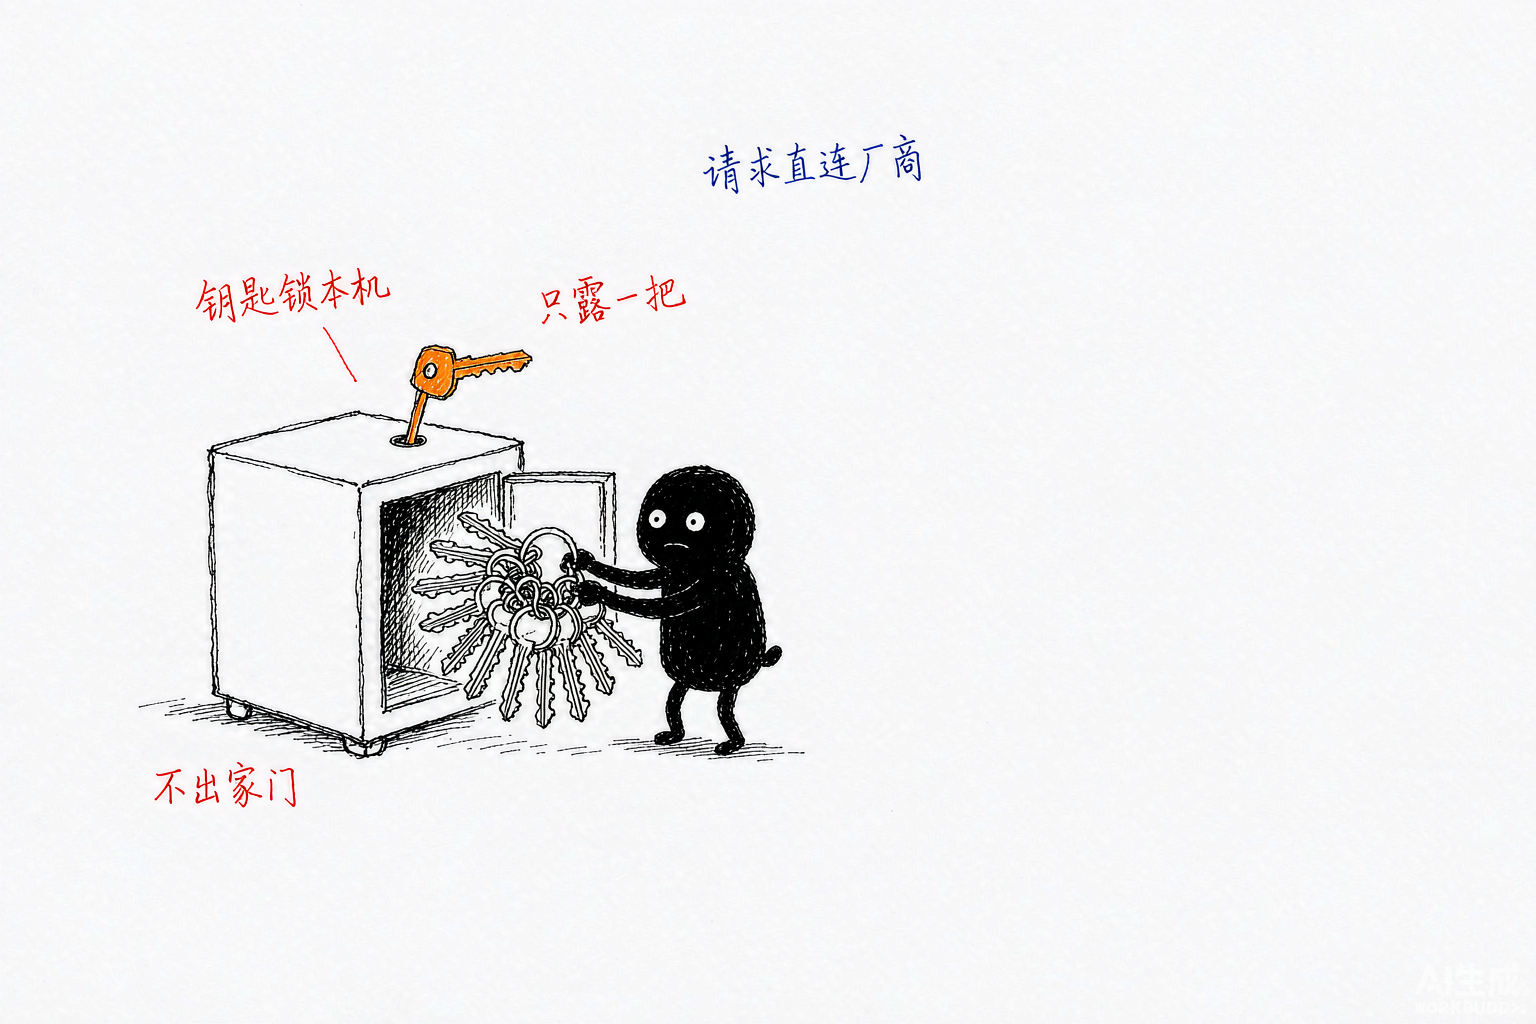
这类”聚合网关”最该先问的问题是:我的三十四把厂商密钥去了哪里。README 的答复是明确的——“provider keys are AES-256-GCM encrypted in SQLite and decrypted in-memory per request”,密钥以 AES-256-GCM 加密存在本地 SQLite 里,每次请求时在内存中解密;对外只暴露一个统一的 freellmapi-… bearer token,你的应用从头到尾只见这一把。整个项目的定位是 local-first、single-user by design:请求从你自己的机器发往你启用的上游厂商,不经中间人。
账户体系也按形态分了两种:桌面版(macOS .dmg / Windows .exe)不需要密码,dashboard 用一个隐藏的本地账户自己登录;服务器安装(Docker / 一键脚本 / npm)则需要 email + password。服务器版忘记密码也不用重装:登录页点 Forgot password,验证码会打进服务器日志,15 分钟内有效。
部署形态上它几乎没有门槛。README 一句话概括:“Runs anywhere Node 20+ runs”——Windows、macOS、Linux、ARM 单板机都行,常驻内存约 40 MB RSS。桌面版是常驻菜单栏的托盘应用;想跑在树莓派或 Android(Termux,实验性)上也有对应指南。开发模式是 npm install && npm run dev,服务端 3001、dashboard 5173,都带热更新。管理面板是 React 写的,支持 60 种语言,Analytics 页给 p50/p95/TTFT 这类延迟分位。
八、作者自己泼的三盆冷水,比功能列表更值得读
这个项目在 README 里主动写了 Limitations 和 Disclaimer 两节,措辞之直白在爆款开源项目里不多见。第一盆冷水是能力边界:“no frontier models, variable latency, no SLA”——没有前沿模型、延迟不稳定、没有任何服务等级承诺。你能拿到的是”small-and-fast 到 reasonably capable”这一档,不是 GPT/Claude 顶级档。
第二盆更具体:“the effective intelligence of the endpoint dips late in the day as top models hit their daily caps, then resets at UTC midnight.” 一天下来,好模型陆续撞到日限额,这个端点的”有效智商”会肉眼可见地下滑,直到 UTC 午夜才重置。这不是 bug,是免费额度叠出来的必然结果——也顺带说明为什么跨时区协作时它的表现会不一致。
第三盆是免责声明,原文是:“This project is for personal experimentation and learning, not production… If you build something real on top of FreeLLMAPI, swap in a paid API before you ship.” 免费额度是给开发者做原型的,不是稳定可依赖的推理底座;真要上线,换成付费 API。另外,你和每一家上游厂商之间的关系,仍然受你当初接受的条款约束,合规责任在你自己。
九、写在最后:它真正卖的不是”免费”,是”不用再管”
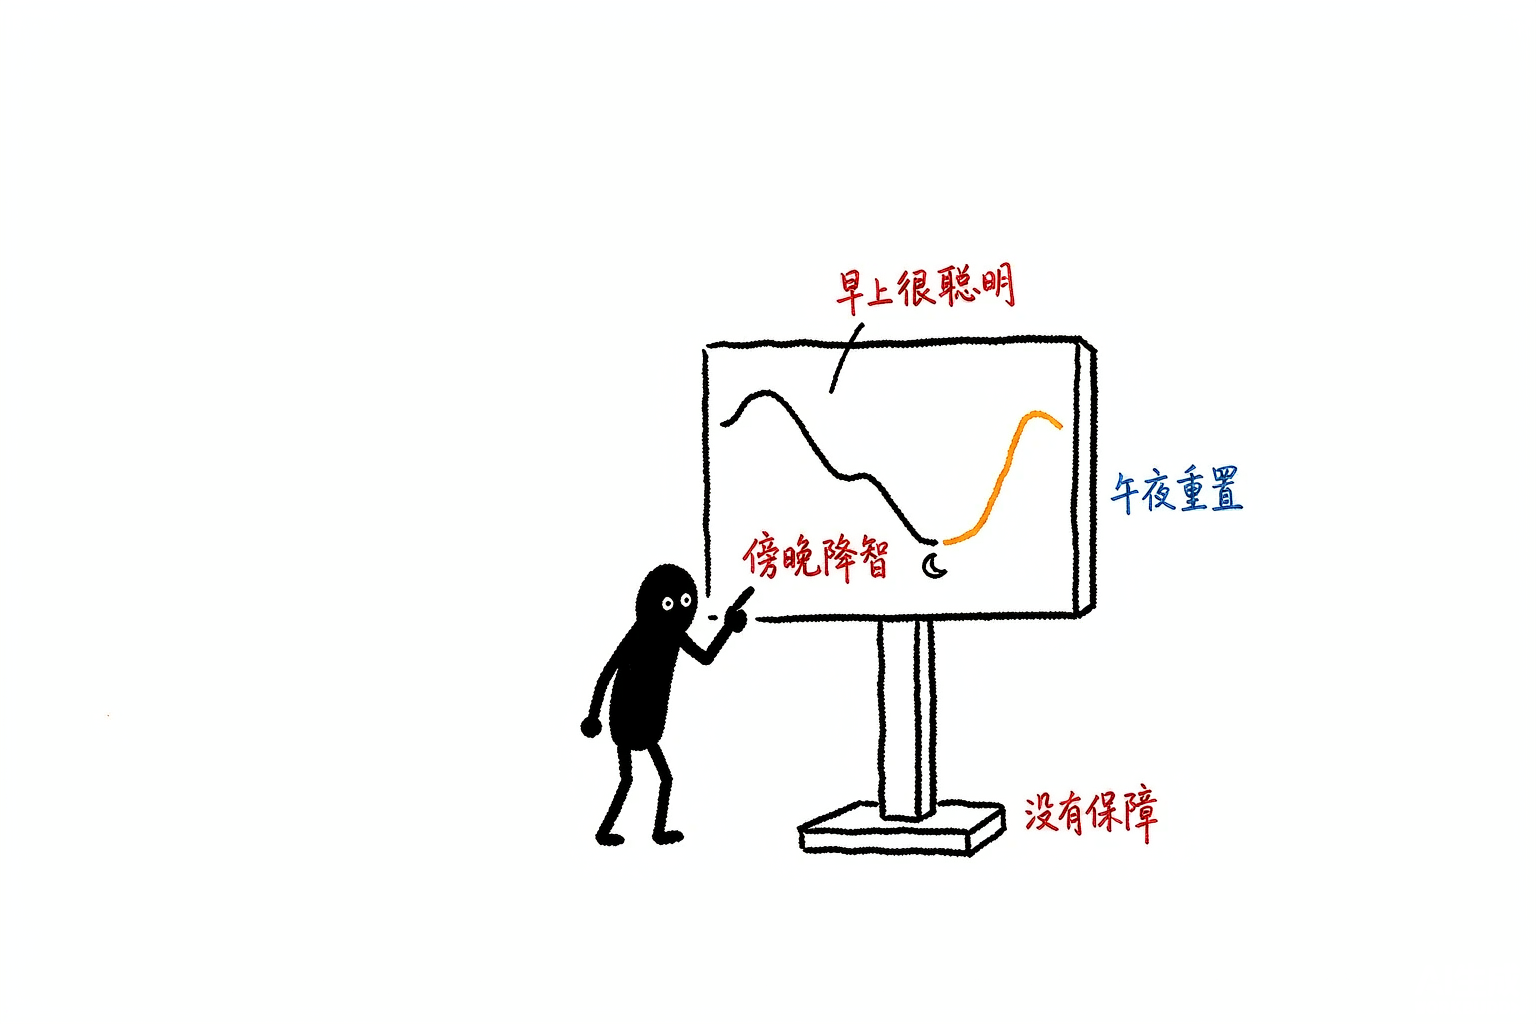
把整篇 README 读完,我最想强调的一点其实跟”免费”无关。三十四家的额度本来就在那里,谁都能去申请,但真正让人放弃的从来不是申请这一步,而是后面那串持续成本:每次换模型要改代码、每家限速规则不一样要自己做计数器、某家突然下线要在半夜爬起来改配置、新模型上线你根本不知道。FreeLLMAPI 卖的是把这一整套台账外包掉——它通过每天两次的签名目录自动跟上厂商变动,通过 per-key 的四维计数帮你压在每一家的天花板下,通过 fallover 和 cooldown 让”某家挂了”变成你根本感知不到的事件。24.6k Star 换来的不是三十四个 API key,而是「再也不用管这三十四家」这件事本身。当然,边界也要一起接受:这个端点的质量是随时间波动的,它的稳定性取决于别人施舍的额度,作者自己都不建议你拿它上线。所以最合适的用法大概是这样——原型阶段用它把想法跑通、把 prompt 调顺、把评测跑完,等到真要交付给用户那一刻,按 README 的忠告把 base_url 换回付费 API。它是一块非常好的起跳板,不是终点站。
项目地址:github.com/tashfeenahmed/freellmapi · 官网与模型目录:freellmapi.co/models · 协议:MIT







