
 AI智汇具 - AI工具推荐与技能教程_好用的AI工具大全
一句话结论:user-scanner 把过去要跑两个工具(Holehe 查邮箱 + Sherlock 查用户名)才能做完的事,合成了一个 465+ 扫描向量的命令行套件——175+ 邮箱站点、290+ 用户名平台,还能交叉扫描递归挖关联身份、对接 MCP 让 AI 自主侦察。MIT 协议,4.7k Star。但它是一把双刃工具,README 自己写了免责声明:仅限教育、授权安全研究与防御性 OSINT。
一、五个链接,五张快照:数字对不上,恰恰是重点
把五个来源并排读下来,第一反应是”你们说的到底是不是同一个东西”。HackDB 说 205+ 扫描向量,refft 说 455+,AI 产品库说 465+,GitHub 仓库现在写的是 465+(175+ 邮箱 / 290+ 用户名)。Star 数也从 4.2K、4,461 一路涨到我此刻查到的 4,699。
这些数字不是谁写错了,而是 五个来源的快照时间不同。顺着时间排下去,一个开源项目的生长曲线就自己浮出来了:
| 来源 | 快照 | 扫描向量 | Star / Fork | 当时记录的能力 |
|---|---|---|---|---|
| AI 产品库(发布页) | 最早 | 仅用户名 | — | 只依赖 httpx + colorama;输出控制台 / JSON / CSV |
| HackDB | 较早 | 205+(100 邮箱 / 105 用户名) | — | 双模分析、变体生成、--hudson、代理轮换 |
| refft | 2026-08-30 | 455+ | 4.2K / 448 | 已含交叉扫描、MCP、TLS 指纹伪装 |
| AI 产品库(专栏) | 2026-09-01 | 465+(175 / 290) | 4,461 / 454 | 当日 +93 Star,登上 GitHub Trending |
| GitHub 仓库(实测) | 2026-09-07 | 465+(175 / 290) | 4,699 / 473 | v1.5.1.1,1,376 次提交,PDF 导出、库模式 |
半年时间,扫描向量从 205 涨到 465(翻了一倍多),Star 从无到 4,699,六天内还涨了约 240 颗。这个增速本身就是一种信息:OSINT 这个领域的需求一直很硬,缺的只是一个维护得足够勤的工具。
顺带说一句,refft 那份审计里写着”缺少明确许可协议,合规与复用风险较高”和”社区活跃度极低”。我核对了仓库现状:LICENSE 是 MIT,提交数 1,376,最近一次推送是 9 月 6 日。也就是说,这条风险提示基于的是更早的快照,按现在的情况已经不成立了——这正是”多源交叉阅读”的价值所在。
二、它最早只是个”查用户名有没有被占用”的小工具
按照 AI 产品库那篇介绍的说法,user-scanner 最早是一个”用户名查重”工具——帮你在 GitHub、Twitter、Reddit、Instagram、Telegram、Minecraft、Roblox 这些地方一次性确认某个名字还能不能用。那个阶段的描述里,它”轻量级设计,仅依赖 httpx 和 colorama 两个库”。
现在的定位已经完全不同。README 开篇的自我定义是 “A powerful 2-in-1 OSINT suite engineered for deep Email and Username Intelligence”——二合一,邮箱与用户名双通道。这个”2-in-1″的分量在于:传统做法是 Holehe(邮箱枚举)加 Sherlock(用户名枚举)两个工具各跑一遍,结果格式还不一样;user-scanner 把两者合一,并且按 AI 产品库的说法,覆盖的平台数是 Holehe + Sherlock 合计的数倍,结果统一去重、统一格式。
三、它到底在查什么:不只是”有没有这个号”
很多人以为这类工具只返回一个”有/没有”。user-scanner 每个平台会给出三类状态——Registered / Not Registered / Error——第三类很容易被忽略,但它恰恰说明工具在诚实地区分”确定没有”和”这次没查到”。后者可能是被限流、被 WAF 拦了、也可能是代理节点挂了,处理方式完全不同。
更重要的是元数据抓取。README 列的是 “avatars, bio descriptions, follower counts, UID numbers, seller statuses, and account attributes”——头像、简介、粉丝数、UID、卖家状态。也就是说它回答的不是”在不在”,而是”在的话,是个什么样的号”。下面是 AI 产品库给出的一个真实输出片段:
输入:user-scanner -u kaifcodec -c dev

{
  "username": "kaifcodec",
  "site_name": "Github",
  "category": "Dev",
  "status": "Found",
  "url": "https://github.com/kaifcodec",
  "extra": {
    "name": "Kaif",
    "bio": "EMPTY.",
    "followers": "243",
    "public_repos": "28",
    "links": "https://www.instagram.com/kaifcodec"
  }
}
注意最后那个 links 字段:GitHub 主页上挂着的 Instagram 链接被抓了下来。这一条数据,就是下一节那个功能的起点。
四、Cross-Scan:真正的分水岭,也最容易出错
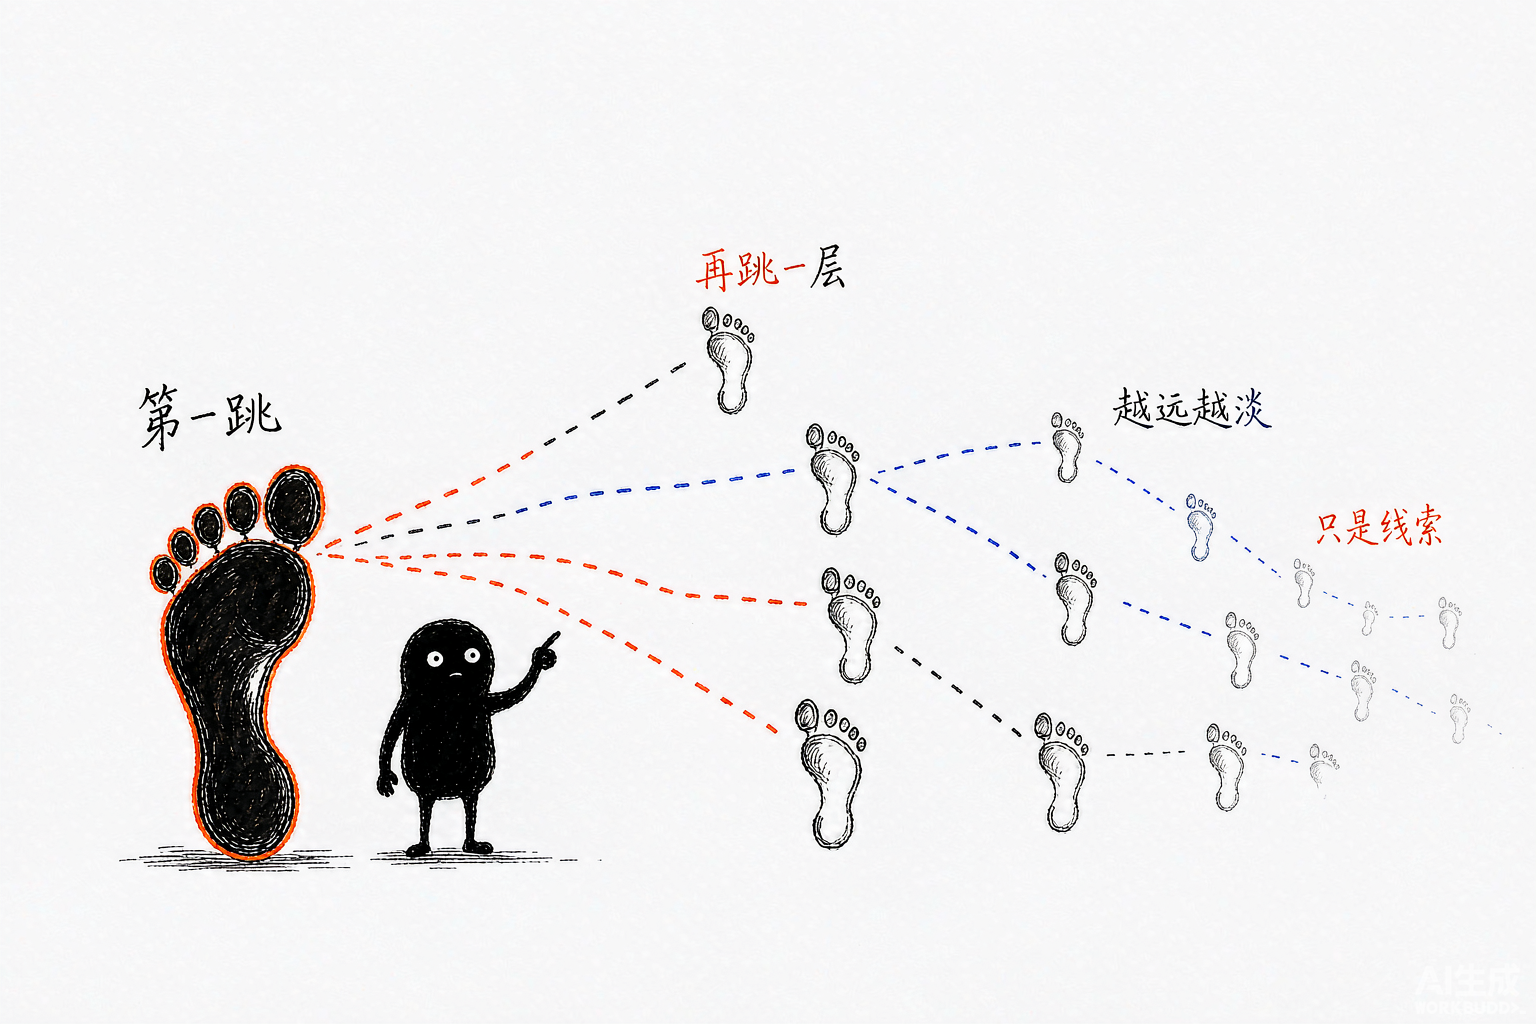
README 里有一句很关键的判断:“An email scan proves an account exists but rarely reveals a handle.”——用邮箱能证明某个账号存在,但几乎拿不到用户名。反过来,用户名也只是个字符串,不知道背后是谁。Cross-Scan 要解决的就是这两个半截信息之间的缺口:从第一轮结果里挖出外链、暴露的邮箱、别名,再以它们为输入跑第二轮、第三轮。
它支持四个方向的 pivot,README 给了完整对照:
| 跳转方向 | 挖出什么 |
|---|---|
-e → 用户名 |
邮箱已注册账号的资料页上暴露的句柄或社交链接 |
-u → 用户名 |
目标社交资料上主动公开的其他别名 |
-u → 邮箱 |
目标资料页上公开发布的邮箱地址 |
-e → 邮箱 |
首轮邮箱资料暴露出的第二个地址 |
# 以邮箱为起点交叉扫描,只采纳平台已验证的链接
user-scanner -e johndoe@gmail.com --cross-scan --cross-links verified

# 以用户名为起点,顺着链接追两跳
user-scanner -u johndoe --cross-scan --cross-depth 2
这里必须泼一盆冷水。refft 的审计把话说得很实在:cross-scan 每多跳一层,就更容易把同名但非目标的账号算进来,最终形成误关联。多跳结果应当只当”线索”用,配合多源确认、置信度打分和人工复核,不能直接当成结论写进报告。
五、Hudson Rock:从”有没有号”到”有没有中过毒”
一个 --hudson 参数,把一个”存在性查询工具”往上抬了一档。它会去查 infostealer(窃密木马)感染日志,看目标的用户名或邮箱是否出现在已泄露的日志里。
user-scanner -u johndoe --hudson
user-scanner -e johndoe@gmail.com --hudson
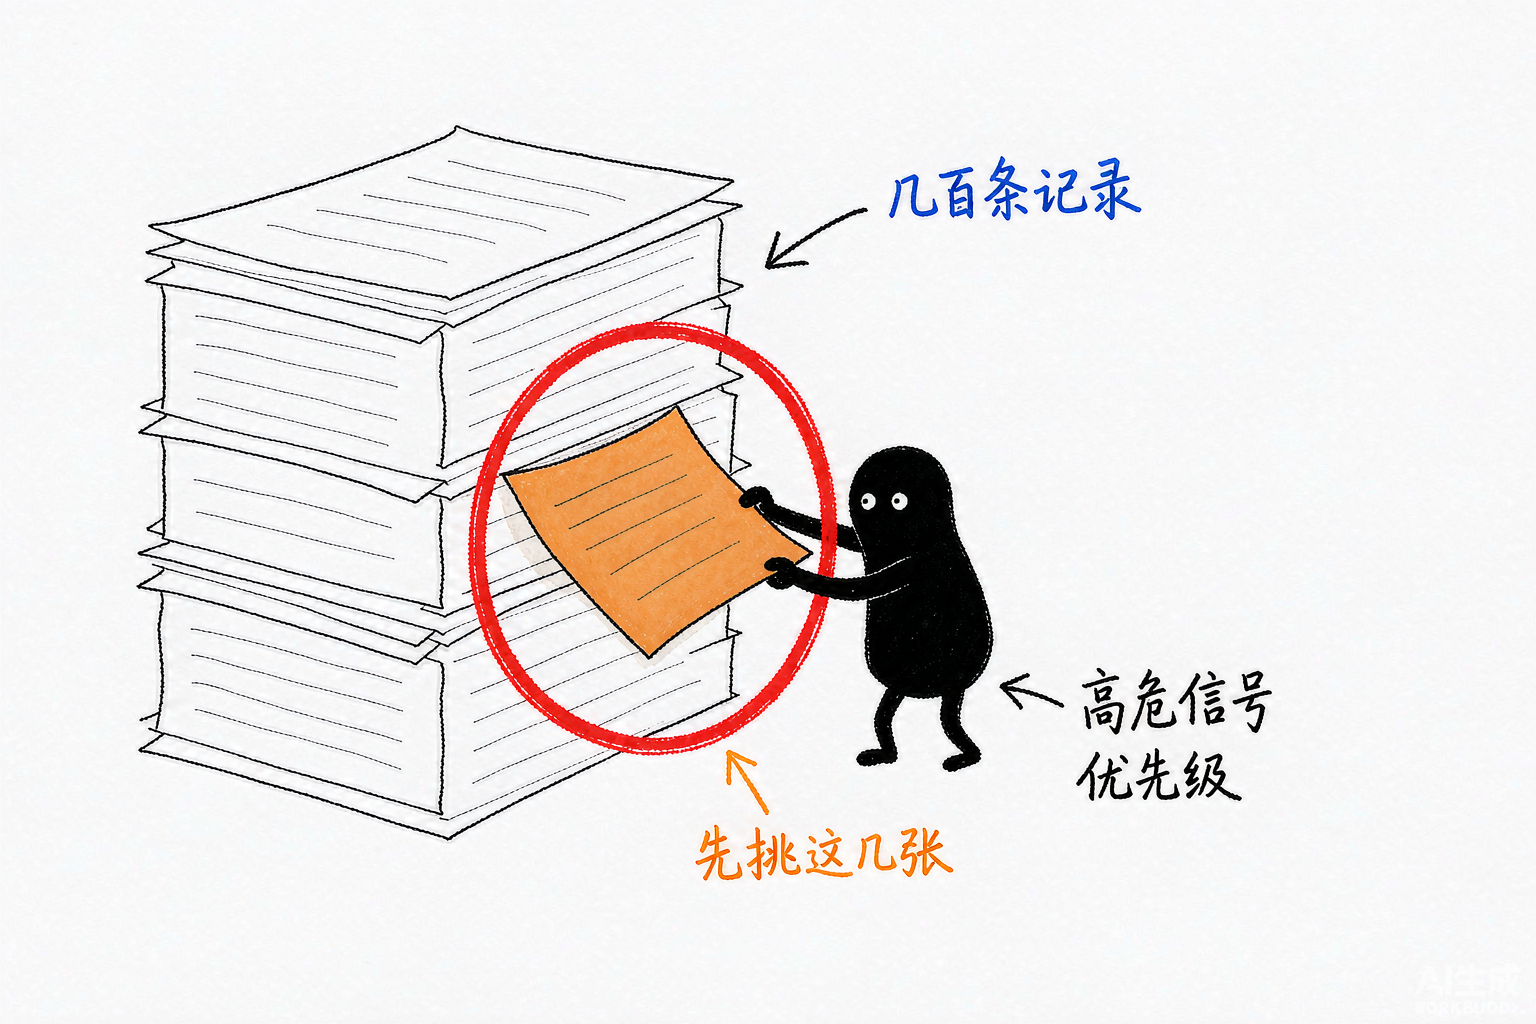
这两类信息放在一起的化学反应值得说明:“某邮箱在 A 站注册过”是低风险事实,”某邮箱出现在窃密木马日志里”是高危信号。README 把它定位为 “high-priority target correlation”(高优先级目标关联),用法上更像是一个优先级排序器——在一份长长的账号清单里,先把中过毒的那几条挑出来看。
六、MCP Server:让 AI 自己决定下一跳
这是它和其他 OSINT 工具拉开差距的地方。装上 user-scanner[mcp] 后,它能以 Model Context Protocol 的方式挂到 Claude Desktop、Cursor、Antigravity、Open-WebUI 上,把扫描能力变成三个 AI 可以直接调用的工具:
| 暴露给 AI 的工具 | 能力 |
|---|---|
scan_username |
按分类/模块定向扫描、递归 cross_scan、注入代理、调节”动静”大小 |
scan_email |
邮箱验证与账号发现、自动链接 pivot、自定义代理 |
list_available_modules |
让 AI 动态查询当前支持哪些平台和分类 |
// claude_desktop_config.json
{
  "mcpServers": {
    "user-scanner": { "command": "user-scanner-mcp" }
  }
}
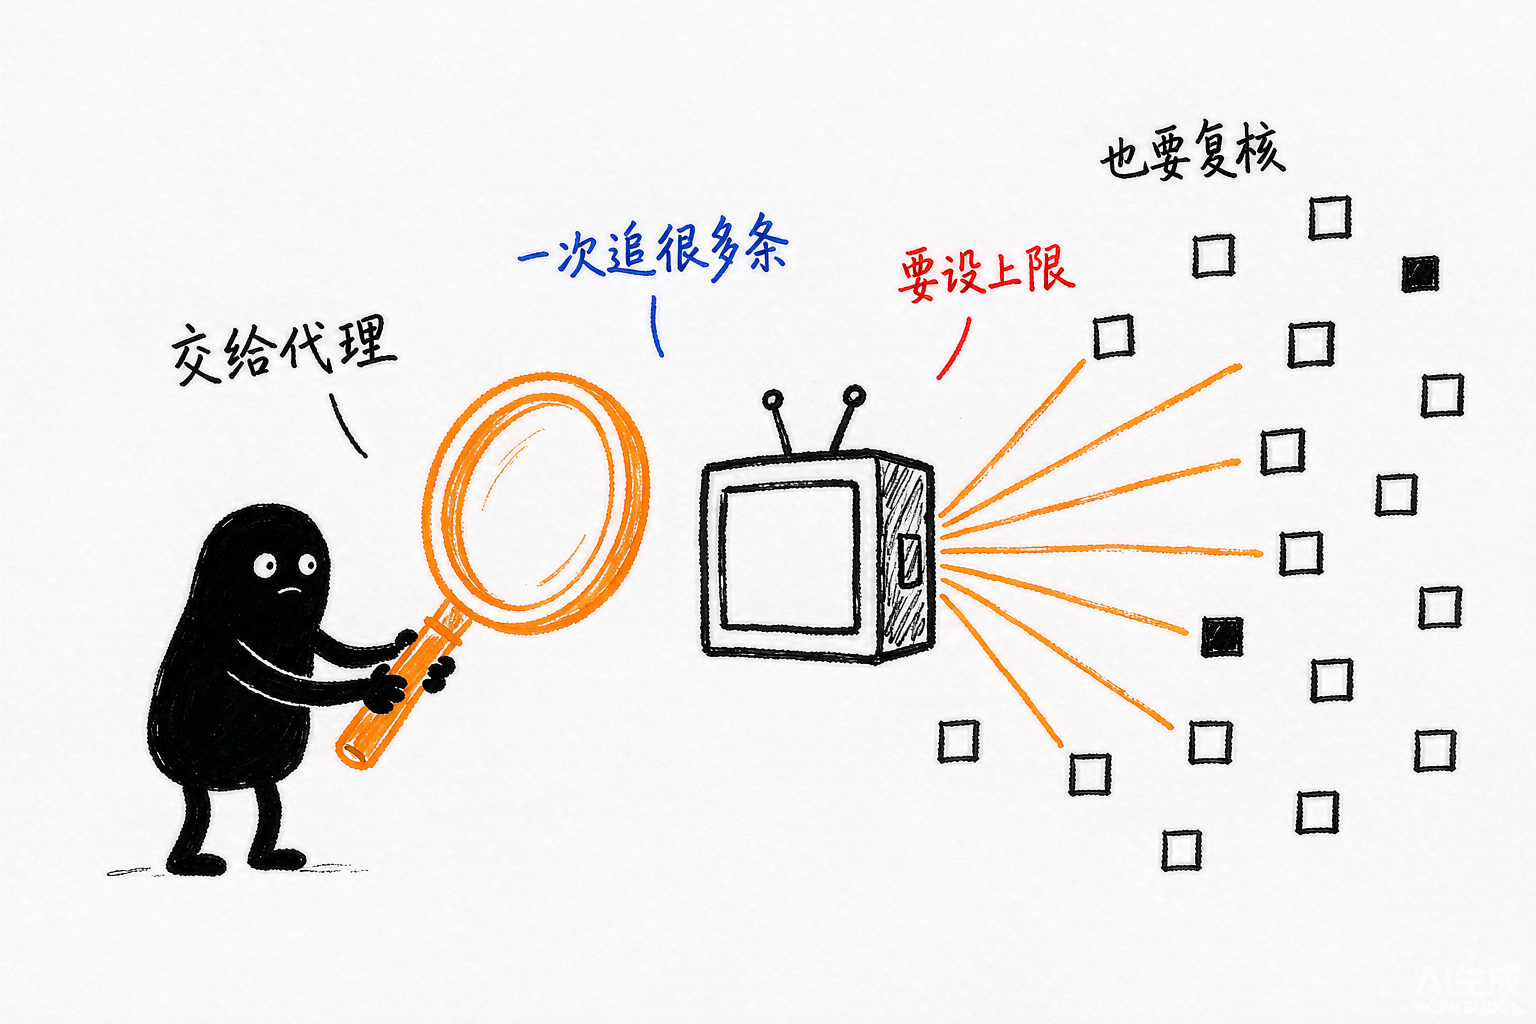
价值很直接:AI 拿到第一轮结果后能自己决定”下一步查哪个”,省掉人在中间反复敲命令。但 refft 给的三条部署建议我认为一条都不能省——放在受控网络与隔离环境、给 AI 设速率与并发上限及黑白名单、把 AI 产出纳入规则化校验。因为自动化会把误判也一起放大:人一次只会追一条线索,AI 可能一口气追出五十条错的。
七、跑得快不等于跑得对:并发、TLS 指纹与代理池
它的并发引擎由 httpx 与 curl_cffi 驱动,后者能提供 TLS 指纹伪装——让请求在协议层面看起来更像普通浏览器,而不是一个脚本。这是现在很多站点防爬之后的必备能力。
但速度快是有代价的。refft 总结的三个坑很实用:不开代理或不验证代理,会直接被 IP 限流甚至封禁;一上来就拉满并发,容易触发 CAPTCHA/WAF,反而拿到的结果更残缺;代理本身不健康检查,坏节点会拖慢整轮扫描。对应的做法也清楚——先用小样本试参数,再上 --validate-proxies 做代理预检,最后用 JSON 导出加置信度过滤做后处理。
# 带上代理池,并在扫描前做健康校验
user-scanner -u johndoe -P proxies.txt --validate-proxies
八、装上只要两行,接进管道也不难
安装走 PyPI,想用 MCP 就加个 extra;不想装也能用 Nix 直接跑。README 还注明它在 Termux、Windows、Linux 上都测过。
pip install user-scanner
pip install "user-scanner[mcp]"     # 需要 MCP Server 时

nix run github:kaifcodec/user-scanner/main -- --help   # 免安装
常用命令基本是”一个字母一件事”,记住 -u 用户名、-e 邮箱、-c 分类、-m 模块、-f 导出格式就够了。-lu / -le 会以自适应的网格列出所有可用模块,第一次用建议先跑这两个。导出支持 PDF(带头像)、JSON、CSV,PDF 适合交付人看,JSON 适合进管道。
要接进自己的系统,README 给了库模式的入口,可以绕过命令行直接调引擎:
import asyncio
from user_scanner.core import engine
from user_scanner.email_scan.shopping import etsy

async def main():
    result = await engine.check(etsy, "test@gmail.com")
    print(result.to_json())

asyncio.run(main())
九、它是双刃的:作者自己把免责声明写在最下面
这类工具绕不开一个问题:同一个功能,在红队手里是侦察,在另一些人手里就是人肉。README 的 Disclaimer 写得毫不含糊——“This tool is provided strictly for educational purposes, authorized security research, and defensive OSINT investigations. The developers assume no liability…”(仅限教育用途、授权安全研究与防御性 OSINT 调查,开发者不承担任何误用后果)。AI 产品库那篇介绍也补了一句:所有模块均为无认证的公开端点检测,严格遵守各平台 ToS。
还有一层是维护成本。README 在赞助那一节说得很坦白:“Web platforms constantly update authentication flows. Maintaining over 465+ scan modules requires around-the-clock commitment”——四百多个模块,网站的登录流程一改就得跟着改,这是一份全天候的活。所以理解这个项目,不能只看它现在能查多少站,还要看它半年后还有没有人维护这 465 个模块。目前看是乐观的:1,376 次提交,最近一次推送就在 9 月 6 日。
十、写在最后:把”知道一个名字”变成”看清一张网”
读完这五个来源,我对这个项目的判断是:它的技术门槛不高,价值全在”勤”这一个字上。查一个平台有没有这个号,原理无非是构造请求、看响应差异;真正的壁垒是 465 个模块里每一个都得有人盯着——站点改版了要修、接口限流了要调、TLS 指纹被识别了要换策略。这就是为什么同类工具不少,而它能在六天里涨 240 颗星、冲上 GitHub Trending。把 Holehe 和 Sherlock 两件事合成一件事、再配上交叉扫描和 MCP,是这个”勤”字之上最聪明的一步:前者降低了使用成本,后者把这个工具从”查号器”推到了”情报流水线”的位置。当然,边界也要一起接受。它的每一条输出都只是公开信息的重组,而重组的次数越多,同名误判的概率就越高——cross-scan 多跳出来的东西只能当线索,不能当结论;交给 AI 自动跑之前,配额、审计和人工复核一个都不能少。至于用途,README 那句话已经划好了线:教育、授权安全研究、防御性 OSINT。真正在意自己数字足迹的人,其实也应该用它扫一遍自己——看看这些年,你在多少个地方留过名字。







