
 AI智汇具 - AI工具推荐与技能教程_好用的AI工具大全
个人 RAG
本地检索
MLSys 2026
隐私优先
摘要
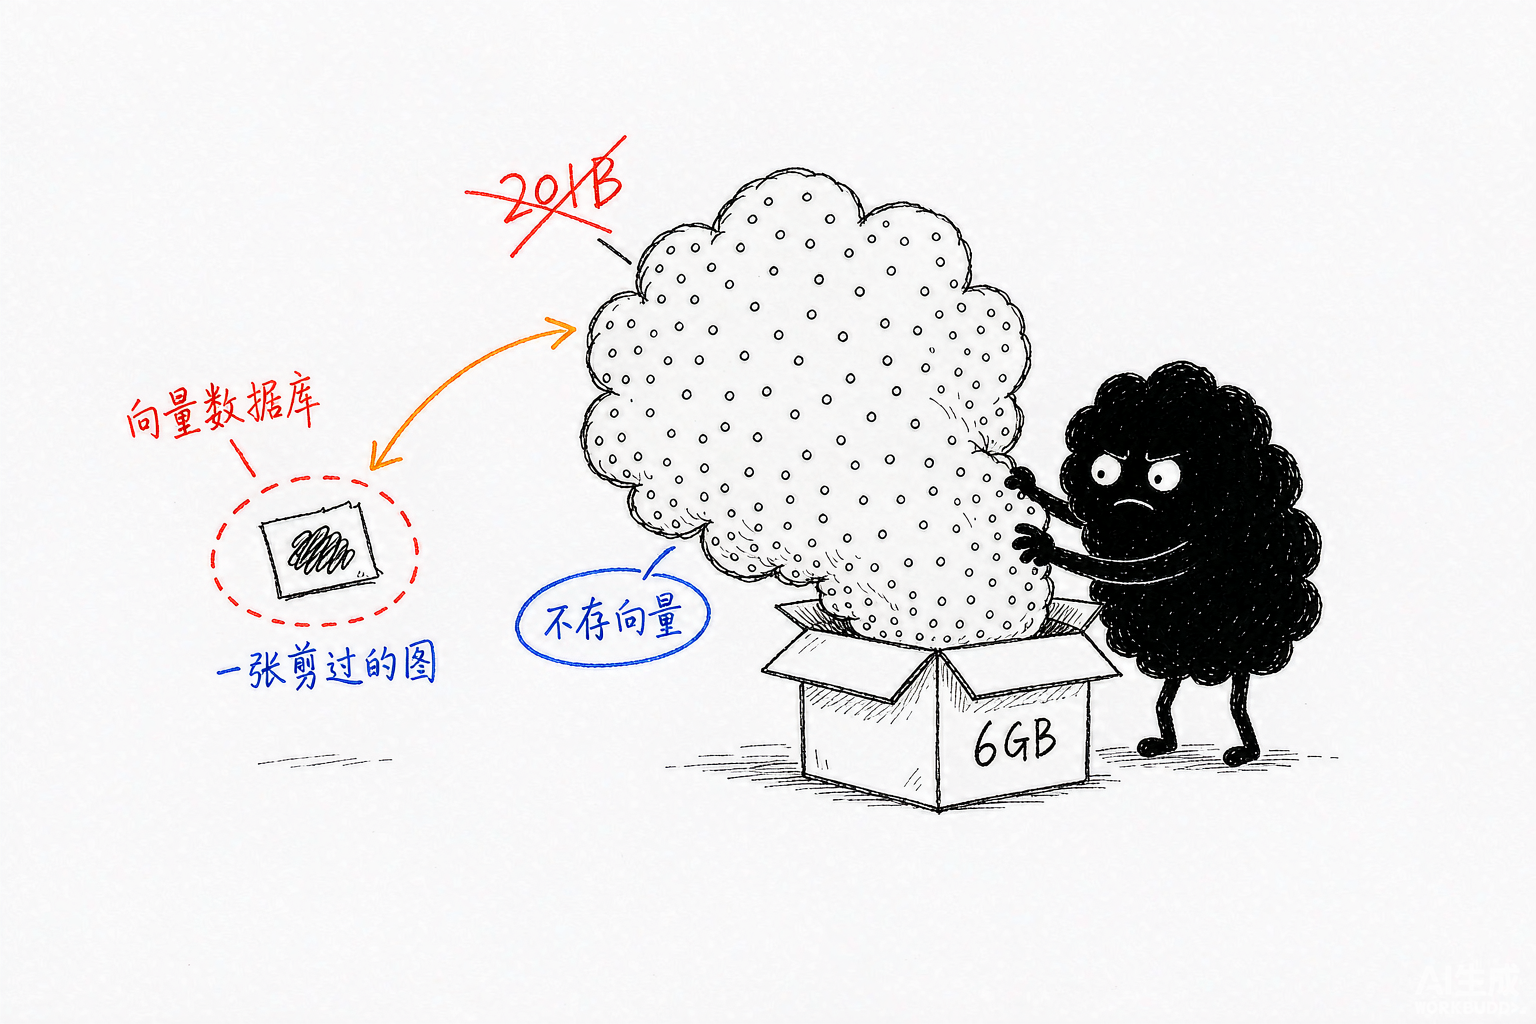
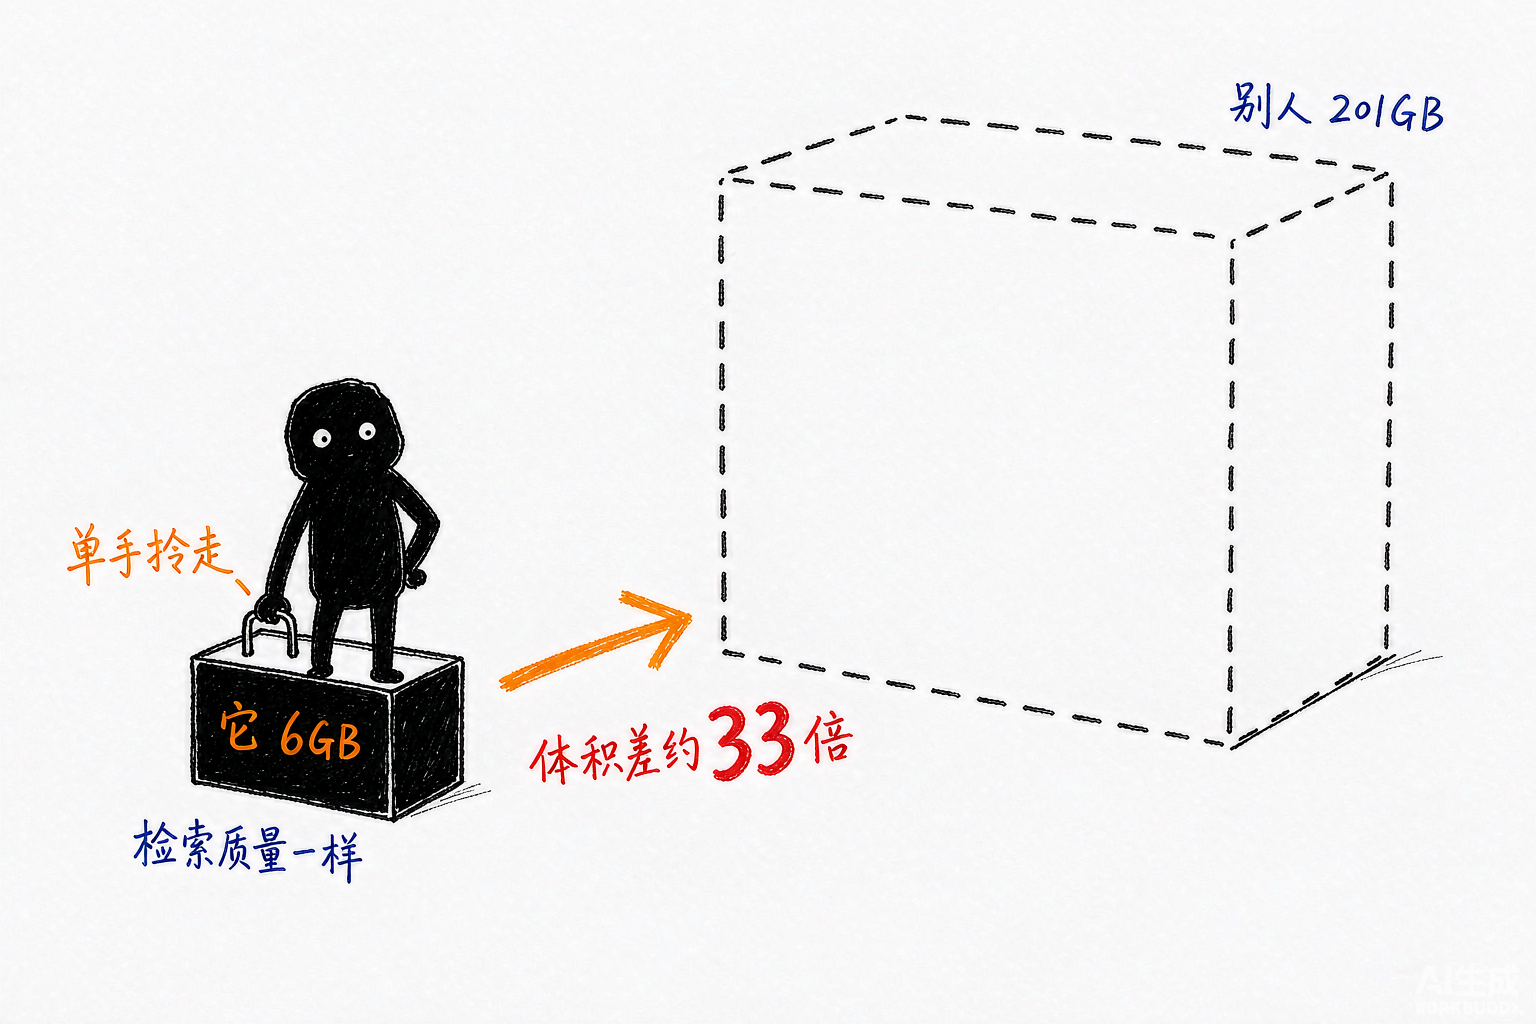
LEANN 是一个开源向量数据库,自称「世界上最小的向量索引」:它不在磁盘上保存任何嵌入向量,而是只存一张经过剪枝的图结构,在检索时按需重新计算路径上的向量,从而以零精度损失换来了相比传统方案省 97% 存储的结果——把 6000 万个文本块的索引从 201GB 压到 6GB。它由加州大学伯克利分校 Sky Computing Lab 的研究团队开发,论文获得 MLSys 2026 最佳论文,目标是把每一台普通笔记本电脑变成一个完全本地、完全私有的 RAG 系统。本文拆解它的功能、场景、技术原理与市场位置,并和 FAISS、BM25、云端 RAG 方案逐一对表。
一、LEANN 是什么
先回答最基本的问题:LEANN 是一个向量数据库——也就是给 AI 做「语义检索」的底层仓库。当你向 RAG(检索增强生成)应用提问时,系统要先把你的问题变成向量,再去一个巨大的索引里找出语义最相近的原文片段。这个索引传统上由 FAISS 这类库来维护,而它们的做法非常直接:把每一条文本的嵌入向量全部存下来。文本一多,嵌入就成了存储大户。
LEANN 的切入点就一句话:「The smallest vector index in the world. RAG Everything with LEANN!」它反过来想:既然查询时反正要把问题算成向量,那为什么要把几亿条向量提前存好?于是它只在磁盘上保留一张「图」——记录哪些文本块和哪些文本块是邻居——检索时沿着图走,只对走过的少数节点现场重算嵌入。官方给出的数字是:索引 6000 万个文本块只要 6GB,而传统向量数据库同样规模需要 201GB,节省 97%,且官方明确声称「without accuracy loss」。这项工作发表了 MLSys 2026 最佳论文(arXiv:2506.08276),项目以 MIT 协议开源,目前在 GitHub 上有约 12,900 Stars。
二、它有什么功能
LEANN 的功能面可以分成「索引什么」「怎么查」「怎么接」三层。索引层面,它通过 LlamaIndex 支持常见文档(PDF、TXT、Markdown、DOCX、PPTX 和代码文件),并专门为个人数据做了适配:Apple Mail 邮件、微信与 iMessage 聊天记录、Chrome/Brave 浏览器历史、ChatGPT 与 Claude 的对话导出都能直接建索引;对代码仓库则提供 AST 感知分块,支持 Python、Java、C#、TypeScript。检索层面,除了语义搜索,它还支持 13 种元数据过滤操作符(==、in、contains、starts_with 等),可以叠加 grep 做精确文本匹配,语义和关键词两条路一起走。应用层面,它提供 LeannBuilder、LeannSearcher、LeannChat 三个 Python 类和一组 CLI 命令(build、search、ask、watch、list、remove), watch 还能监听目录变化自动更新索引。
uv pip install leann

leann build my-docs --docs ./your_documents
leann search my-docs "machine learning concepts"
leann ask my-docs --interactive     # 直接带着索引跟本地模型对话
leann watch my-docs                 # 目录变了自动重建索引
「怎么接」这一层是它面向 2026 年生态的明显刻意设计:LEANN 原生提供 MCP Server,可以挂进 Claude Code 做代码库语义检索;也支持接入 Slack、Twitter 书签等实时数据源。嵌入模型随便换——sentence-transformers、OpenAI、Ollama、MLX 都行,也就是说整条链路可以完全离线。另外它坚持零遥测(zero telemetry),不往回传任何使用数据。
三、应用场景:几个有代入感的例子
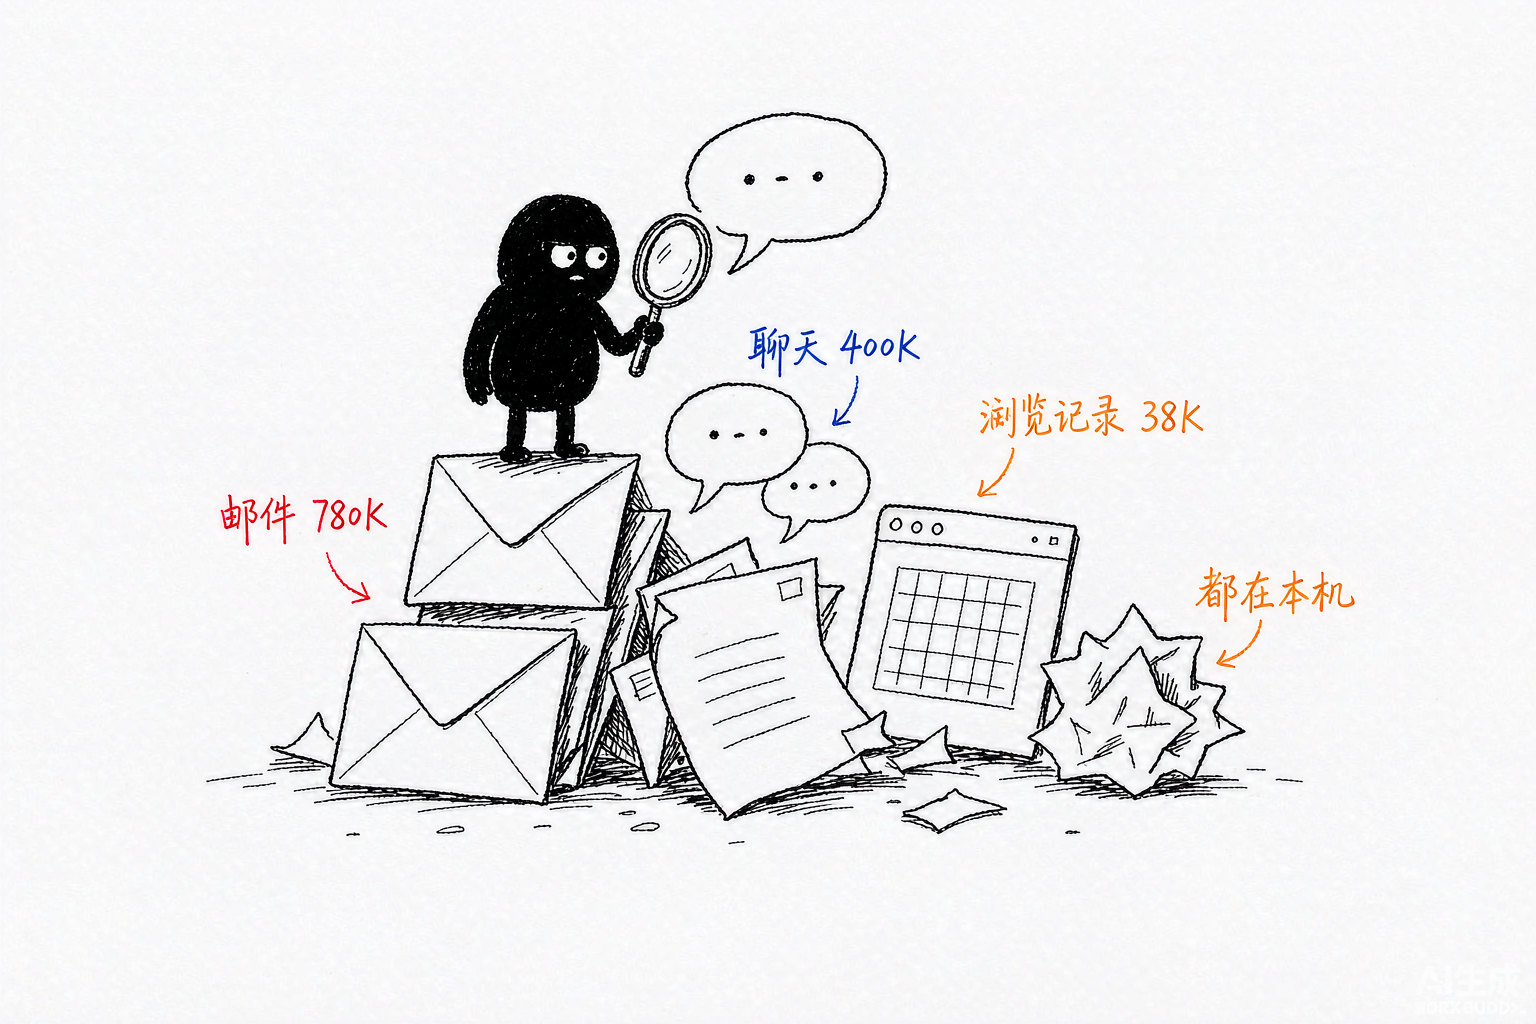
抽象地说「个人 RAG」没什么感觉,落到具体的人身上就很直观。想象三种人。第一种是邮箱里躺着几十万封邮件的上班族:LEANN 的 README 里给邮件场景的示例查询是「找出老板发的所有关于 deadline 的邮件」——78 万个文本块的 Apple Mail 索引只占 79MB,全公司没有任何人知道你在搜什么。第二种是微信里泡着几百个群的普通人:示例查询是「把所有聊周末计划的群聊翻出来」,40 万条消息的索引 64MB,多年聊天记录第一次变得可检索。
第三种是开发者。把代码仓库用 AST 分块建索引,再通过 MCP 挂进 Claude Code,让编程助手在写代码前先语义搜索整个仓库。官方在 ContextBench(30 个 SWE-Bench Pro 任务)上测过:初始相关代码召回率是 BM25 的 2.1 倍(24.2% 对 11.4%),探索之后覆盖率高 12.6 个百分点,而且 token 消耗还少了 8.4%——检索更准的同时花钱更少。此外还有两类轻量场景:把 Chrome 的 3.8 万条浏览历史压成 6.4MB 做「网页时光机」,以及把导出的 ChatGPT/Claude 对话归档成可搜索的私人记忆。这些场景共同的画像是:数据敏感、体量不小、但设备只是一台普通笔记本。
四、它的解决方案:不存向量,走哪算哪
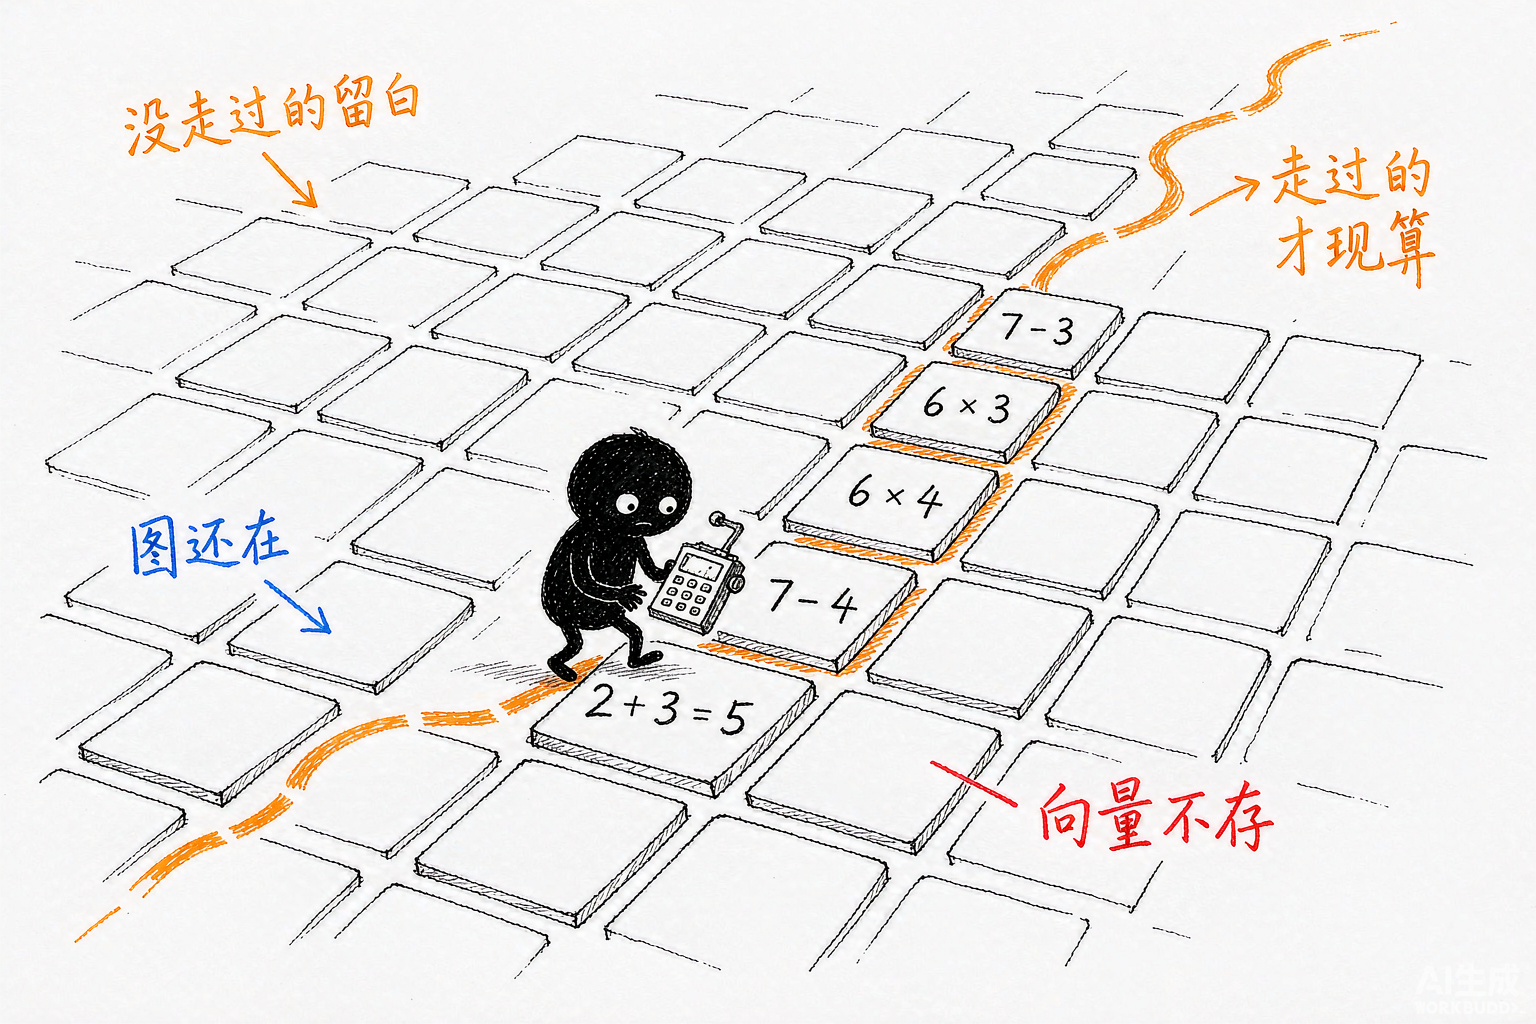
传统向量数据库的存储公式很简单:体积 = 文本条数 × 每条嵌入的维度 × 每个数字的字节。60M 条 768 维的嵌入,怎么算都是上百 GB。LEANN 的解法是把「存」和「算」重新分工:磁盘上只保留剪枝后的图结构(用 CSR 紧凑格式压到最小),嵌入向量一条都不存;查询到来时,沿着图从入口节点向目标扩散,只对这条搜索路径上的少量节点现场重算嵌入,再从中挑出最近的。官方把这概括为:「Most vector DBs store every single embedding (expensive). LEANN stores a pruned graph structure (cheap) and recomputes embeddings only when needed (fast).」
这个方案成立的前提是「算得动」。它靠两件事把重算的代价压住:一是动态批处理(dynamic batching),把路径上需要重算的节点凑成批次,尽量喂满 GPU;二是两级搜索(two-level search),先粗筛有希望的节点再做细算,避免全图乱走。代价当然存在——CPU 上查询会比纯查表慢——但它换来的 97% 存储节省让「整台笔记本的数据都能建索引」从口号变成现实,而这对个人设备来说往往才是决定性约束。
五、核心技术拆解
README 把核心技术列了四件套:基于图的选择性重计算(graph-based selective recomputation)、保高度剪枝(high-degree preserving pruning)、动态批处理和两级搜索。保高度剪枝值得单独说一句:图索引里那些连接数极高的「枢纽」节点对导航至关重要,剪枝时刻意保留它们,只删冗余边,所以图变小了但检索路径的质量不塌。
工程上它提供三种可切换的后端:默认的 HNSW 追求最大存储节省;进阶的 DiskANN 用 PQ 压缩做图遍历加实时重排序,换取更好的速度-精度平衡;新加入的 GPU FlashLib IVF 后端(flashlib_ivf,基于 Triton/CuteDSL)则冲性能——在 H200 上对 100 万条 768 维向量测试,构建比 FAISS CPU IVF 快约 13 倍,nprobe=32 时单查询延迟低约 6.5 倍、批量吞吐高约 75 倍,召回率相当。存储端的总体账本如下表,全部来自 README 的基准数据:
| 数据集 | 传统向量库 | LEANN | 节省 |
|---|---|---|---|
| DPR(210 万块) | 3.8 GB | 324 MB | 91% |
| Wiki(6000 万块) | 201 GB | 6 GB | 97% |
| 聊天(40 万条) | 1.8 GB | 64 MB | 97% |
| 邮件(78 万块) | 2.4 GB | 79 MB | 97% |
| 浏览器(3.8 万条) | 130 MB | 6.4 MB | 95% |
六、它是谁开发的:实验室,不是公司
LEANN 背后不是一家创业公司,而是一支学术团队。项目出自加州大学伯克利分校的 Sky Computing Lab,一作是 Yichuan Wang,核心维护者还有 Zhifei Li(andylizf),仓库目前托管在 StarTrail-org 组织下(原始仓库为 yichuan-w/LEANN)。论文作者列表相当豪华:13 位作者里包括 Ion Stoica 和 Matei Zaharia——分布式系统领域 Ray、Spark、Dolly 等著名项目的缔造者,也有 Sewon Min、Joseph E. Gonzalez 这样的 AI 系统方向活跃研究者。代码以 MIT 协议开源,没有企业 license 或付费墙,「研究组孵化开源项目」的典型路径,也解释了它为什么把「零遥测」和「隐私」写进核心卖点而不是商业话术。
七、市场前景
LEANN 站在三个正在变陡的趋势交汇处。其一是个人数据体量:聊天记录、AI 对话、邮件和 agent 自动生成的记忆(README 明确点名了 agent generated memory)都在指数增长,而个人设备的存储并没有同步变便宜,「检索自己的数据」正在从可选项变成刚需。其二是本地推理的成熟:Ollama、MLX 这类本地模型运行时已经把「笔记本上跑 LLM」变成日常,检索层若还必须上云,整条链路就断了——LEANN 正好补上这一环。其三是隐私合规:数据不出设备天然规避了把私人邮件、聊天记录交给第三方服务的合规负担。
当然,它的局限也来自同一个前提:重计算意味着查询延迟高于纯查表方案,对延迟极度敏感的大规模在线服务来说,FAISS 这类成熟方案仍是更稳的选择。LEANN 的机会窗口在「个人与端侧」——这个市场此前一直没有一个既省存储、又保精度、还开源的原生方案。它在 MLSys 拿到最佳论文,说明学术圈认可其系统价值;12,900 Stars 与活跃的 MCP 生态适配,则说明社区已经开始用它。若后续把 PyPI 安装体验和更多后端打磨成熟,它有相当机会成为「本地 RAG 的默认检索层」。
八、和同类方案比一比
把 LEANN 放进同类产品的坐标系里,它的差异化立刻清晰。对传统向量数据库(FAISS 等):对方存全部嵌入,LEANN 只存剪枝图,6000 万块的场景下 201GB 对 6GB,检索质量官方声称持平。对关键词检索(BM25):在 ContextBench 的编程助手场景里,LEANN 初始召回 24.2% 对 BM25 的 11.4%,翻了一倍还多。对云端 RAG 服务:对方省心但要交出数据,LEANN 数据不出本机、零遥测,还支持把整个知识库跨设备拷走。对压缩类索引(量化、PQ):它们靠降精度换体积,LEANN 靠重计算换体积,走的是正交路线——它甚至把 DiskANN 的 PQ 技术吸收成了自己的一个后端。
九、LEANN 到底想做什么
回到项目名下的那句话:「LEANN is an innovative vector database that democratizes personal AI.」它的目的不是在向量检索的跑分榜上多拿一分,而是拆掉普通人拥有「个人 AI 记忆」的三道门槛:存储门槛(97% 的节省让笔记本装得下自己一生的数据)、隐私门槛(「Your data never leaves your laptop. No OpenAI, no cloud, no ‘terms of service’.」)和可携门槛(整个知识库可以低成本地在设备之间转移,甚至分享给别人)。当这三道门槛都被拆掉,「个人 AI」才不是把隐私打包上云的营销词,而是一台离线也能回答「我去年读过什么、聊过什么、写过什么」的真正私人系统。
十、精简总结
LEANN 是伯克利 Sky Computing Lab 开源的向量数据库,拿下 MLSys 2026 最佳论文,核心思路只有一条:磁盘上不存任何嵌入,只保留一张保高度剪枝后的图,查询时沿搜索路径现场重算少量向量。代价是查询要多算几步,换来的是 6000 万文本块的索引从 201GB 压到 6GB、平均省 97% 存储,且官方声称精度无损。它开箱即用地索引邮件、微信、iMessage、浏览器历史、ChatGPT/Claude 导出和代码仓库,支持元数据过滤、grep 混合检索与 MCP 集成,编程助手场景下召回率是 BM25 的 2.1 倍、token 还省 8.4%。与 FAISS 比省 97% 存储,与 BM25 比检索更准,与云端 RAG 比数据不出本机。对想在自己笔记本上搭建完全私有 RAG 的个人用户和开发者,它是当前最值得上手的选择。
项目地址:https://github.com/StarTrail-org/LEANN · 论文:arXiv:2506.08276 · 协议:MIT







