
 AI智汇具 - AI工具推荐与技能教程_好用的AI工具大全
VoiceStudio
本地优先的开源语音工厂——克隆、声优设计、视频配音、听写、转录与有声书,覆盖 646 种语言。
AGPL-3.0
Python · Tauri
646 语言
本地优先
VoiceStudio 是一款完全本地运行的开源语音创作套件,官方把它定位为「完全本地化的 ElevenLabs 替代方案」。它把语音克隆、声优设计、视频配音、听写、转录和有声书制作整合进同一个桌面应用,底层可切换 16 个 TTS 引擎与 11 个 ASR 引擎,覆盖 646 种语言。本文从项目定位、核心工作流、引擎矩阵、整体架构、安装运行、API 接入、隐私边界、常见疑问与授权协议逐层展开,重点拆解它如何用 Tauri 外壳加 FastAPI 后端把「本地优先」落到实处。
一、项目概览:本地优先的开源语音工厂
(一)定位:完全本地的 ElevenLabs 替代
仓库的官方一句话描述是「the open-source, fully-local ElevenLabs alternative」——语音克隆、声优设计、视频配音、听写、转录与有声书创作,全部可在你自己的硬件上完成。它支持 646 种语言(实际覆盖与质量取决于所选引擎),并提供 macOS、Windows、Linux 与 Docker 四种运行形态。最关键的承诺是:本地工作流不需要账号、API Key、订阅或用量计费,数据与模型权重默认都留在你的机器上。
项目并非凭空而来。它的前身叫 OmniVoice-Studio,核心能力脱胎于 k2-fsa 的 OmniVoice 项目;默认 TTS 引擎就是基于 OmniVoice 构建的 VoiceStudio 引擎。因此它更像是一台「把多种语音能力统一收编到本地桌面」的工厂,而不是又一个只调云端接口的语音产品。
(二)工作区与引擎切换
VoiceStudio 的语音工作区从三个标签页起步:From audio 用于克隆,By design 用于从零设计一只声音,Convert 用于语音到语音的转换。顶栏的 Engines 面板把「引擎选择、已加载模型、卸载/清缓存」收拢在一起,按 Ctrl/Cmd+E 即可唤起。配音(Dubbing)界面把播放控制叠在视频之上,配合波形与带时间轴的转录同处一个紧凑编辑面;可拖拽缩放波形来平移、点击定位,翻译语言与 ISO 代码联动同步。
这种「多引擎、统一工作区」的设计是它和单一云端服务最大的差别:你不是在用一个固定的声音模型,而是在一个本地调音台里随时切换 16 种 TTS 与 11 种 ASR。
二、核心能力:从克隆到长音频的全工作流
(一)六类创作工作流
README 的 Features 表格把这些能力拆得很细,按工作流来归纳,最主要的有六类:
- 语音克隆:用一小段参考音频做 zero-shot 合成,无需训练,3 秒即可起用,5 到 15 秒通常效果更好。
- 声优设计:用年龄、口音、音高、风格与表达指令「凭空」造出一只声音,而非从某人身上克隆。
- 视频配音:转录、翻译、保留说话人、合成并导出视频,完成片段会标出时间轴问题供复核。
- 故事与有声书:多角色脚本、EPUB/PDF 导入、分章渲染,并支持 .m4b 导出。
- 听写组件:系统级快捷键、实时转录,可选本地 LLM 做文本清理。
- 批量队列:排队大批音视频任务,或监视本地文件夹自动处理新视频。
(二)工程化与本地优先
除了创作本身,它更强调「能不能稳定地本地跑起来」。几个值得记住的工程化特性:模型目录(Model Catalogue)统一安装、移除、选择并路由 TTS/ASR/LLM;GPU 自动探测(CUDA、MPS、ROCm、CPU)按引擎逐项检查;AI 水印用 AudioSeal 默认嵌入与检测,在不损伤音质的前提下给合成语音打上可溯源标记;MCP Server 让 Claude、Cursor 等客户端能直接调用合成与转录工具;再加上自检查、错误日志、诊断包等可观测能力。
它把「本地优先」写成一条硬原则:核心创作留在本地,网络功能都是显式 opt-in。这种取舍直接决定了它和托管语音服务的差异,后文会单独对比。
三、引擎矩阵:16 个 TTS 与 11 个 ASR
(一)文本转语音引擎
VoiceStudio 的 TTS 不是单一模型,而是一张可切换的引擎表。默认引擎 VoiceStudio(基于 k2-fsa/OmniVoice)覆盖 600+ 语言、支持克隆与指令控制,应用层为 AGPL-3.0,而权重与分词器另有独立条款。其余可选引擎各有侧重:
- CosyVoice 3:9 种语言加 18 种方言,支持克隆与指令,Apache-2.0。
- GPT-SoVITS / VoxCPM2 / MOSS-TTS-Nano:支持克隆的小体积或中等体积方案。
- KittenTTS / Sherpa-ONNX:纯 CPU、低内存占用,适合边缘设备。
- IndexTTS 2.5 / OmniVoice GGUF / Supertonic 3 / dots.tts / Confucius4-TTS:按需安装或注册的轻量/量化变体。
README 特别提醒:不能克隆的引擎无法在配音或固定声音的批量任务里保留参考说话人,遇到这类任务 VoiceStudio 会直接拒绝,而不是偷偷换引擎。重型引擎有独立的内存与平台限制,选之前要看对应引擎指南。
(二)语音转文本引擎
ASR 侧同样是一张表,默认是 WhisperX,适合配音、字幕与词级时间轴。其它选项包括 Faster-Whisper(通用跨平台)、MLX Whisper(Apple Silicon)、PyTorch Whisper(CUDA/MPS/CPU 回退)、Parakeet(英/欧盟语言快速转录)、Moonshine(低功耗低延迟 ONNX)、FunASR(带 VAD 与内联说话人分离)、sherpa-onnx(流式 CPU 听写),以及可配置 OpenAI 兼容服务器(音频只发往你指定的那台服务器)。WhisperX 与 Faster-Whisper 在缺少 float16 时会自动以 int8 重试。
四、架构解析:Tauri 外壳如何驱动引擎注册表
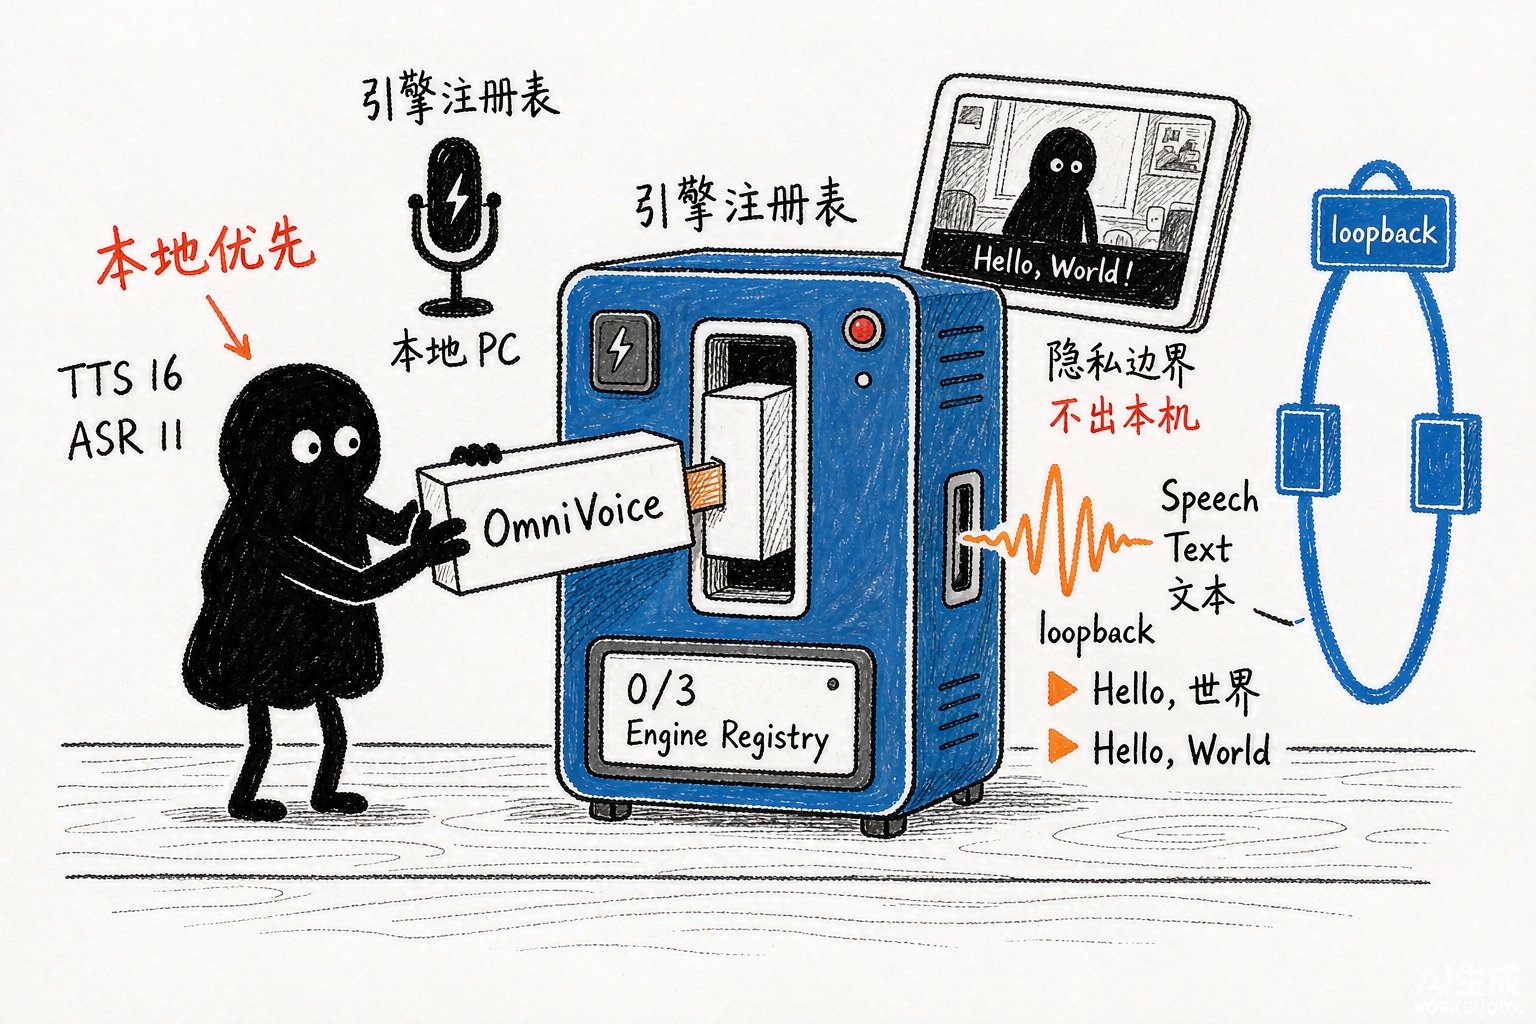
理解 VoiceStudio 最好的方式,是看它怎么把「一个桌面 UI」和「一堆互相独立的语音引擎」缝在一起。README 给出的架构非常清晰:最外层是 Tauri v2 桌面外壳(Rust 编写),通过 IPC 与 React + Vite 前端通信;前端再经 localhost:3900 的 HTTP/SSE/WebSocket 打到 FastAPI 后端;后端内部挂着 TTS/ASR 引擎注册表、配音/音频/长音频流水线、OpenAI 兼容 API 与 MCP Server,最后落到 SQLite + Alembic 的 omnivoice_data/ 目录。
(一)网络边界与隐私设计
这套分层里最值得玩味的是网络边界。桌面端只和本机的 loopback 后端通信,loopback 调用无需服务密钥;远程访问才需要分享 PIN 或 API Key。远程 worker 与 OpenAI 兼容 ASR 都是 opt-in,且非 loopback 端点强制 HTTPS、不跟随重定向。分析统计默认关闭,开启后也只发送白名单、无内容的用量元数据,绝不发送文本、音频、文件名或项目。换句话说,「数据是否出门」完全由你的配置决定,默认留在本地。
五、安装与本地运行
(一)桌面端安装
最省事的方式是从最新 Release 下载对应平台包:macOS 13.3+ 用 Apple Silicon DMG,Windows 10/11 用 x64 MSI(可选当前用户版本免管理员安装),Linux 用 AppImage(x86_64、glibc 2.39+)。首次启动会创建受管理的 Python 环境并下载默认模型,之后复用。macOS 首次启动需右键后点「打开」放行;Intel Mac 无法跑本地 Python 后端,只能连远程后端。
(二)Docker 快速启动
不想装桌面环境,可以直接起容器:
docker run -d -p 127.0.0.1:3900:3900 -v omnivoice-data:/app/omnivoice_data --name voicestudio palashdeb/omnivoice-studio:stable官方提供 CUDA、ROCm、CPU 与仅 worker 的 GPU 镜像配置。注意上面把端口绑定在 127.0.0.1,正是为了守住 loopback 边界。
(三)从源码运行
需要改代码或做二次开发,先装好 Node 20+/Bun 与 Python 3.11+,再:
git clone https://github.com/debpalash/VoiceStudio.git
cd VoiceStudio
bun install
bun run desktop
桌面启动器首次运行会通过 uv 自动配置 Python 依赖;bun run dev 则用于浏览器 UI。环境故障时可执行 uv run python backend/main.py –diagnose –deep 做深度自检查。
六、把本地语音接进工作流:OpenAI 兼容 API
VoiceStudio 最有「工程价值」的一点,是它把本地后端暴露成 OpenAI 兼容的音频 API。只要把基址从云端指到本地即可:
base_url='http://localhost:3900/v1'支持的端点包括 POST /v1/audio/speech(TTS,输出 mp3/opus/aac/flac/wav/pcm,用 voice 选声音、model 选引擎)、POST /v1/audio/transcriptions(STT,输出 json/text/verbose_json/srt/vtt)、WS /v1/audio/transcriptions/stream(实时 PCM/WebM 流式转录),以及 GET /v1/audio/voices 列出本地声音档案。一段最小可跑的 Python 示例:
from openai import OpenAI
client = OpenAI(base_url='http://localhost:3900/v1', api_key="local")
with client.audio.speech.with_streaming_response.create(
    model="tts-1", voice="<profile-id>",
    input="Made on my own hardware.", response_format="wav") as r:
    r.stream_to_file("speech.wav")
此外它还挂载 MCP Server(http://localhost:3900/mcp),给 Claude Desktop、Cursor 等提供 generate_speech、clone_voice、transcribe 工具;需要 stdio 传输的客户端可用仓库自带的本地 shim。这让它不只是个桌面软件,而能嵌进 Agent 与 CI 工作流。
七、本地优先的隐私边界与合规
README 在 Comparison 一节把 VoiceStudio 与典型托管语音服务做了直白对比:托管服务的音频与文本由服务商处理,按订阅或计量计费,通常依赖网络;VoiceStudio 默认本地、远程功能 opt-in,免费软件由你自备硬件,离线可用,源码/引擎/模型/API/路由全部开放,代价是你自己管更新、磁盘与算力。
在「负责任的语音使用」一节,项目给出了三条底线:同意——只克隆或合成你获得明确授权的声音;溯源——默认集成 AudioSeal 不可感知水印,用于检测与识别合成语音;本地隐私——默认工作流下录音、转录、声音与项目严格留在本地磁盘,只有当你显式配置远程 worker 或外部 ASR 端点时数据才会离开设备。这对于涉及真人声音的创作尤其重要。
八、常见问题答疑
Q1:Apple Silicon 和 Intel Mac 都能用吗?
Apple Silicon 支持 MPS 与 MLX;Intel Mac 因缺少可用的 PyTorch 本地后端无法跑本地推理,只能连接远程后端。
Q2:需要多少显存?
GPU 可选。加速工作建议至少 4 GB 显存,默认多阶段工作流建议 8 GB+;部分重型引擎可能要 12 到 16 GB 甚至更多。
Q3:更长的参考音频一定会让克隆更好吗?
不会。克隆是 zero-shot,参考音频是「提示」而非训练数据。用 5 到 15 秒、单人、贴近麦克风、无音乐噪声混响的片段最有效。
Q4:生成的音频能商用吗?
应用层 AGPL-3.0 不限制生成音频,但并不授予模型单独条款下的权利。默认 OmniVoice 权重标为 CC-BY-NC,分词器另有社区条款,商用前需逐一核对所选模型条款。
Q5:它会收集我的数据吗?
默认不收集。分析统计默认关闭,开启后也只发白名单、无内容元数据,文本、音频、文件名、声音、项目均排除在外,可在「设置 → 隐私」中管理。
九、授权协议
VoiceStudio 整体以 AGPL-3.0 发布:你可以运行、修改、内部使用它。应用层许可本身不限制销售生成音频,但下载的模型与分词器条款可能限制。关键的一点是 AGPL 的-network 条款:如果你修改了 VoiceStudio 并以网络服务形式提供,必须按相同许可提供对应源码。项目也为 VoiceStudio 自有代码提供商业许可,但不重新授权第三方模型。可选引擎与下载模型保留各自许可;内置 omnivoice/ Python 代码为上游 Apache-2.0,默认下载权重与音频分词器使用独立条款。
十、总结
VoiceStudio 的价值不只在「免费替代 ElevenLabs」,更在于它把语音创作的控制权还给了用户:一套 Tauri + FastAPI 的本地架构,一张 16 TTS / 11 ASR 的引擎矩阵,一个 OpenAI 兼容的接入面,以及默认本地、显式 opt-in 的隐私边界。对重视数据安全、需要离线作业、或想把自己的声音工作流接进 Agent 的开发者来说,它是一个少见的、工程化完整且真正「可自托管」的语音工厂。
随着本地推理硬件与小型语音模型的成熟,这类把云端能力收编回本机的开源套件会越来越重要。若你正打算摆脱按量计费的托管语音服务,VoiceStudio 值得放进候选清单。
语音克隆与合成涉及肖像权与声音权。请仅在获得明确授权的前提下克隆或合成他人声音,遵守所在地法律法规与所选模型的授权条款,切勿将技术用于冒充、欺诈或侵权用途。
在撰写本文的过程中,我主要参考了 GitHub 仓库 debpalash/VoiceStudio 的 README、引擎指南与官方文档站 voicestudio.sh。文中数据(Star 数、引擎数量、语言数等)以仓库公开信息为准,可能随版本更新而变化。
本文由 AI 辅助整理,基于 GitHub 项目 debpalash/VoiceStudio 的公开文档撰写;配图由后续生成上传。内容仅用于技术介绍,相关使用请遵守法律法规与模型授权条款。







