
 AI智汇具 - AI工具推荐与技能教程_好用的AI工具大全
TimesFM
TimesFM(Time Series Foundation Model)——Google Research 预训练的时间序列基础模型,用于时间序列预测。
代码 Apache-2.0
Python
3.0 版本
Google Research
TimesFM(Time Series Foundation Model)是 Google Research 开发、用于时间序列预测的预训练基础模型。它采用 decoder-only 架构,把「预测未来」当成一种生成任务来处理。最新的 TimesFM 3.0 引入了原生多变量预测与灵活的协变量支持,并在 fev-bench、TIME Benchmark、GIFT-Eval 三大基准上拿到第一。本文从它的出身与版本演进、3.0 的核心能力、权重许可红线、安装方式、单/多变量代码实战,到适用边界逐步展开,帮助你判断是否值得把它放进预测工具链。
一、它是什么:Google 的时间序列基础模型
(一)出身与定位
TimesFM 的全称是 Time Series Foundation Model,是 Google Research 推出、用于时间序列预测的预训练基础模型。对应的论文是 ICML 2024 的「A decoder-only foundation model for time-series forecasting」。它的思路与语言模型一脉相承:用一个 decoder-only 的Transformer 在海量时间序列上做预训练,之后面对新的序列时以 zero-shot 的方式直接预测,无需针对每个数据集重新训练。仓库明确提醒:这个开源版本并非 Google 官方正式支持的产品。
不过它并非只停留在论文里。README 列出了 TimesFM 在 Google 自家产品中的落地:BigQuery ML 提供企业级的 SQL 查询接口,主打可扩展与可靠;Google Sheets 把它接进日常表格做预测;Vertex Model Garden 则提供容器化端点,便于被 Agent 调用。这些一手落地侧面说明,它已经被当作真实可用的预测能力在打磨,而不只是研究玩具。
(二)检查点与版本演进
当前最新模型版本是 TimesFM 3.0,检查点发布在 google/timesfm-3.0-pytorch。在此之前的版本中,2.5 是一个重要的轻量化节点:参数量从 500M 降到 200M,上下文长度从 2048 提升到 16k,并新增一个可选 30M 分位数头做最长 1k 步长的连续分位数预测,同时去掉了 frequency 指示符、增加了若干预测标志。更早的 1.0 与 2.0 代码归档在 v1 子目录,可通过 pip install timesfm==1.3.0 装旧版来加载。
从 2.5 发布(2025 年 9 月)到 3.0 之间,仓库持续补齐工程化能力:先给出了基于 Flax 的更快推理版本,通过 XReg 加回了协变量支持,补齐了文档、示例与 Agent Skill(timesfm-forecasting/ 下),并加入了用 HuggingFace Transformers + PEFT(LoRA)做微调的示例与核心层/配置的单元测试。2026 年 3 月,社区还补上了 AGENTS.md 支持与 SKILL.md,让 TimesFM 能更顺地接进 Agent 工作流。这些迭代说明它是一个在被认真维护、而非一次性发布的模型。
二、TimesFM 3.0 带来了什么
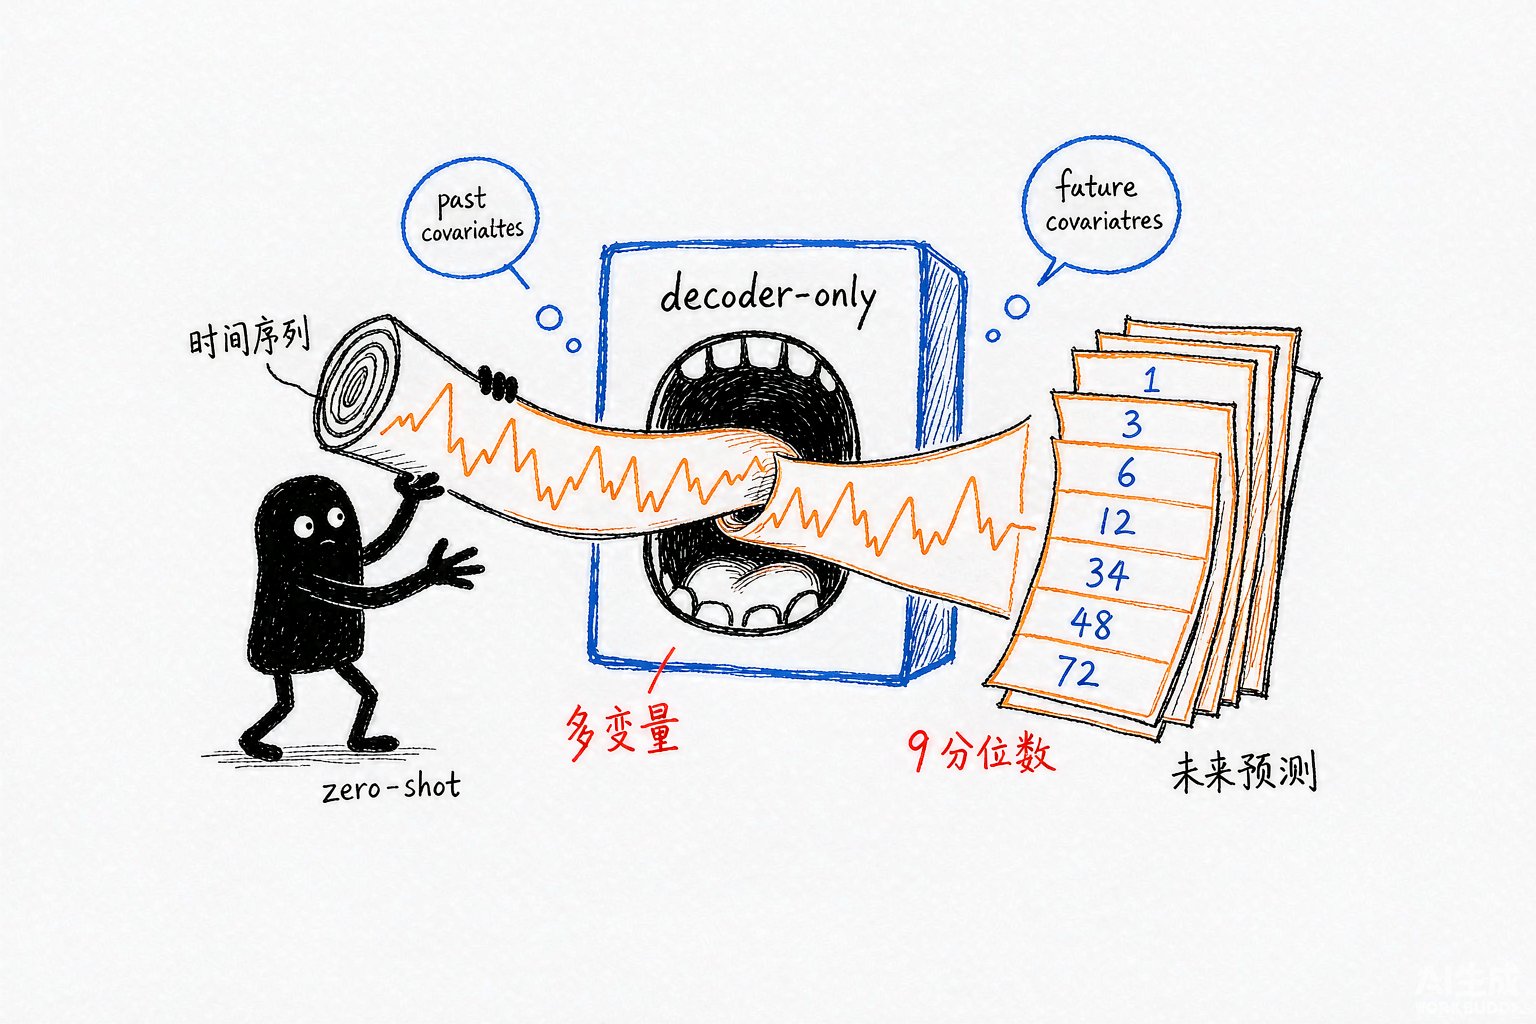
2026 年 8 月的更新宣告 TimesFM 3.0 正式发布。相比 2.5,它最本质的跃迁是从「单变量预测器」变成「原生多变量 + 协变量」的基础模型。README 概括的三大亮点,是理解它价值的钥匙。
(一)原生多变量与协变量
3.0 能无缝预测多通道多变量序列,也能预测单个单变量序列;关键在于它对协变量的支持是「原生」的,覆盖 past-only(只看历史)与 past-and-future(历史加未来已知量)两类协变量,且无需按任务做额外微调。这意味着像「已知未来几天的促销计划」「历史气温」这类外生变量,可以直接喂进去一起建模,而不是靠人工拼特征。
(二)三大基准登顶
在三个主流时间序列基础模型基准上,3.0 都拿到了综合第一:fev-bench 在 100 个真实预测任务上总排名第 1;TIME Benchmark 在 50 个领域数据集、98 个评估任务上总排名第 1;GIFT-Eval 在所有基础模型中排名第 1。这三个基准分别覆盖了多样真实任务、跨领域数据集与面向基础模型的综合评测,能同时在它们身上登顶,说明 3.0 不是只在某类分布上刷分,而是具备真正的 zero-shot 通用能力。配合这点,它在「拿来即用、不必为每个数据集重训」的预测场景里,竞争力相当实在。
三、权重许可的红线
这一节是实际落地前必须看清的。README 用醒目提示写明:本仓库的 TimesFM 源代码以 Apache-2.0 许可,2.5 及之前的模型权重同样为 Apache-2.0;但 TimesFM 3.0 的预训练权重目前以单独的 timesfm-non-commercial-license-v1.0 许可分发,仅限于非商业、非生产用途。也就是说,用默认预训练权重做商业或生产部署,在当前条款下是不被允许的。
这对选型影响很大:如果你要做的是内部研究、教学或非生产实验,3.0 权重可以直接用;但凡涉及线上生产或商业产品,就需要另行评估许可,或者退回到 2.5 及之前的 Apache-2.0 权重。把许可边界写进技术决策,比事后踩雷要划算得多。
四、安装:PyPI 与本地
(一)从 PyPI
最便捷的安装方式是通过 PyPI,按后端选择依赖组:
# 配合 PyTorch 使用
pip install timesfm[torch]

# 在 Apple Silicon 上用 MLX 原生推理(无需 PyTorch)
pip install timesfm[mlx]
注意 MLX 后端是给 Apple Silicon 准备的,它不带 PyTorch,能直接在 Mac 上跑 3.0 推理。
(二)本地可编辑安装
想改源码或做二次开发,可以克隆后用 uv 建虚拟环境并 editable 安装:
git clone https://github.com/google-research/timesfm.git
cd timesfm

uv venv
source .venv/bin/activate
uv pip install -e .[torch]
五、代码实战:从单变量到多变量
(一)单变量预测
3.0 的入口是 timesfm3 包。下面这段用 ModelConfig 载入 3.0 检查点,再对两条长度不同的单变量序列做批量预测,返回点预测与 9 个分位数(0.1 到 0.9):
import numpy as np
from timesfm3 import TimesFM3Evaluator, ModelConfig

config = ModelConfig(
    checkpoint_path="google/timesfm-3.0-pytorch",
    per_core_batch_size=32,
    device="cuda",
)
forecaster = TimesFM3Evaluator(config)

ts1 = np.linspace(0, 1, 100).astype(np.float32)
ts2 = np.sin(np.linspace(0, 24, 72)).astype(np.float32)

outputs = list(forecaster.predict_batch([ts1, ts2], horizon=12,
              return_quantiles=True, use_symmetric_averaging=False))
print(outputs[0].forecast.shape)    # (12,)
print(outputs[0].quantiles.shape)   # (12, 9)
(二)Apple Silicon 的 MLX 后端
MLX 后端镜像了 PyTorch 的 TimesFM3Forecaster 接口(predict / predict_batch,支持单/多变量与两类协变量),并在数值上与该检查点对齐:上下文 512 时,中位预测/分位数最大 abs 误差在 horizon 64 为 9.5e-7 / 1.8e-6。对长 horizon(≥128 会跨多个输出 patch),它仍是单变量与协变量预测路径的 drop-in 替代:
import numpy as np
from timesfm3.mlx import TimesFM3Forecaster

forecaster = TimesFM3Forecaster.from_pretrained("google/timesfm-3.0-pytorch")
context = np.sin(np.linspace(0, 40, 512)).astype(np.float32)
out = forecaster.predict(context, horizon=128, return_quantiles=True)
print(out.forecast.shape)    # (128,)
print(out.quantiles.shape)   # (128, 9)
README 给出的 MLX 基准(330M 模型、Apple M4 Max、上下文 512、horizon 64、fp32 开 mx.compile)显示:batch 1 延迟 11.1 ms、吞吐 90 序列/秒;batch 8 延迟 19.7 ms、吞吐 406 序列/秒;batch 32 延迟 48.1 ms、吞吐 666 序列/秒。可见随着批大小上升,单序列延迟只温和增加、吞吐却近线性增长,说明 MLX 后端很适合一次性批处理大量序列。上下文超过 global_context(15360)会被截断到最近的点,与 PyTorch 后端一致。
(三)多变量与协变量
多变量预测传入形状为 (num_variates, context_length) 的二维数组,并可附上 past-only 与 past-and-future 协变量。README 强调,多变量目标与协变量的用法和 PyTorch 后端完全一致,并在该检查点上对齐到 1.7e-6 的精度。其中 past-only 协变量形状为 (1, context_len),past-and-future 协变量形状为 (channels, context_len + horizon)——后者之所以比上下文更长,是因为它已经提前知道未来时段的外生量(例如未来几天的促销或天气)。
context_len, horizon = 128, 24
target = np.random.randn(3, context_len).astype(np.float32)
past_only = np.random.randn(1, context_len).astype(np.float32)
past_future = np.sin(np.linspace(0, 30, context_len + horizon))[None, :].astype(np.float32)

out = forecaster.predict(
    target,
    horizon=horizon,
    past_only_covariates=past_only,
    past_future_covariates=past_future,
    return_quantiles=True,
)
print(out.forecast.shape)     # (3, 24)
print(out.quantiles.shape)    # (3, 24, 9)
输出是每个目标变量的联合预测,分位数维度为 9,正好对应前面单变量示例里的 9 个分位。
六、能力边界与适用场景
TimesFM 的定位是「预训练好的通用预测器」,强项在 zero-shot:拿到新序列直接预测,不必为每个数据集重训。它已经被 Google 自家的多款产品采用——BigQuery ML 提供企业级 SQL 查询、Google Sheets 接入日常表格、Vertex Model Garden 提供可 Agent 调用的容器化端点——这侧面说明它在生产链路里有真实落地。
但边界也要看清:3.0 默认权重受非商业许可约束,生产/商业用途需另作许可评估;协变量虽是原生支持,复杂外部特征工程与领域适配仍可能带来额外工作;作为基础模型,它在特定窄域、数据分布极特殊的任务上,未必优于针对性训练的专用模型。它更适合「快速拿到合理基线预测」与「多序列批量推理」这类场景,而不是替代全部领域建模。
七、总结
TimesFM 把「时间序列预测」这件事,用基础模型的范式重新做了一遍:预训练一次,zero-shot 预测处处可用。3.0 在原生多变量、协变量支持与三大基准登顶上的进展,让它从研究玩具更接近生产可用——前提是你能接受其权重的非商业许可边界。对需要快速建立预测基线、或在 Apple Silicon / 多后端上批量跑序列的团队,它值得作为首选评估对象之一。
在撰写本文的过程中,我主要参考了 GitHub 仓库 google-research/timesfm 的 README、TimesFM 3.0 更新说明与代码示例,以及其 Google Research 博客。文中数据(Star 数、基准排名、模型参数等)以仓库公开信息为准,可能随版本更新而变化。
本文由 AI 辅助整理,基于 GitHub 项目 google-research/timesfm 的公开文档撰写;配图由后续生成上传。内容仅用于技术介绍,商用与生产部署前请核对 TimesFM 3.0 权重的非商业许可条款。







