
 AI智汇具 - AI工具推荐与技能教程_好用的AI工具大全
MiniMind
🧠 Train a 64M-parameter LLM from scratch in just 2h!——一个从零训练极小语言模型的全程开源复现项目与教程。
Apache-2.0
Python
64M 参数
从 0 训练
MiniMind 是一个完全从零开始、仅用约 3 元成本与 2 小时训练时间就能训出 64M 参数语言模型的开源项目,也是一套面向 LLM 入门与实践的教程。它把极简模型结构(对齐 Qwen3 的 Decoder-Only)与完整训练链路(预训练、SFT、LoRA、蒸馏、RLHF/DPO、RLAIF、Agentic RL)全部从零用 PyTorch 原生实现,覆盖 MoE、Tokenizer 训练、工具调用与自适应思考。本文从项目主张与模型家族、极简结构、完整训练链路、数据组织、快速开始、对外接入、训练开销到协议边界逐层拆解,帮你判断它能否作为亲手训 LLM 的起点。
一、它是什么:从 0 训练一个 64M 语言模型
(一)一句话主张:3 块钱、2 小时、64M
仓库的官方描述是「大道至简」,并用一组极简数字击中了普通开发者的痛点:完全从 0 开始,仅用约 3 元成本与 2 小时训练时间,就能训出规模约 64M 的超小语言模型 MiniMind。项目方特意说明,「2 小时」指 SFT 阶段在单张 NVIDIA 3090 上跑完 1 个 epoch 的实测耗时,「3 块钱」是对应时段的 GPU 租用成本。主线最小版本体积约为 GPT-3 的 1/2700,让普通个人 GPU 也能快速完成训练与复现。
更重要的是它的定位:不是又一个「加载模型做推理」的玩具,而是真正从零训练。所有核心算法代码均从 0 使用 PyTorch 原生实现,不依赖第三方库提供的高层抽象接口。它既是一个大语言模型全阶段开源复现项目,也是一套面向 LLM 入门与实践的教程。
(二)已发布模型家族
MiniMind 已经不是单一模型,而是一族。已发布列表里最新的 minimind-3(64M,2026.04.01)与 minimind-3-moe(198M-A64M)对齐 Qwen3 / Qwen3-MoE 生态;更早还有 minimind2 系列(26M / 104M / 145M)与 minimind-v1 系列(26M / 108M / 4×26M)。此外还拓展出视觉模型 MiniMind-V、多模态 Omni 模型 MiniMind-O、扩散语言模型 MiniMind-dLM 与线性注意力模型 MiniMind-Linear,构成一个围绕「极简可复现」的模型矩阵。
二、极简模型结构:对齐 Qwen3 的 Decoder-Only
(一)主干配置
minimind-3 Dense 采用 Transformer Decoder-Only 结构,整体配置向 Qwen3 生态对齐,方便后续转换到 transformers / llama.cpp / ollama / vllm。具体采用:预标准化(Pre-Norm)+ RMSNorm、SwiGLU 激活、RoPE 旋转位置编码并支持 YaRN 外推,q_heads=8、kv_heads=4、max_position_embeddings=32768、rope_theta=1e6。主线默认 dim=768, n_layers=8,是一种工程取舍:网络更浅训练更快,dim 也不至于过小而导致模式崩溃,在训练效率、稳定性与最终效果间取得均衡。
(二)MoE 扩展与配置取舍
minimind-3-moe 在相同结构上扩展 MoE 前馈层,兼容 Qwen3-MoE 风格配置(去除 shared expert),默认 4 experts / top-1 routing,以更低激活参数获得更高容量。README 也坦诚了一个反直觉事实:MoE 训练时 token 先按专家分桶再分别 forward,原生训练带来的 kernel 启停与调度开销很重,当前实现下这个甜点配置大约只比 dense 慢 50%,因此保留原生 PyTorch 普适性是一种现实折中。
关于「小模型该怎么堆参数」,MiniMind 借用了 MobileLLM 的研究:在参数量固定时,深度往往比宽度更重要——「深而窄」比「宽而浅」更容易学到抽象概念。但「窄」也有下限:当 d_model < 512 时,词嵌入维度过窄的劣势会明显放大;而当 d_model > 1536 时,继续加层往往比继续加宽更划算。这也解释了主线为何选 dim=768, n_layers=8——在训练速度、稳定性与效果间取一个能跑得动、又不太容易模式崩溃的平衡点。
三、极简训练链路:从预训练到 Agentic RL
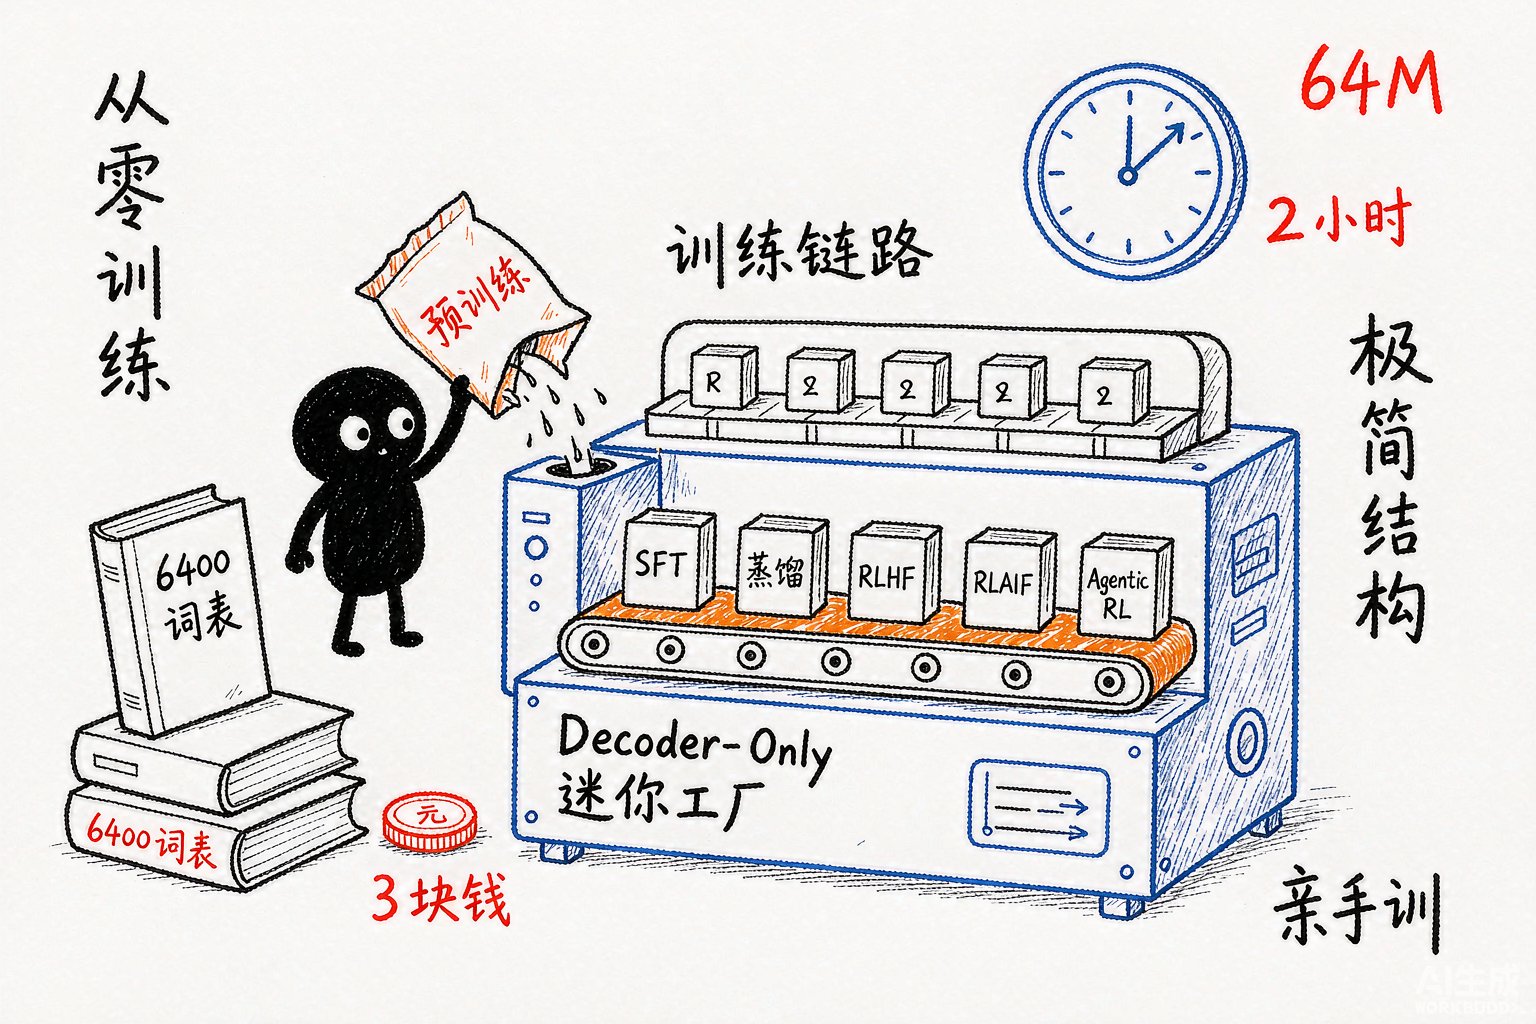
MiniMind 最值得 rookie 学习的地方,是它把大模型的「全阶段训练」摊开成一条清晰的流水线。这条链路不靠黑盒框架,而是每个环节都从 0 实现,你可以逐段打开源码看每一行在做什么。
(一)必须的两步:预训练与 SFT
预训练(Pretrain)让模型先埋头读大量文本,学会「高质量地词语接龙」——输入「秦始皇」,能续出「是中国历史上的第一位皇帝」。这一步通常是无监督的,模型从海量文本里总结语言规律与世界知识。随后是有监督微调(SFT),在高质量、有目标的数据上继续深加工,让模型适应多轮对话、问答、工具调用与思考标签等交互形式。两者对应的脚本分别是 trainer/train_pretrain.py 与 trainer/train_full_sft.py,输出权重落在 out/ 目录。
(二)可选进阶:蒸馏 / LoRA / 工具调用 / 自适应思考
在主线之上,MiniMind 还提供了多条可选路径:知识蒸馏(train_distillation.py,含黑盒与白盒两类,白盒额外拟合教师分布)、LoRA 低秩微调(train_lora.py,纯手写实现)、工具调用与自适应思考(<tool_call> / <think> 模板标记,open_thinking 在推理时动态切换)。当前 sft_t2t 数据已混入 Tool Call 样本,因此通常无需再单独做一轮工具调用监督微调。
(三)强化学习:DPO / RLAIF / GRPO / Agentic RL
后训练的强化学习部分尤为完整:RLHF 用 DPO(train_dpo.py,off-policy,只需 actor 与 ref 两个模型,无需奖励模型);RLAIF 用 PPO / GRPO / CISPO(GRPO 把 loss_type 设为 cispo 即可,单网络架构更稳定);Agentic RL(train_agent.py)则把 RLVR / RLAIF 风格的数据与 online RL 的 rollout 揉在一起,支持多轮 Tool-Use 下的 GRPO / CISPO。README 还把训练侧、轨迹侧与 rollout 侧解耦,实现了模板组织、工具执行、多轮 rollout、延迟奖励与训推分离的最小串联。
但这几条 RL 路径并非「越强越好」,README 也坦诚了各自的坑:PPO 因为 Actor 与 Critic 双网络互相依赖、需要逐步收敛,存在 reward 提升缓慢、显存占用约为单网络 1.5–2 倍的问题;GRPO 虽免去了 critic,却会遇到「退化组」——同一问题生成的 N 个回答奖励几乎一致时,学习信号趋近 0,在超小模型上尤为明显,因此必须限制在不溢出的能力边界内;CISPO 则是把 GRPO 里容易被 clip 成常数的策略项改写成「裁剪权重 × log 概率」,让梯度路径不被截断,本质上可视为 GRPO 的 loss 变体。这些实战经验,恰恰是教科书里不会写的真东西。
四、数据:mini 组合与主线组合
(一)数据集清单
当前主线训练所需核心数据集已开源,放到 ./dataset/ 即可,无需自行预处理大规模语料。关键文件里,带 ✨ 的是推荐必须项:pretrain_t2t_mini.jsonl(1.2GB)、sft_t2t_mini.jsonl(1.6GB)、rlaif.jsonl(24MB);完整主线还会用 pretrain_t2t.jsonl(10GB)、sft_t2t.jsonl(14GB)、dpo.jsonl(53MB)以及 Agentic RL 用的 agent_rl.jsonl(86MB)、agent_rl_math.jsonl(18MB)。想最快从 0 出 Zero 模型,用 mini 组合即可;要完整复现主线则上全量组合。
(二)Tokenizer:6400 词表的取舍
MiniMind 使用自定义的 minimind_tokenizer,词表仅 6400,远小于 Qwen2 的 151643 或 Llama 3 的 128000。项目方解释:更小的词表能显著压缩 embedding 层与输出层的参数占比,更适合小模型的体积约束;虽然编解码效率弱于更偏中文友好的分词器,但实际使用中并未明显带来生僻词解码失败。因此主线统一沿用这套词表,不再分叉维护其它版本。
从压缩比能直观看到代价:这套 tokenizer 在中文文本上大约 1.5–1.7 字符/token,纯英文约 4–5 字符/token,不同数据分布会有波动。也就是说,同样一段话,用 MiniMind 的分词器会比 Qwen2 这类大词表切出更多 token,推理时的 token 数也相应更多——这是小词表为省参数付出的隐性成本,理解它有助于你在设置 max_seq_len 时做出合理权衡。
五、快速开始:最快从 0 跑出 Zero 模型
(一)安装与推理
先从仓库克隆并装依赖(可用阿里云镜像加速):
git clone --depth 1 https://github.com/jingyaogong/minimind
cd minimind && pip install -r requirements.txt -i https://mirrors.aliyun.com/pypi/simple
模型可从 ModelScope 或 HuggingFace 下载,例如 modelscope download –model gongjy/minimind-3 –local_dir ./minimind-3。推理用 python eval_llm.py –load_from ./minimind-3;想看界面可 cd scripts && streamlit run web_demo.py;第三方框架则支持 ollama run jingyaogong/minimind-3 与 vllm serve /path/to/model。
(二)训练与断点续训
训练同样简单:进入 trainer 目录跑 python train_pretrain.py 与 python train_full_sft.py 即可,多卡用 torchrun –nproc_per_node N train_xxx.py。所有脚本都支持检查点续训,加 –from_resume 1 即自动恢复进度,检查点命名形如 full_sft_512_resume.pth,且支持跨不同 GPU 数量恢复、wandb 记录连续性。2025 年 6 月后国内直连 WandB 困难,默认转为接口基本兼容的 SwanLab。
六、把模型接出去:OpenAI 兼容 API 与第三方生态
训好的模型不是孤岛。仓库提供 scripts/serve_openai_api.py,一个兼容 OpenAI API 的轻量聊天服务,便于接入 FastGPT、Open-WebUI、Dify 等第三方 UI,并支持 reasoning_content、tool_calls、open_thinking。同时它也给出向 SGLang、vLLM、llama.cpp、Ollama、MNN 等推理引擎的转换与接入说明,真正把「自己训的小模型」落进可用的工作流。
七、训练开销:到底多便宜
README 用一张表把门槛讲得很实:基于单卡 NVIDIA 3090,minimind-3 的 pretrain_t2t_mini 约 1.21 小时 / 1.57 元,sft_t2t_mini 约 1.10 小时 / 1.43 元,toolcall 约 0.9 小时 / 1.17 元,RLAIF 约 1.1 小时 / 1.43 元。两阶段拼起来,单卡 3090 跑 1 个 epoch 预计约 2.31 小时、成本约 3.0 元,即可从 0 训出 minimind-3 Zero 对话模型。若上 8×H100,总时长还能压到分钟级。需要说明的是,Zero 模型已具备基础对话能力,但事实知识与泛化仍有限,更像是「可行性参考」而非生产模型。
八、协议与适用边界
本项目基于 Apache License 2.0 开源,完全免费。但要留意两层边界:其一,模型权重与训练数据本身可能带有各自协议——README 说明公布版本会确保数据来源与处理链路符合对应开源协议的可传递性约束,并遵守 Apache-2.0、CC-BY-NC-2.0 等相关要求,使用具体数据集时应逐一核对;其二,RL 类后训练更偏向围绕特定奖励目标优化,常会牺牲部分通用能力与知识(reward hacking / capability trade-off 在各类模型上难以避免),因此并非「训得越久越好」,而要在能力边界内合理训练。
MiniMind 代码以 Apache-2.0 发布,但所用预训练数据与部分模型权重可能附带 CC-BY-NC 等非商用条款;用于教学、实验与自研完全可行,若涉及商业产品或对外服务,请先核对数据集与权重的原始许可,避免侵权。
九、总结
MiniMind 的意义不止于「训出一只 64M 的小模型」,更在于它把大语言模型从预训练到 Agentic RL 的全流程,用最朴素、可逐行阅读的方式摊开在你面前。对想真正理解 LLM 内部机制、又苦于算力与门槛的开发者来说,它提供的是一个可复现、可理解、可扩展的起点——用不到 3 块钱的成本,亲手感受从 0 到 1 造一个语言模型的全过程。
在撰写本文的过程中,我主要参考了 GitHub 仓库 jingyaogong/minimind 的 README(项目介绍、快速开始、数据介绍、模型结构、实验、RLAIF/Agentic RL、API 服务与开源协议章节)。文中数据(Star 数、参数量、训练耗时与成本等)以仓库公开信息为准,可能随版本更新而变化。
本文由 AI 辅助整理,基于 GitHub 项目 jingyaogong/minimind 的公开文档撰写;配图由后续生成上传。内容仅用于技术介绍,商用前请核对数据集与权重的原始许可。







