
 AI智汇具 - AI工具推荐与技能教程_好用的AI工具大全
开源免费的 WisprFlow / Granola 替代品——按下热键说话、本地 Whisper 与 Parakeet 离线转写、会议实时说话人分离、笔记与团队空间,macOS / Windows / Linux 全平台。
962 Forks
MIT License
JavaScript / Electron 41
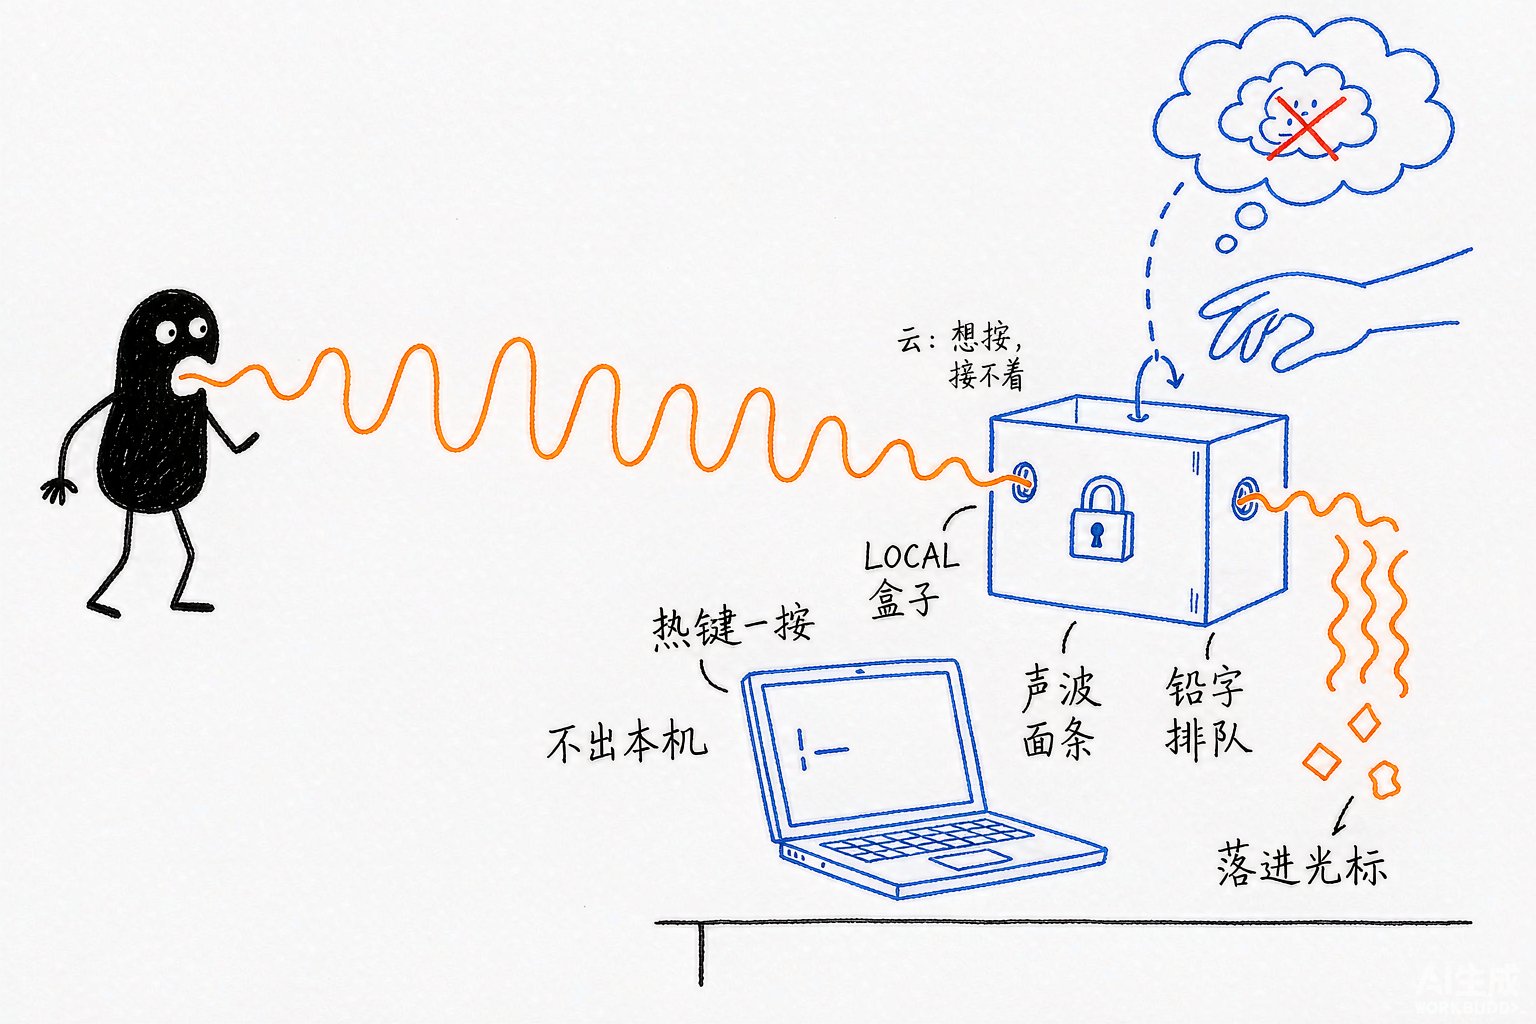
音频不出本机
OpenWhispr 是一个把语音变成文字、笔记与动作的音码输入法:按下全局热键说话,文字直接落在光标处。它的核心取舍是「本地优先」——转写、AI 推理、说话人分离、语义搜索四项能力全部可以在本机用 Whisper 或 NVIDIA Parakeet 完成,音频不出设备;同时也允许接入云端换取速度。本文按仓库 README 的叙事顺序展开:它把自己放在什么位置、四个平台的产物形态、十二条功能清单逐条拆解、本地推理栈是怎么搭起来的、从源码启动需要什么、Intel Mac 上会少掉哪三件事,最后是许可证与致谢清单。
一、把 WisprFlow 和 Granola 的位置腾出来
仓库 README 在正中间那句话没有绕弯子:它是 WisprFlow 和 Granola 的开源且免费的替代品(The open-source and free alternative to WisprFlow and Granola)。这两个名字界定了它的野心边界——前者是语音输入法,后者是会议记录工具,OpenWhispr 想一次占住两个位置。
再往下读一段,README 把工作方式讲得很直白:按下热键、说话、文字出现在光标处。而真正的分岔口在下一句——你可以选择完全私密的离线转写,用 Whisper 或 NVIDIA Parakeet 这类本地语音识别引擎,此时你的音频永远不会离开设备;也可以选择云端处理换取速度。随后是三个短句的承诺:不收集数据、无遥测、完全开源。
值得注意的是它给出的定位不是「语音输入法」,而是「把你的声音变成文字、笔记与动作」(turns your voice into text, notes, and actions)。多出来的「笔记」与「动作」两项,正是它和 WisprFlow 拉开距离的地方:转写只是入口,后面还挂着 AI 助理、会议记录与笔记库。
二、下载矩阵:四个平台,五种产物
README 的 Download 一节是一张四行表格,每行只写一个产物后缀,但对 Linux 格外慷慨。
- macOS(Apple Silicon):.dmg
- macOS(Intel)*:.dmg,带一个星号脚注
- Windows:.exe
- Linux:.AppImage / .deb / .rpm / .tar.gz 四种并行提供
Linux 一口气给四种打包格式,在同类桌面应用里并不多见,基本覆盖了滚动发行版、Debian 系、RPM 系与纯解压即用的全部诉求。所有产物都指向同一个地址:Releases 的 latest 页。
那颗星号后面藏着一段很有信息量的说明,我在第六节单独展开——它牵出了整个项目里唯一一处「平台能力不一致」。仓库的诚实之处在于,这个限制被放在下载表格正下方,而不是埋在文档深处。
三、十二条功能清单,逐条拆
Features 一节列了十二条,每条前面都是加粗的能力名 + 破折号后的具体行为。我按它们解决的其实是四件不同的事,分成四组来读。
(一)听写,以及会翻译的听写
第一条是 Voice dictation:全局热键,向任意应用听写,并自动粘贴。注意「自动粘贴」这个动作——它意味着工具不只是把文字放进剪贴板,而是识别当前光标所在的可写位置并直接填入。
第二条 Dictation translation 是第一条的变体:一个独立的专用热键,用一种语言说,粘贴出来是另一种语言。两个热键分开,说明翻译被当作一等公民而不是听写后的二次加工。
(二)AI 助理热键:没有唤醒词
AI agent 那条列出了一长串可对接对象:GPT-5、Claude、Gemini、Groq、Tinfoil、OpenRouter,以及本地模型,并且是以「具名的语音助理」形式存在。
更值得细看的是 Voice Assistant hotkey 这一条,README 给的细节最多:专用热键把你说的东西直接当作命令发给 AI 助理,既不需要唤醒词,也不做一遍「清理润色」的中间处理(no cleanup pass);选中的文字会被就地编辑。开着自动粘贴时,回答会粘贴到获得焦点的文本光标处,或者在无法找到可写光标时流式输出到浮动面板并复制到剪贴板。还有一个可选项:把当前屏幕截图一并作为上下文发送。
(三)会议转写与本地说话人分离
Meeting transcription 这一条的关键词是「自动检测」:自动识别 Zoom、Teams、FaceTime 通话,配合实时说话人分离(live speaker diarization)、声纹识别,以及 Google、Microsoft、Apple 三家日历的集成。
紧跟着的 Local speaker diarization 是它的底气所在:设备端完成说话人标注,跨会议复用声纹识别结果,不需要云端。这两条是并列列出的,说明「会议转写」这个能力可以被拆开用——你完全可以只要本地那部分。
(四)Notes、团队空间与音频导入
Notes 一条里塞了四个子能力:创建、整理、搜索,以及文件夹、语义搜索、云同步与 AI 动作。Team spaces & sharing 对登录用户免费:笔记可以用链接、域名或仅邀请三种可见度分享到网页上,团队空间里还有角色、邀请与服务端强制的成员身份校验。
Audio import 把既有素材也纳入进来:拖入文件、批量上传,或者直接粘贴 YouTube / 音频链接,可选说话人检测。这让它的适用范围从「正在说的话」扩展到了「已经录下的东西」。
剩下两条是横向能力。Local or cloud — your choice 明确点名四项核心能力(转写、AI 推理、说话人分离、语义搜索)都可以在本地模型或云端供应商之间二选一,并且本地 Whisper 支持 Metal、CUDA、Vulkan(AMD / Intel) 的 GPU 加速。Enterprise controls 则面向组织:统一执行策略、公司 SSO 与 SCIM、集中管理 Amazon Bedrock 或 Azure OpenAI 接入而无需下发云端密钥。最后 Public API & MCP 一条把笔记与转写开放成可编程接口,也提供 MCP server 让你的 AI 助理反过来连进来。
四、本地优先是怎么落地的
项目的技术栈在 README 里是一行清单:React 19, TypeScript, Tailwind CSS v4, Electron 41, better-sqlite3, whisper.cpp, sherpa-onnx, shadcn/ui。
这里面有两个名字决定了「本地优先」这句话能不能兑现。whisper.cpp 是 ggerganov 的高性能 C++ 实现,负责本地 Whisper 推理;sherpa-onnx 是跨平台的 ONNX 运行时,专门用来跑 NVIDIA Parakeet——README 的致谢部分给出了具体模型标识 parakeet-tdt-0.6b-v3,一个支持多语种的快速 ASR 模型,权重托管在 Hugging Face。剩下的 llama.cpp 负责本地 LLM 推理(AI 文本处理),better-sqlite3 承担本地结构化存储。
把这条链路摊开看:麦克风 → whisper.cpp 或 sherpa-onnx 出文本 → 可选 llama.cpp 做本地文本加工 → better-sqlite3 落库 → Electron 界面呈现。除了模型权重需要从 Hugging Face 拉取一次,整条链路上没有一个环节必须联网。这就是为什么 README 敢写「音频永不离开设备」。
仓库里还有一个 Custom ASR shim 示例,用于对接非 OpenAI 兼容的 ASR API 做自托管转写——这条是给想换掉默认引擎的人准备的口子。
五、从源码跑起来
Quick start 只有四条命令,但后面那句要求不能漏:需要 Node.js 24+。
git clone https://github.com/OpenWhispr/openwhispr.git
cd openwhispr
npm install
npm run dev
Node 24 这个下限在 Electron 41 的语境下是合理的,但确实会拦住一批还停在 20.x 的开发者。完整文档站 docs.openwhispr.com 分了五块:快速开始、平台指南(macOS / Windows / Linux)、API 参考、MCP server 设置与故障排查。想贡献代码的话,README 的 Contributing 一节说得很常规:fork、开特性分支、提 PR,细节见 contributing 指南。
从仓库元数据看,这个项目 2025 年 6 月 19 日创建,主语言是 JavaScript,当前 7,865 Stars、962 Forks、333 个开放 Issue。开放 Issue 数量偏高,说明它正处在一个功能快速扩张、问题也同步堆积的阶段——其中相当大的一部分大概率来自「五变体」式的功能组合矩阵。
六、Intel Mac 上缺失的那三件事
回到下载表格那颗星号。README 的原文是:在 Intel Mac 上,实时说话人识别与声纹识别不可用,因为它们依赖 ONNX Runtime,而后者自 1.24 版本起停止发布 macOS x86_64 二进制。
这句话的连锁反应有三层,README 也一并交代了:
- 实时说话人识别:不可用
- 声纹识别:不可用
- 笔记搜索:从语义搜索回退到关键词匹配
但会议本身照常录制与转写(Meetings still record and transcribe normally)。也就是说 Intel Mac 用户丢的是「谁在说」和「语义检索」,核心的「说了什么」仍然完整。这是一个由上游依赖的架构决策传导下来的限制,不是 OpenWhispr 自己的取舍——把原因和后果都写在下载按钮旁边,比让用户装完再发现要体面得多。
七、MIT、赞助与致谢清单
License 一节只有一行:MIT —— 免费用于个人与商业用途(free for personal and commercial use)。商业友好的许可证配上「无遥测、不收集数据」,是它能被放到企业环境里的前提。
Sponsors 一节点名了 Neon,README 的表述是「Neon 是为 OpenWhispr Cloud 提供支持的 serverless Postgres 平台」。这解释了为什么笔记能跨设备云同步——云端部分的数据落在 Neon 上,而本地部分完全不依赖它。
Acknowledgments 是一份十条的清单,读下来基本就是这张技术地图:OpenAI Whisper(识别模型)、whisper.cpp(本地高性能实现)、NVIDIA Parakeet(多语种快速 ASR)、sherpa-onnx(ONNX 推理)、Hugging Face(权重托管)、llama.cpp(本地 LLM 推理)、Electron(跨平台桌面框架)、React(UI)、shadcn/ui(基于 Radix 的无障碍组件)、Neon(云端 Postgres)。
八、写在最后
OpenWhispr 真正值得留意的地方,不在于它又做了一个语音输入工具,而在于它把「隐私优先」写成了可切换的架构而不是一句口号:转写、AI 推理、说话人分离、语义搜索四项能力,每一项都同时提供本地与云端两套实现,用户按场景选。这种设计比「我们很重视隐私」的宣传成本高得多——你要同时维护 whisper.cpp 与 sherpa-onnx 两条推理链路,还要接受在 Intel Mac 上因为上游 ONNX Runtime 停供而少掉两个功能。
它也没有回避商业化:Notes 云同步、团队空间、企业 SSO / SCIM 与集中式密钥管理,都指向一个开源核心加云端增量的结构。对一个 MIT 许可、7,865 Stars 的项目来说,这是一条相当清晰的路。
本文仅作技术介绍。使用语音转写与会议录制功能前,请确认你所在地区关于录音与知情同意的法律要求,并在会议场景中取得参与者的明确许可;涉及企业数据时,请先确认本地 / 云端模式的选择符合所在组织的合规策略。文中 Stars、Forks 等数据截至仓库公开信息,可能随版本更新而变化。
在撰写本文的过程中,我主要参考了以下来源:GitHub 仓库 OpenWhispr/openwhispr 的 README(Download / Features / Quick start / Tech stack / License / Acknowledgments 各节)、项目官网 openwhispr.com 与文档站 docs.openwhispr.com,以及仓库 meta 数据。文中数值以官方公开信息为准,可能随版本更新而变化。
本文由 AI 辅助整理,基于 GitHub 项目 OpenWhispr/openwhispr 的公开文档撰写;配图为独立绘制的示意图,非项目官方素材。内容仅用于技术介绍,不构成对任何产品或服务的推荐。







